★ 89 зірок на GitHub, і їхня кількість продовжує зростати. Yozh Crawler + Scraper — це безкоштовний проект з відкритим кодом, який розробляється відкрито. Поставте нам зірку, якщо він заслуговує на місце у вашому стеку.
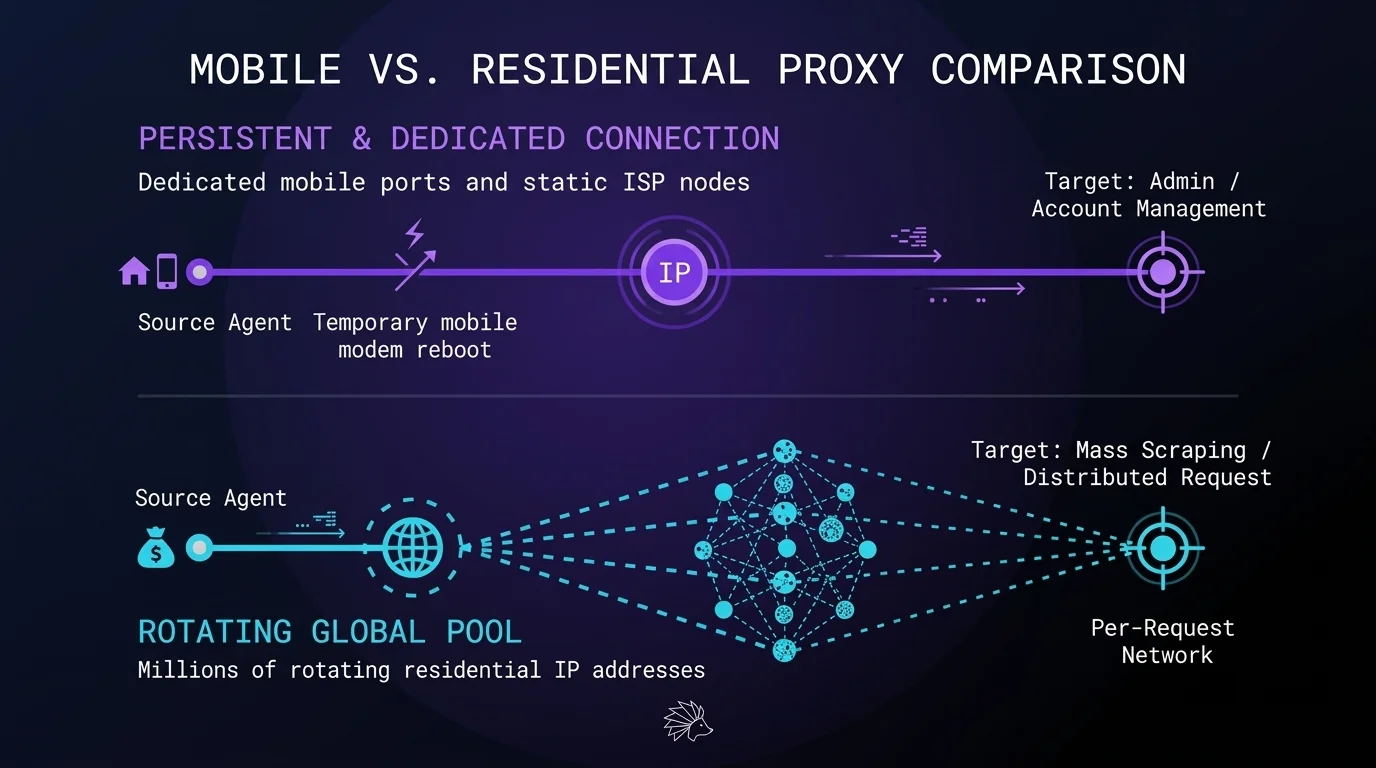
Мобільні чи резидентські проксі: що обрати для збору даних
3 Час читання
RO Roman on24 Вересня, 2026

Мобільні чи резидентські проксі: що обрати для збору даних

Вибір проксі для парсингу сайтів насамперед визначає архітектуру проєкту. Сучасні алгоритми перевіряють не лише заголовки User-Agent, а й транспортний рівень з’єднання. Проксі датацентру забезпечують відмінну пропускну спроможність для відкритих платформ, однак високозахищені мережі вимагають інших інфраструктурних рішень. Інженери порівнюють мобільні проксі та резидентські проксі, щоб підібрати оптимальні IP-адреси, що відповідають природному користувацькому трафіку. TL;DR: Основи […]
Roman on23 Вересня, 2026

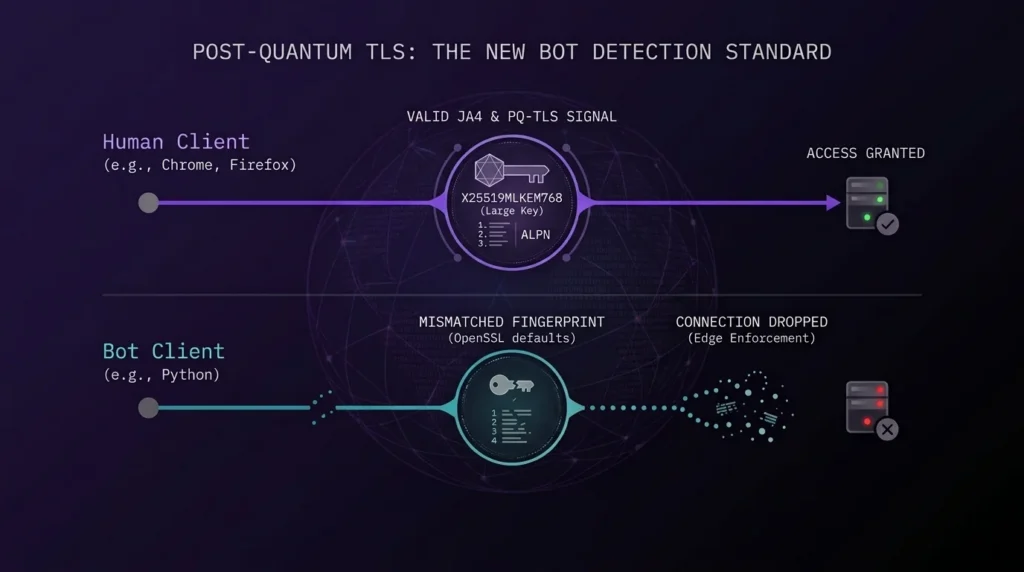
Налаштування JA4 та TLS-відбитків для стабільного збору даних

Мережеві фільтри давно перестали довіряти файлам cookie і заголовкам User-Agent. Сьогодні системи захисту оцінюють…

Налаштування JA4 та TLS-відбитків для стабільного збору даних 3 Час читання
Roman on10 Вересня, 2026

Масштабування RAG-систем: очищення DOM-дерева та правильні MCP проксі для парсингу

Сучасні цільові сайти безжально відсіюють автоматизовані запити. Ви запускаєте краулер для збору даних із…

3 Час читання
Roman on7 Вересня, 2026

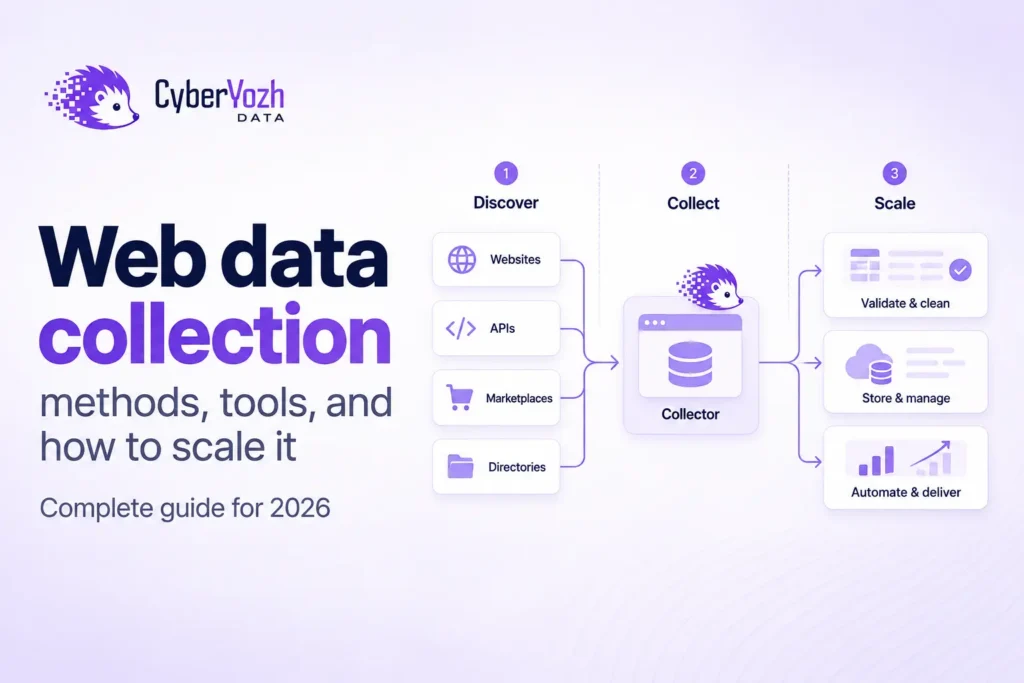
Збір даних із вебу у 2026 році: методи, інструменти та масштабування

Дізнайтеся, як працює збір даних з вебсайтів, які методи підходять для різних сайтів, які…

Збір даних із вебу у 2026 році: методи, інструменти та масштабування 3 Час читання
Мобільні чи резидентські проксі: що обрати для збору даних
3 Час читання
RO Roman on24 Вересня, 2026

Мобільні чи резидентські проксі: що обрати для збору даних

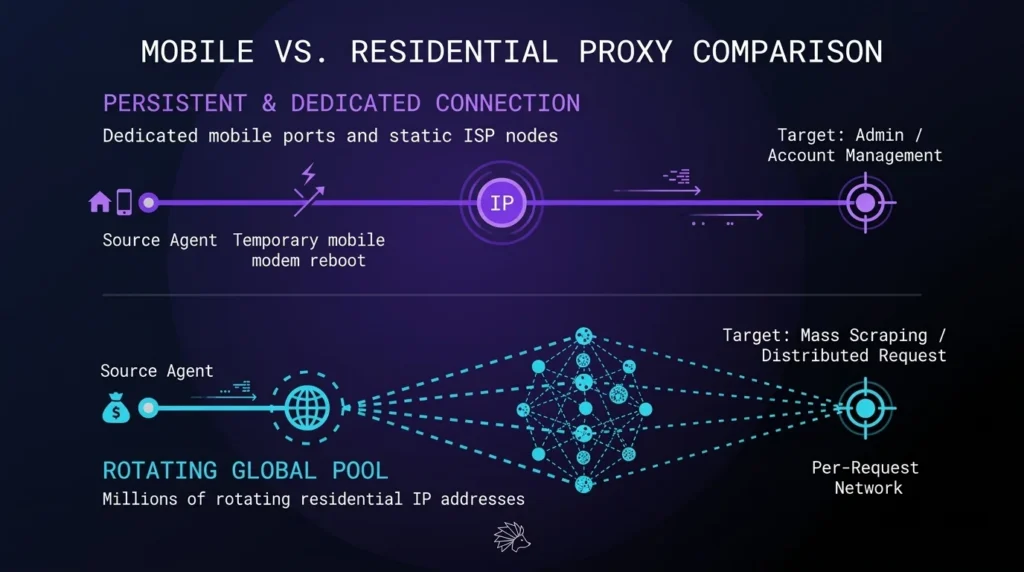
Вибір проксі для парсингу сайтів насамперед визначає архітектуру проєкту. Сучасні алгоритми перевіряють не лише заголовки User-Agent, а й транспортний рівень з’єднання. Проксі датацентру забезпечують відмінну пропускну спроможність для відкритих платформ, однак високозахищені мережі вимагають інших інфраструктурних рішень. Інженери порівнюють мобільні проксі та резидентські проксі, щоб підібрати оптимальні IP-адреси, що відповідають природному користувацькому трафіку. TL;DR: Основи […]
Дізнатися більше
Налаштування JA4 та TLS-відбитків для стабільного збору даних
3 Час читання
RO Roman on23 Вересня, 2026

Налаштування JA4 та TLS-відбитків для стабільного збору даних

Мережеві фільтри давно перестали довіряти файлам cookie і заголовкам User-Agent. Сьогодні системи захисту оцінюють сам процес встановлення з’єднання, аналізуючи кожен байт ще до отримання HTTP-запиту. Якщо ви використовуєте стандартні бібліотеки на кшталт Python requests, сервер миттєво скидає з’єднання або видає помилку 403. Стабільне отримання даних тепер повністю залежить від правильної генерації мережевих пакетів на рівні […]

Дізнатися більше
RO Roman on10 Вересня, 2026

Масштабування RAG-систем: очищення DOM-дерева та правильні MCP проксі для парсингу

Сучасні цільові сайти безжально відсіюють автоматизовані запити. Ви запускаєте краулер для збору даних із товарного каталогу. Система захисту миттєво сканує ваш TLS-відбиток. Вона перевіряє порядок слідування службових фреймів HTTP/2 ще до початку завантаження контенту. Серверні адреси дають відмінну швидкість для відкритих API. Однак агресивні системи захисту споживчих маркетплейсів часто блокують саме такі з’єднання. Проходження первинного […]

Дізнатися більше
Збір даних із вебу у 2026 році: методи, інструменти та масштабування
3 Час читання
RO Roman on7 Вересня, 2026

Збір даних із вебу у 2026 році: методи, інструменти та масштабування

Дізнайтеся, як працює збір даних з вебсайтів, які методи підходять для різних сайтів, які інструменти потрібні та як автоматизувати надійний збір даних у великих масштабах.

Дізнатися більше
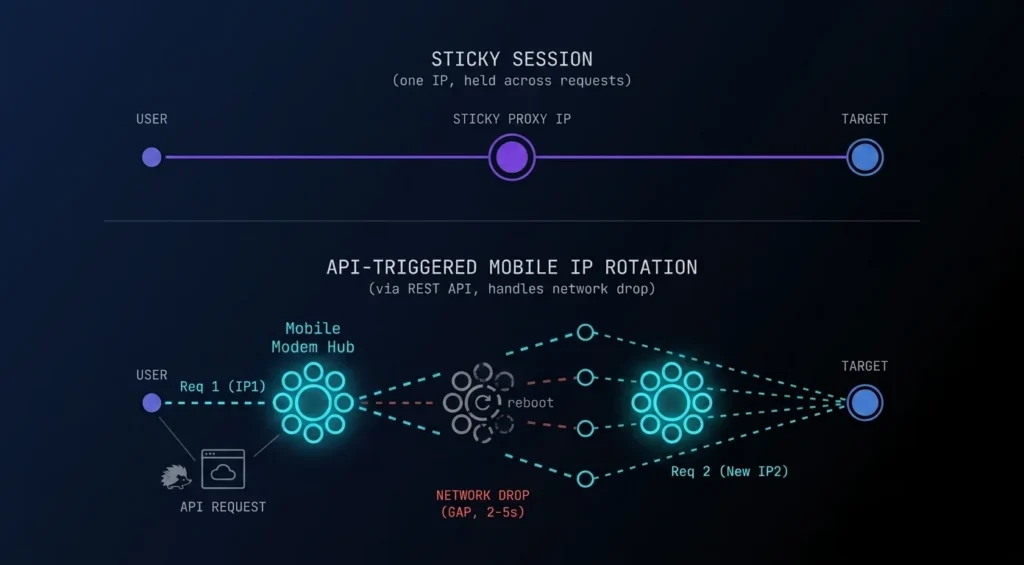
Автоматизований скрейпинг з Python: обробка ротації мобільних IP через REST API
3 Час читання
RO Roman on4 Вересня, 2026

Автоматизований скрейпинг з Python: обробка ротації мобільних IP через REST API

TL;DR: Відмова від важких браузерів Браузерна автоматизація несе колосальні обчислювальні витрати. Безголові браузери потребують гігабайтів оперативної пам’яті. Вони рендерять непотрібні елементи DOM-дерева. Вони викликають пікові навантаження на процесор при виконанні простих завдань зі збору даних. Дата-інженери рано чи пізно стикаються з жорсткими апаратними лімітами, намагаючись запустити сотні інстансів Selenium або Playwright. Перенесення логіки в скрипти […]

Дізнатися більше
RO Roman on19 Серпня, 2026

Підводні камені під час скрейпингу: Playwright проти Puppeteer і чому ротація IP розв’язує все

Коли команди вибирають, що використовувати: Playwright чи Puppeteer для парсингу, вони часто зосереджуються на синтаксисі та швидкості виконання коду. Але ландшафт збору даних кардинально змінився. Цільові веб-сайти застосовують агресивний поведінковий аналіз, перевірку TLS-відбитків і динамічні мутації DOM-дерева. Щоб ваш конвеєр вижив у таких умовах, самого лише фреймворка недостатньо. TL;DR: Playwright чи Puppeteer для парсингу E-commerce […]

Дізнатися більше