88 sao trên GitHub và con số này vẫn đang tiếp tục tăng. Yozh Crawler + Scraper là phần mềm miễn phí, mã nguồn mở và được phát triển công khai — hãy nhấn sao cho chúng tôi nếu công cụ này xứng đáng có một vị trí trong hệ thống công nghệ của bạn.
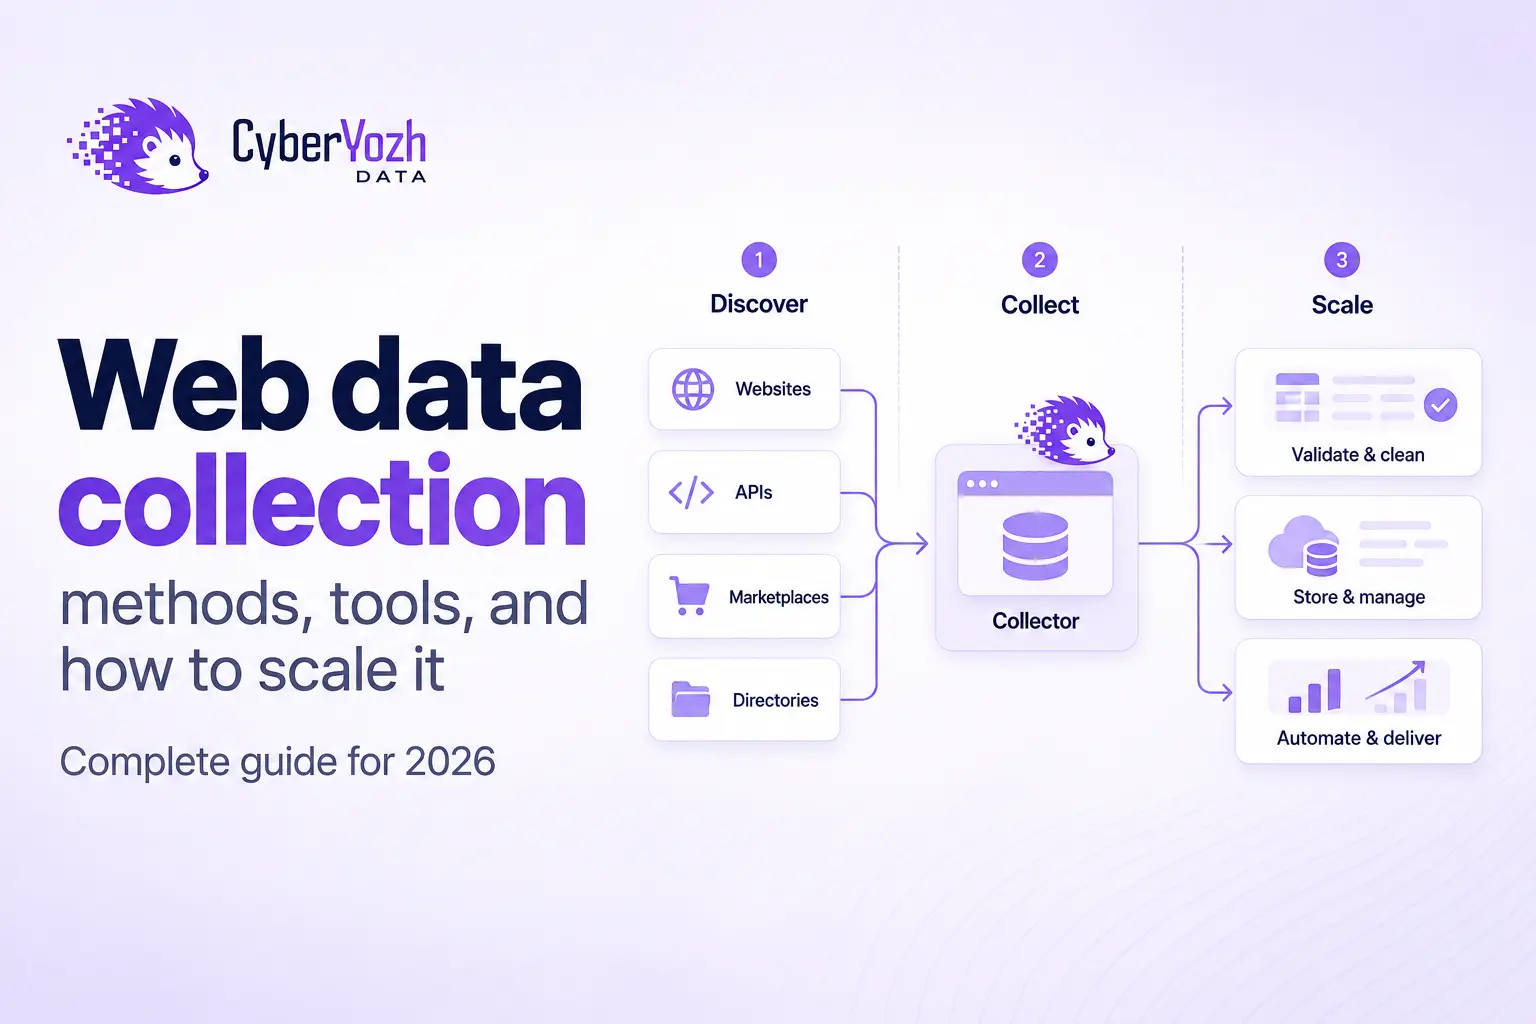
Thu thập dữ liệu web năm 2026: Phương pháp, công cụ và cách mở rộng quy mô
24 Thời gian đọc ước tính
RO Roman onTháng 9 7, 2026

Thu thập dữ liệu web năm 2026: Phương pháp, công cụ và cách mở rộng quy mô

Tìm hiểu cách thu thập dữ liệu web hoạt động, phương pháp nào phù hợp với từng loại website, những công cụ bạn cần, và cách tự động hóa việc thu thập dữ liệu đáng tin cậy ở quy mô lớn.
Roman onTháng 9 4, 2026

Tự động hóa Web Scraping với Python: Xử lý Xoay vòng IP Di động qua các Yêu cầu REST API

Tóm tắt nhanh: Vượt qua nút thắt cổ chai của trình duyệt Tự động…

Tự động hóa Web Scraping với Python: Xử lý Xoay vòng IP Di động qua các Yêu cầu REST API 18 Thời gian đọc ước tính
Roman onTháng 9 3, 2026

Sự phát triển hạ tầng mạng 2026: Từ SOCKS5 cơ bản đến mạng VLESS di động, XHTTP và XTLS-Reality

Giao thức SOCKS5 vẫn là một tiêu chuẩn ngành đáng tin cậy. Nó hoạt…

19 Thời gian đọc ước tính
Roman onTháng 8 26, 2026

Kết nối các Tác nhân AI với Web: Tỷ lệ thành công 99,8% với Máy chủ MCP & Proxy (2026)

Trả lời nhanh: Model Context Protocol (MCP) đóng vai trò như một cầu nối…

12 Thời gian đọc ước tính
RO Roman onTháng 8 19, 2026

Playwright so với Puppeteer khi Scraping E-commerce: Vì sao Xoay IP Thông Minh là Yếu Tố Khác Biệt Quyết Định

Khi đánh giá Playwright so với Puppeteer cho việc scraping e-commerce, các kỹ sư thường ám ảnh với tốc độ thực thi và cú pháp API. Tuy nhiên, vào năm 2026, bối cảnh trích xuất dữ liệu đã thay đổi căn bản. Các website mục tiêu triển khai phân tích hành vi mạnh mẽ, TLS […]

Khám phá thêm
Web scraping cho lead generation: Hướng dẫn đầy đủ cho năm 2026
33 Thời gian đọc ước tính
RO Roman onTháng 8 14, 2026

Web scraping cho lead generation: Hướng dẫn đầy đủ cho năm 2026

Một hướng dẫn thực tế để xây dựng quy trình scraping web tạo khách hàng tiềm năng đáng tin cậy, từ việc tìm dữ liệu doanh nghiệp công khai đến crawling, trích xuất, xác thực, lựa chọn proxy và đầu ra sẵn sàng cho CRM.

Khám phá thêm
Các công cụ và kỹ thuật thu thập dữ liệu xếp hạng sản phẩm Amazon tốt nhất cho năm 2026
44 Thời gian đọc ước tính
RO Roman onTháng 8 14, 2026

Các công cụ và kỹ thuật thu thập dữ liệu xếp hạng sản phẩm Amazon tốt nhất cho năm 2026

Hướng dẫn thực tế để thu thập xếp hạng tìm kiếm, Best Sellers Rank, đánh giá, giá cả và dữ liệu đối thủ cạnh tranh trên Amazon bằng CyberYozh Data trong khi vẫn giữ nguyên ngữ cảnh về marketplace, vị trí, dấu thời gian và xếp hạng.

Khám phá thêm
RO Roman onTháng 8 14, 2026

Pipeline Scraping Bền Vững: Giới Thiệu Tính Năng Tự Sửa Lỗi Phân Tích Bằng LLM Trong Yozh Scraper

Trích xuất dữ liệu là nền tảng cốt lõi của phát triển trí tuệ nhân tạo hiện đại, phân tích thị trường và phân tích cạnh tranh. Tuy nhiên, việc xây dựng các pipeline dữ liệu đáng tin cậy vẫn là một nút thắt kỹ thuật. Các trang web mục tiêu liên tục triển khai […]

Khám phá thêm
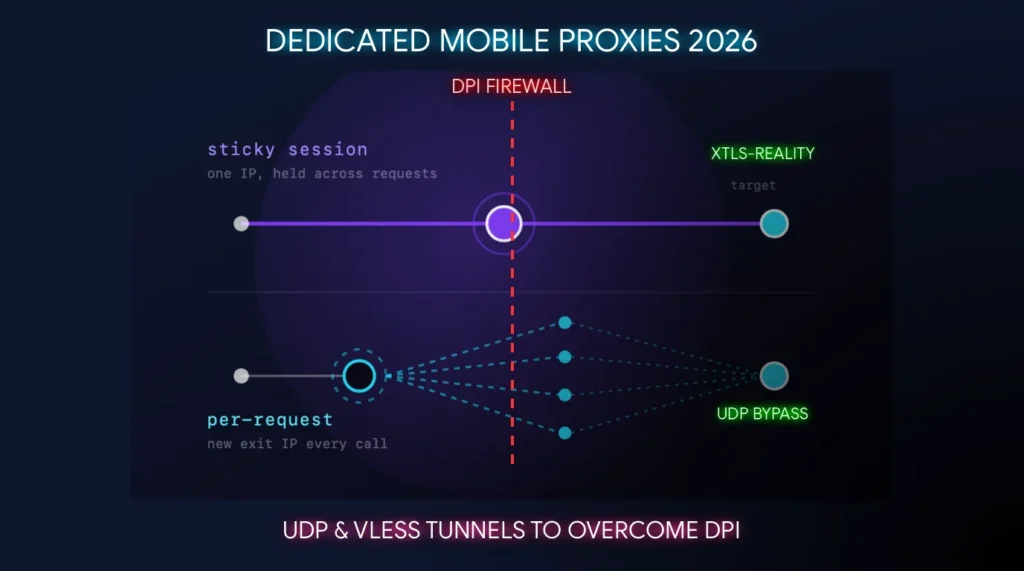
Proxy di động riêng năm 2026: Vì sao cần đường hầm UDP và VLESS để vượt qua DPI
26 Thời gian đọc ước tính
RO Roman onTháng 8 7, 2026

Proxy di động riêng năm 2026: Vì sao cần đường hầm UDP và VLESS để vượt qua DPI

Các hệ thống kiểm tra sâu gói tin (DPI) chủ động quét và chặn các kết nối VPN tiêu chuẩn. OpenVPN và WireGuard thất bại chỉ trong vài phút. Bởi vì chúng dựa vào các tiêu đề tĩnh. Các tường lửa thương mại hiện nay phân tích entropy byte và thời gian gói tin bằng […]

Khám phá thêm
Giải pháp thay thế Instant Data Scraper tốt nhất năm 2026
31 Thời gian đọc ước tính
RO Roman onTháng 8 6, 2026

Giải pháp thay thế Instant Data Scraper tốt nhất năm 2026

So sánh Instant Data Scraper với CyberYozh và tìm hiểu khi nào các trình crawler có thể mở rộng, xoay proxy, nhắm mục tiêu theo địa lý, session và tự động hóa trở nên cần thiết.

Khám phá thêm