★ 88 estrelas no GitHub e a contagem continua. O Yozh Crawler + Scraper é gratuito, de código aberto e desenvolvido publicamente — dá-nos uma estrela se ele merecer o seu lugar na tua pilha de ferramentas.
Playwright vs Camoufox: O Futuro da Automação de Navegadores Anti-Detecção
8 Tempo estimado de leitura
RO Roman onOutubro 1, 2026

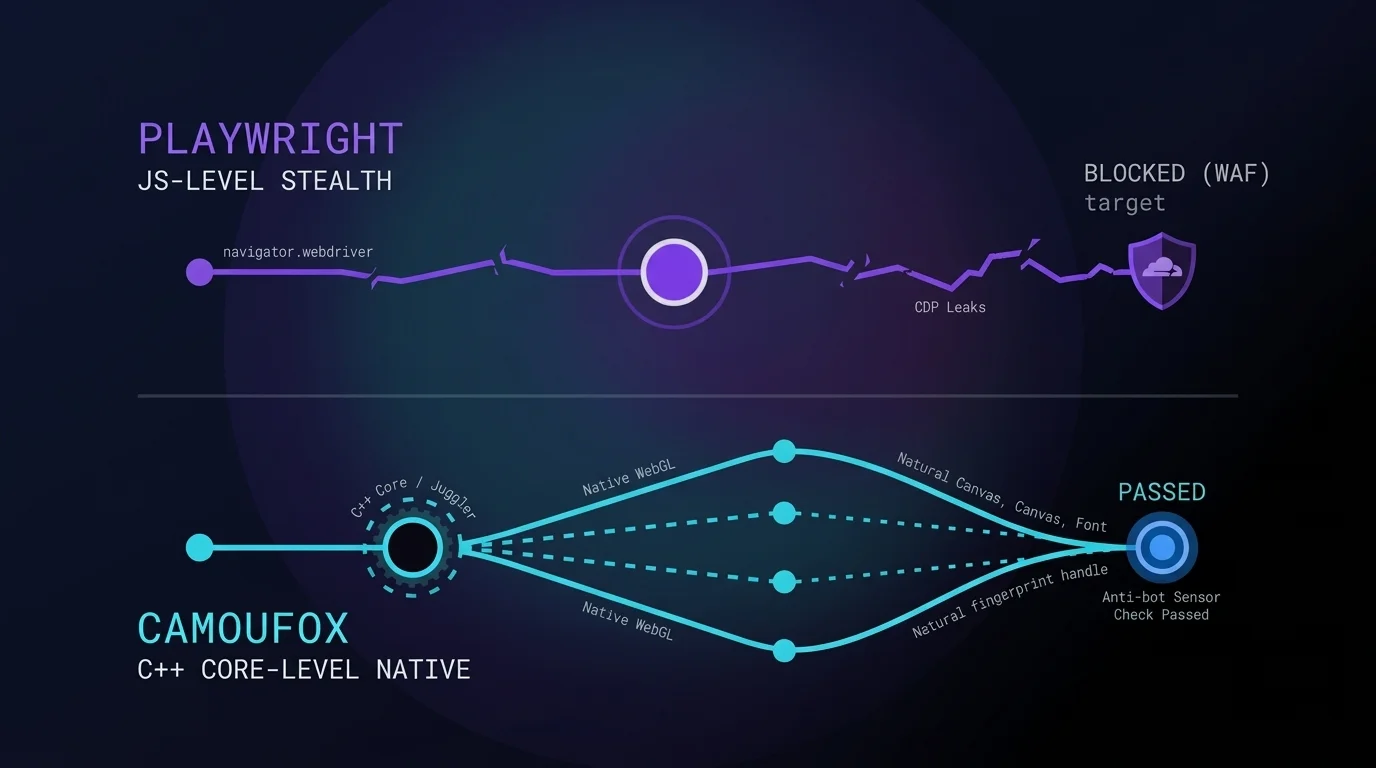
Playwright vs Camoufox: O Futuro da Automação de Navegadores Anti-Detecção

A segurança da extração de dados mudou. Em 2026, Cloudflare e DataDome não dependem da análise básica de user-agent. Essas plataformas avaliam a biometria comportamental junto com a impressão digital TLS estrutural (JA4). Os algoritmos de defesa também investigam o ambiente em busca de adulteração de JavaScript. Os patches tradicionais de JavaScript falham. Os engenheiros […]
Roman onSetembro 24, 2026

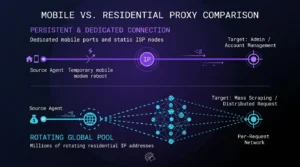
Proxies Móveis vs. Residenciais: Qual Tipo de IP Vence na Extração de Dados

Selecionar a infraestrutura de IP ideal molda diretamente a arquitetura do seu projeto. Escrever…

Proxies Móveis vs. Residenciais: Qual Tipo de IP Vence na Extração de Dados 13 Tempo estimado de leitura
Roman onSetembro 23, 2026

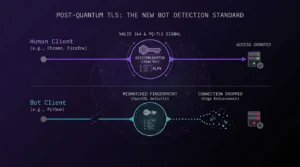
TLS Pós-Quântico: O Novo Padrão de Detecção de Bots

As redes de entrega de conteúdo agora avaliam o handshake criptográfico em vez de…

TLS Pós-Quântico: O Novo Padrão de Detecção de Bots 9 Tempo estimado de leitura
Roman onSetembro 10, 2026

Alimentando Sistemas RAG em Escala: Como Eliminar Ruído do DOM e Rotacionar Proxies para uma Ingestão Limpa em LLM

Direcionar sites modernos para treinar modelos de IA quebra os pipelines tradicionais de extração…

8 Tempo estimado de leitura
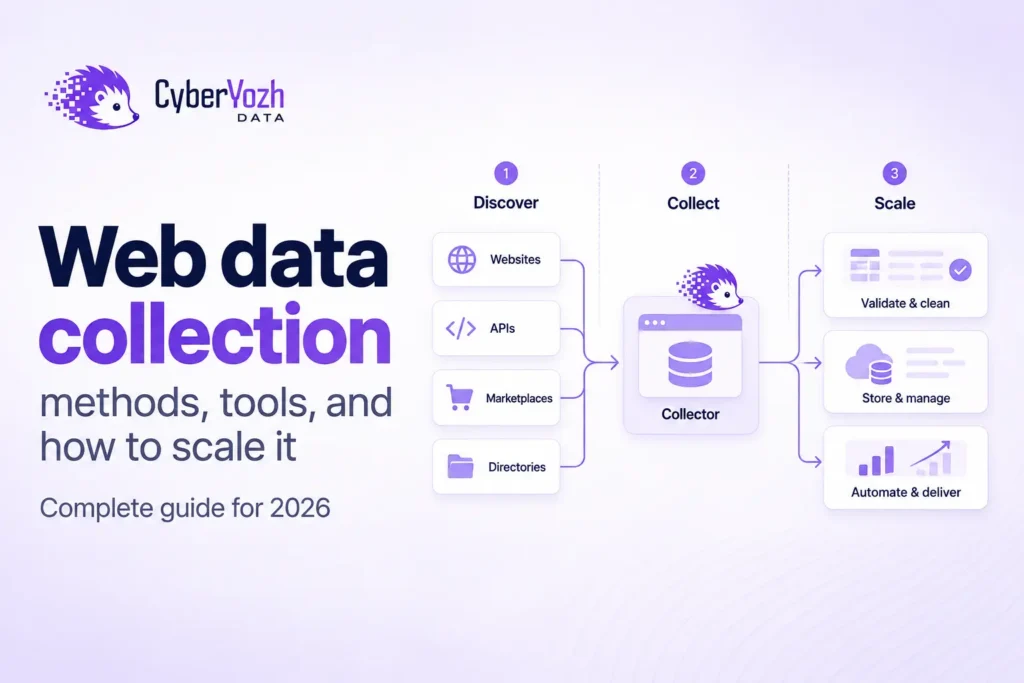
Coleta de dados da web em 2026: Métodos, ferramentas e como escalar o processo
13 Tempo estimado de leitura
RO Roman onSetembro 7, 2026

Coleta de dados da web em 2026: Métodos, ferramentas e como escalar o processo

Saiba como funciona a coleta de dados na web, quais métodos se adequam a diferentes sites, quais ferramentas você precisa e como automatizar uma coleta confiável em larga escala.

Descubra mais
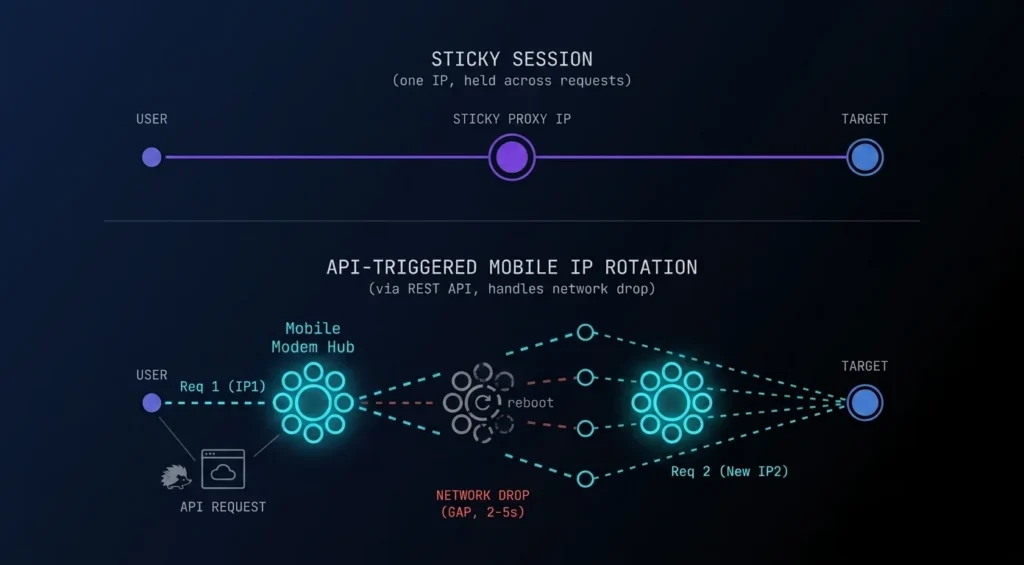
Web Scraping Automatizado com Python: Gerenciando a Rotação de IP Móvel via Requisições de API REST
10 Tempo estimado de leitura
RO Roman onSetembro 4, 2026

Web Scraping Automatizado com Python: Gerenciando a Rotação de IP Móvel via Requisições de API REST

TL;DR: Superando os gargalos do navegador A automação de navegadores acarreta uma sobrecarga computacional massiva. Navegadores headless consomem gigabytes de RAM. Eles renderizam elementos DOM desnecessários. Eles causam picos no uso de CPU durante tarefas simples de extração de dados. Engenheiros de dados eventualmente atingem limites rígidos de escalabilidade ao executar centenas de instâncias do […]

Descubra mais
10 Tempo estimado de leitura
RO Roman onSetembro 3, 2026

Evolução da Infraestrutura de Rede 2026: De SOCKS5 Básico a Redes Móveis VLESS, XHTTP e XTLS-Reality

O protocolo SOCKS5 continua sendo um padrão confiável da indústria. Funciona perfeitamente em redes corporativas confiáveis. Contudo, sob filtragem DPI rigorosa de provedores de internet locais, o SOCKS5 puro se torna vulnerável. Sistemas de monitoramento reconhecem suas assinaturas. As conexões caem. As empresas perdem receita. Engenheiros de dados precisam de camadas adicionais de segurança. A […]

Descubra mais
7 Tempo estimado de leitura
RO Roman onAgosto 26, 2026

Conectando Agentes de IA à Web: 99,8% de Sucesso com Servidores MCP e Proxies (2026)

Resposta rápida: O Model Context Protocol (MCP) atua como uma ponte universal, permitindo que agentes de IA (como Claude Desktop ou Cursor) naveguem pela web ao vivo, renderizem JavaScript e extraiam dados estruturados. No entanto, para evitar banimentos de IP e CAPTCHAs durante o crawling automatizado da web, os agentes de IA precisam rotear suas […]

Descubra mais
8 Tempo estimado de leitura
RO Roman onAgosto 19, 2026

Playwright vs. Puppeteer para Scraping de E-commerce: Por que a Rotação Inteligente de IP é o Diferencial Definitivo

Ao avaliar Playwright vs Puppeteer para scraping de e-commerce, os engenheiros costumam se concentrar obsessivamente na velocidade de execução e na sintaxe da API. Porém, em 2026, o cenário da extração de dados mudou fundamentalmente. Os sites-alvo implementam análise comportamental agressiva, TLS fingerprinting e mutações dinâmicas do DOM. Construir um pipeline que resista a essas […]

Descubra mais
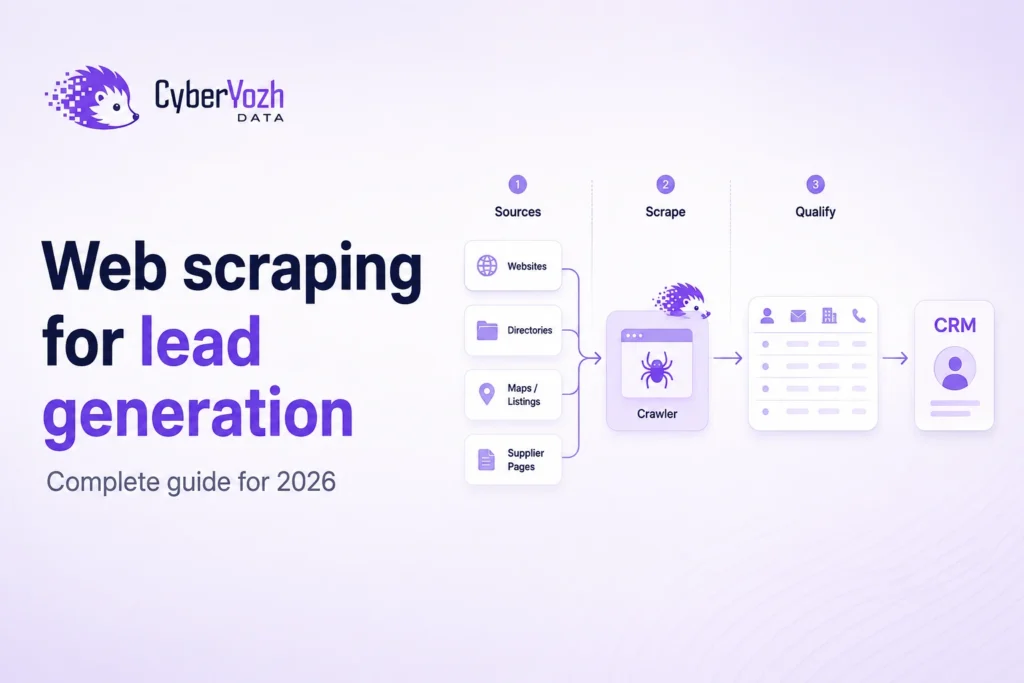
Web scraping para geração de leads: guia completo para 2026
18 Tempo estimado de leitura
RO Roman onAgosto 14, 2026

Web scraping para geração de leads: guia completo para 2026

Um guia prático para construir um fluxo de trabalho confiável de web scraping para geração de leads, desde a busca de dados comerciais públicos até o crawling, extração, validação, seleção de proxies e saída pronta para CRM.

Descubra mais