★ 89 estrelas no GitHub e a contagem continua. O Yozh Crawler + Scraper é gratuito, de código aberto e desenvolvido publicamente — dá-nos uma estrela se ele merecer o seu lugar na tua pilha de ferramentas.
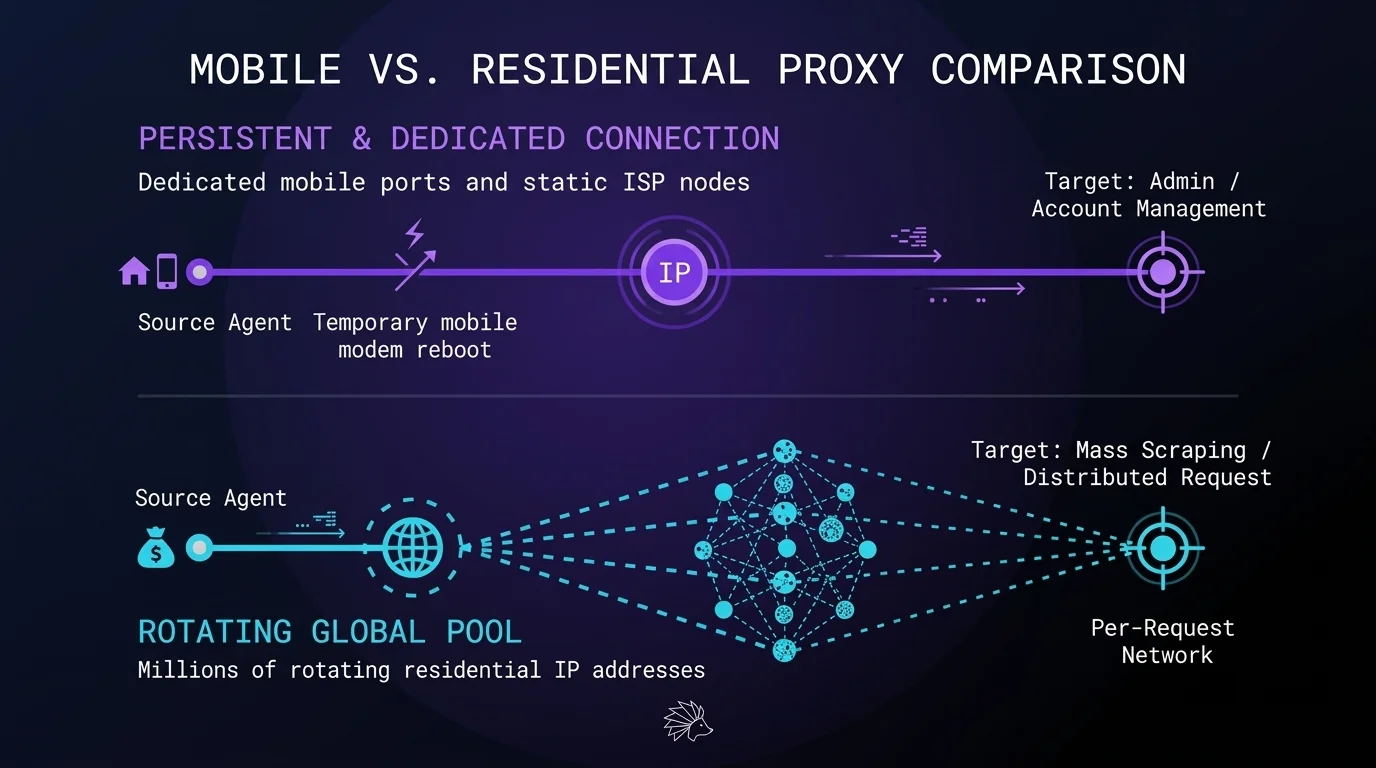
Proxies Móveis vs. Residenciais: Qual Tipo de IP Vence na Extração de Dados
13 Tempo estimado de leitura
RO Roman onSetembro 24, 2026

Proxies Móveis vs. Residenciais: Qual Tipo de IP Vence na Extração de Dados

Selecionar a infraestrutura de IP ideal molda diretamente a arquitetura do seu projeto. Escrever um código Python impecável não compensa uma pegada de rede que contradiz os dados da sua aplicação. Algoritmos de filtragem modernos analisam a camada de transporte junto com os cabeçalhos padrão do navegador. Endereços de datacenter oferecem throughput massivo para plataformas […]
Roman onSetembro 23, 2026

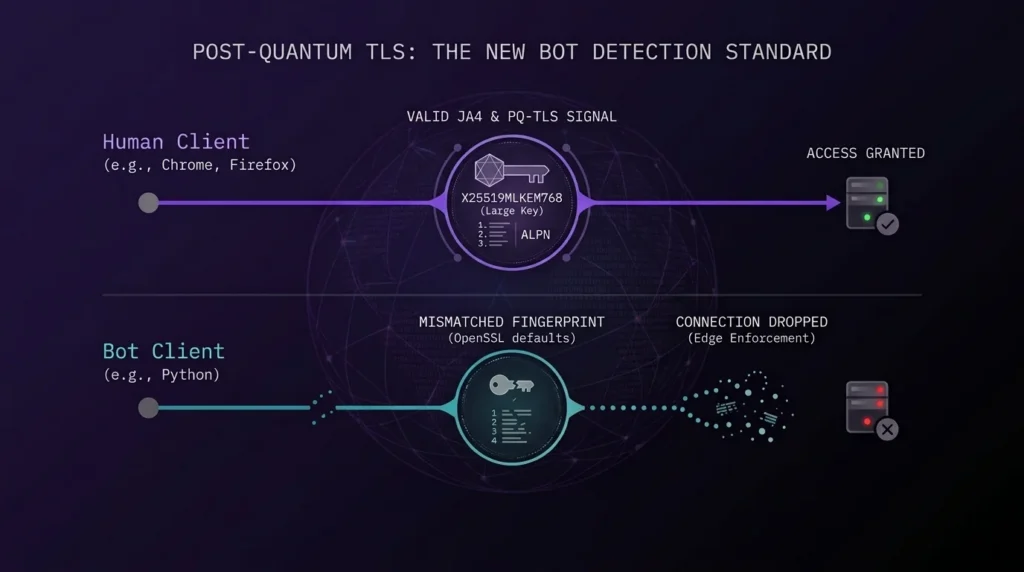
TLS Pós-Quântico: O Novo Padrão de Detecção de Bots

As redes de entrega de conteúdo agora avaliam o handshake criptográfico em vez de…

TLS Pós-Quântico: O Novo Padrão de Detecção de Bots 9 Tempo estimado de leitura
Roman onSetembro 10, 2026

Alimentando Sistemas RAG em Escala: Como Eliminar Ruído do DOM e Rotacionar Proxies para uma Ingestão Limpa em LLM

Direcionar sites modernos para treinar modelos de IA quebra os pipelines tradicionais de extração…

8 Tempo estimado de leitura
Roman onSetembro 7, 2026

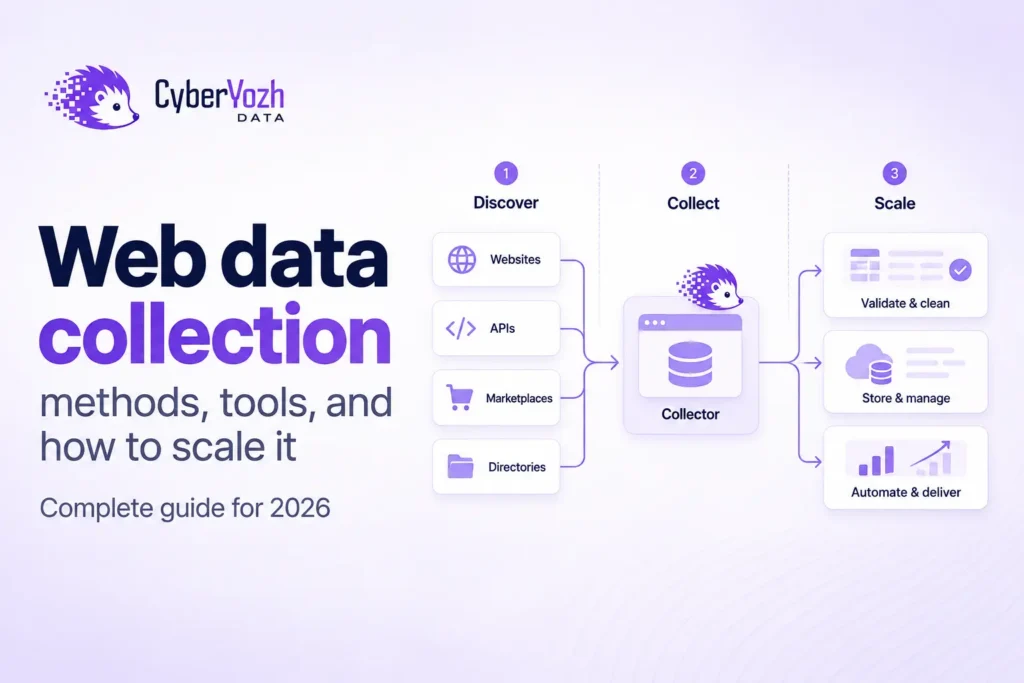
Coleta de dados da web em 2026: Métodos, ferramentas e como escalar o processo

Saiba como funciona a coleta de dados na web, quais métodos se adequam a…

Coleta de dados da web em 2026: Métodos, ferramentas e como escalar o processo 13 Tempo estimado de leitura
Proxies Móveis vs. Residenciais: Qual Tipo de IP Vence na Extração de Dados
13 Tempo estimado de leitura
RO Roman onSetembro 24, 2026

Proxies Móveis vs. Residenciais: Qual Tipo de IP Vence na Extração de Dados

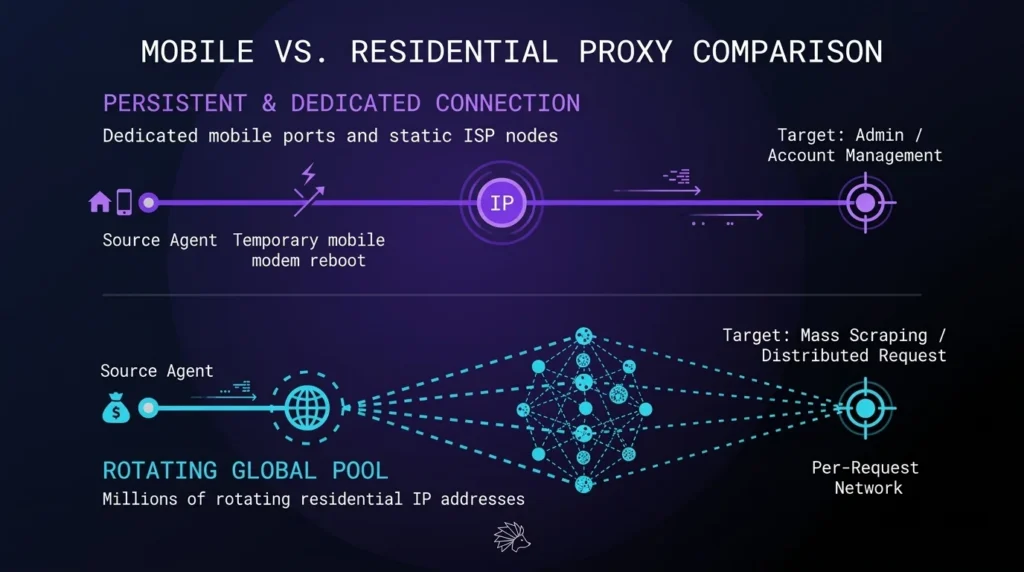
Selecionar a infraestrutura de IP ideal molda diretamente a arquitetura do seu projeto. Escrever um código Python impecável não compensa uma pegada de rede que contradiz os dados da sua aplicação. Algoritmos de filtragem modernos analisam a camada de transporte junto com os cabeçalhos padrão do navegador. Endereços de datacenter oferecem throughput massivo para plataformas […]
Descubra mais
TLS Pós-Quântico: O Novo Padrão de Detecção de Bots
9 Tempo estimado de leitura
RO Roman onSetembro 23, 2026

TLS Pós-Quântico: O Novo Padrão de Detecção de Bots

As redes de entrega de conteúdo agora avaliam o handshake criptográfico em vez de depender de cookies ou user agents rotativos. Os nós de borda modernos inspecionam a sequência exata de bytes na requisição de conexão inicial muito antes de o cliente transmitir uma carga útil HTTP. Se a matemática criptográfica não corresponder ao comportamento […]

Descubra mais
8 Tempo estimado de leitura
RO Roman onSetembro 10, 2026

Alimentando Sistemas RAG em Escala: Como Eliminar Ruído do DOM e Rotacionar Proxies para uma Ingestão Limpa em LLM

Direcionar sites modernos para treinar modelos de IA quebra os pipelines tradicionais de extração de dados. Você aponta um navegador headless para um catálogo de produtos dinâmico. O servidor de destino analisa instantaneamente a assinatura do seu TLS Client Hello. Ele verifica a sequência de frames do seu HTTP/2 antes de enviar um único byte […]

Descubra mais
Coleta de dados da web em 2026: Métodos, ferramentas e como escalar o processo
13 Tempo estimado de leitura
RO Roman onSetembro 7, 2026

Coleta de dados da web em 2026: Métodos, ferramentas e como escalar o processo

Saiba como funciona a coleta de dados na web, quais métodos se adequam a diferentes sites, quais ferramentas você precisa e como automatizar uma coleta confiável em larga escala.

Descubra mais
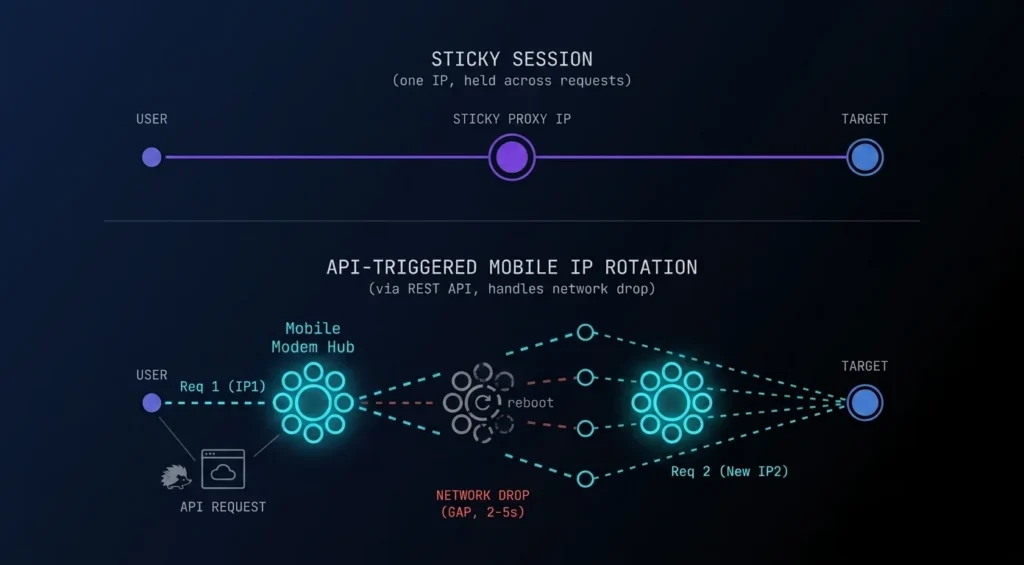
Web Scraping Automatizado com Python: Gerenciando a Rotação de IP Móvel via Requisições de API REST
10 Tempo estimado de leitura
RO Roman onSetembro 4, 2026

Web Scraping Automatizado com Python: Gerenciando a Rotação de IP Móvel via Requisições de API REST

TL;DR: Superando os gargalos do navegador A automação de navegadores acarreta uma sobrecarga computacional massiva. Navegadores headless consomem gigabytes de RAM. Eles renderizam elementos DOM desnecessários. Eles causam picos no uso de CPU durante tarefas simples de extração de dados. Engenheiros de dados eventualmente atingem limites rígidos de escalabilidade ao executar centenas de instâncias do […]

Descubra mais
8 Tempo estimado de leitura
RO Roman onAgosto 19, 2026

Playwright vs. Puppeteer para Scraping de E-commerce: Por que a Rotação Inteligente de IP é o Diferencial Definitivo

Ao avaliar Playwright vs Puppeteer para scraping de e-commerce, os engenheiros costumam se concentrar obsessivamente na velocidade de execução e na sintaxe da API. Porém, em 2026, o cenário da extração de dados mudou fundamentalmente. Os sites-alvo implementam análise comportamental agressiva, TLS fingerprinting e mutações dinâmicas do DOM. Construir um pipeline que resista a essas […]

Descubra mais