


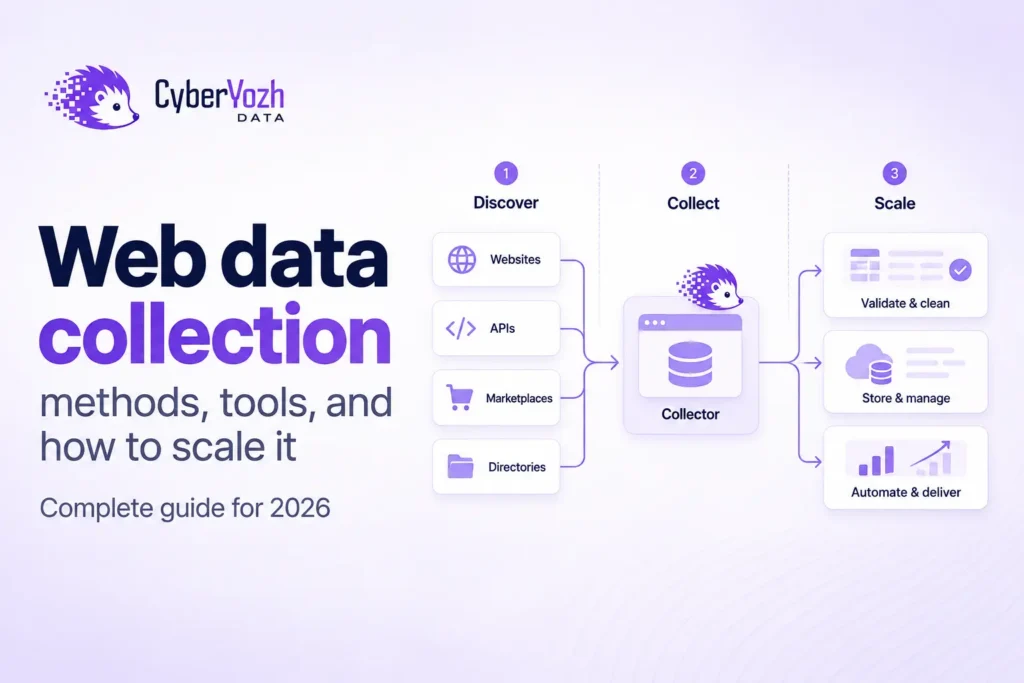
A coleta de dados da web é o processo de transformar informações publicadas na internet em dados que você pode pesquisar, comparar, analisar ou enviar para outro sistema. Um fluxo de trabalho completo faz mais do que extrair uma página: ele decide o que coletar, encontra as páginas certas, as recupera, extrai os campos necessários, verifica o resultado, armazena os dados e repete o processo quando novos dados são necessários.
Esse escopo é importante. Alguns artigos usam coleta de dados da web para incluir pesquisas, análise de clientes ou rastreamento online. Essas são formas válidas de pesquisa baseada na web, mas são diferentes de coletar dados de sites, que é o foco aqui. Preços de concorrentes, catálogos de produtos, avaliações públicas, resultados de busca, vagas de emprego, documentação e dados públicos de mercado são exemplos comuns.
Resposta rápida: Um pipeline confiável de coleta de dados da web é: definir os dados \u2192 escolher a fonte \u2192 descobrir URLs \u2192 recuperar ou renderizar páginas \u2192 extrair campos \u2192 validar registros \u2192 armazenar e monitorar a próxima execução.
O que é coleta de dados da web?
A coleta de dados da web é o processo completo de obter informações úteis de fontes web e convertê-las em um conjunto de dados. Web scraping é uma parte desse processo, não um sinônimo do todo.
A distinção fica mais clara ao separar as tarefas. O rastreamento (crawling) descobre páginas, a recuperação as baixa ou renderiza, a extração transforma o conteúdo da página em campos, a validação verifica se esses campos são utilizáveis, e o armazenamento mantém os registros para análise ou uso em outra aplicação.\u00a0
Uma revisão sistemática recente sobre web scraping, abrangendo 301 estudos primários, descreve o processo de forma semelhante: encontrar e recuperar páginas web, extrair informações úteis e transformá-las em formatos estruturados como JSON ou CSV.
Essa separação também facilita o diagnóstico de falhas. Se um conjunto de dados está com metade do catálogo faltando, o problema pode estar na descoberta, e não na extração. Se todas as URLs foram visitadas, mas o campo de preço está vazio, o rastreador pode estar funcionando corretamente enquanto a regra de extração está quebrada.
Quais são os cinco principais métodos de coleta de dados da web?
Não existe um único método de coleta ideal para todos os sites. A escolha certa depende de onde os dados estão expostos, com que frequência mudam, se JavaScript é necessário e se você já sabe quais páginas contêm os registros.
| Método | Melhor quando | Principal desvantagem |
| API oficial ou feed | A fonte expõe diretamente os campos que você precisa | A cobertura, as cotas ou o esquema podem ser limitados |
| Conjunto de dados, arquivo ou exportação | Você precisa de dados históricos ou pontuais | Pode não estar atualizado o suficiente para monitoramento |
| HTTP direto + parser | Os dados estão presentes em HTML previsível | Não é possível ver conteúdo criado apenas após a execução de JavaScript no navegador |
| Scraping baseado em navegador | As páginas exigem renderização por JavaScript ou interação permitida | Maior custo de CPU, memória e tempo de execução |
| Crawler + scraper | As páginas precisam ser descobertas em todo o site antes da extração | Requer escopo, deduplicação, limites de taxa e monitoramento |
A extração assistida por IA também é útil, mas é melhor tratá-la como uma técnica dentro desses métodos, e não como um sexto método de acesso. Um LLM pode ajudar a inferir um esquema ou recuperar um seletor, mas ainda assim trabalha sobre um conteúdo que precisou ser primeiro descoberto e recuperado. Web scraping com IA é mais útil quando apoia um processo de extração controlado, em vez de substituir a validação.
Se uma API oficial expõe exatamente os campos e a atualização que você precisa, comece por ela. Quando não expõe, os serviços de API de web scraping, a extração HTTP personalizada, a automação de navegador ou a combinação de crawler e scraper podem fornecer a cobertura que falta.
Como coletar dados da web em sete etapas?
Um fluxo de trabalho repetível começa com o contrato de dados, não com a escolha de um scraper. Isso mantém o projeto focado no resultado que você precisa, em vez de na ferramenta que por acaso é conveniente.
- Defina os campos. Decida o que compõe um registro válido, como título, preço, moeda, source_url e retrieved_at.
- Escolha a fonte. Identifique as páginas, APIs, feeds, arquivos ou domínios que contêm esses campos.
- Descubra as URLs. Use listas de URLs conhecidas, sitemaps, busca ou um crawler quando as páginas ainda não forem conhecidas.
- Recupere o conteúdo. Use HTTP direto sempre que possível e renderização por navegador quando o JavaScript for genuinamente necessário.
- Extraia os campos. Analise HTML, JSON, marcação estruturada, correspondências CSS/XPath ou outros dados de origem no seu esquema.
- Valide e elimine duplicatas. Verifique campos obrigatórios, formatos permitidos, duplicatas, valores nulos inesperados e se o registro realmente representa a página que você pretendia coletar.
- Armazene e monitore. Persista o resultado com proveniência e agende a próxima execução de acordo com a rapidez com que a fonte muda.
Essa última etapa é o que transforma uma extração pontual em coleta automatizada de dados da web. O problema mais amplo de automação de web scraping inclui novas tentativas, agendamento, filas, tratamento de falhas e a decisão sobre o que deve acontecer quando uma fonte muda.
Quais ferramentas são usadas para coleta de dados da web?
A maioria dos sistemas de produção usa várias ferramentas pequenas em vez de uma única ferramenta que faz tudo. As categorias úteis são descoberta, obtenção, extração, validação, orquestração e armazenamento.
Um crawler cuida da descoberta de URLs e do escopo do rastreamento. Clientes HTTP ou navegadores obtêm as páginas. Analisadores e regras de extração transformam o conteúdo em dados. O código de validação verifica esquemas e valores de campos. Cron, Airflow, Temporal, filas ou ferramentas de orquestração semelhantes decidem quando os trabalhos são executados, enquanto bancos de dados, armazenamentos de objetos e data warehouses mantêm os registros.
Para pipelines de análise da web pública, geralmente é melhor manter a coleta separada do armazenamento. O padrão de análise de web scraping permite que a camada de coleta produza JSON, enquanto o seu Postgres, BigQuery, Snowflake, Kafka ou outra pilha de dados existente permanece responsável pelo processamento posterior.
Qual método de coleta de dados da web é o melhor?
O melhor método é o menos complicado que retorna de forma confiável os campos, a cobertura e a atualidade que o projeto exige. Um navegador não é automaticamente melhor do que uma requisição direta, e um crawler é desnecessário quando você já tem uma lista completa de URLs.
Uma ordem prática é verificar primeiro se existe uma API ou exportação adequada e, em seguida, avaliar se o HTTP comum expõe os dados. Adicione renderização por navegador apenas para conteúdo que depende de JavaScript e adicione rastreamento apenas quando a descoberta fizer parte do problema. Isso mantém a infraestrutura proporcional à tarefa.
A fonte também importa. Um monitor diário de preços de marketplace tem requisitos diferentes de um arquivo mensal de documentação ou de um agente de IA buscando uma única página atual. A CyberYozh Data já tem exemplos mais específicos para marketplaces de e-commerce e acesso à web por agentes de IA, enquanto esta página foca na arquitetura de coleta que eles compartilham.
O que quebra quando a coleta de dados da web se expande em escala?
Em pequeno volume, a falha óbvia é uma requisição que expira ou é rejeitada. Em volume maior, a falha mais perigosa costuma ser mais silenciosa: a requisição é bem-sucedida, o trabalho termina, e ainda assim os dados estão errados.
Uma resposta 200 OK pode conter o idioma/localidade errado, uma página de consentimento, um componente vazio, um layout de produto alterado ou um tipo de página diferente. Um seletor pode continuar correspondendo após um redesenho, mas passar a retornar o preço antigo, um valor riscado ou um campo não relacionado. A contagem de linhas e as taxas de sucesso das requisições não detectam isso por si só.
É por isso que a escala deve ser medida em registros corretos por execução, não em requisições por segundo. Controles úteis incluem verificações de campos obrigatórios, validação de tipo e intervalo, URLs de origem, carimbos de data/hora de obtenção, taxas de duplicidade, taxas de nulos aceitas, cobertura em relação às URLs esperadas e alertas quando a distribuição de um campo muda de forma inesperada.
A qualidade do rastreamento importa separadamente. Defina limites rígidos de páginas e profundidade, canonicalize e elimine duplicatas de URLs, exclua padrões irrelevantes e mantenha as taxas de requisição por domínio conservadoras. Se um trabalho permitido precisar de roteamento de rede distribuído ou geográfico, adicione um proxy de web scraping porque a rede exige isso, e não simplesmente porque a tarefa é chamada de scraping. O tipo de proxy para scraping deve seguir o alvo e o padrão de tráfego.
Verificação de qualidade de dados: Uma busca bem-sucedida prova que você recebeu uma resposta. Não prova que o registro está completo, atualizado ou semanticamente correto.
Como o Yozh Crawler e o Yozh Scraper podem automatizar o pipeline?
O CyberYozh Data separa a descoberta da extração em dois serviços de código aberto, auto-hospedados. O Yozh Crawler começa a partir de uma URL semente, mantém a fronteira de exploração, deduplica as URLs descobertas, aplica regras de escopo e transmite eventos de página via SSE. O Yozh Scraper recupera as páginas, pode renderizar JavaScript com Playwright e pode extrair dados estruturados com regras CSS ou XPath.
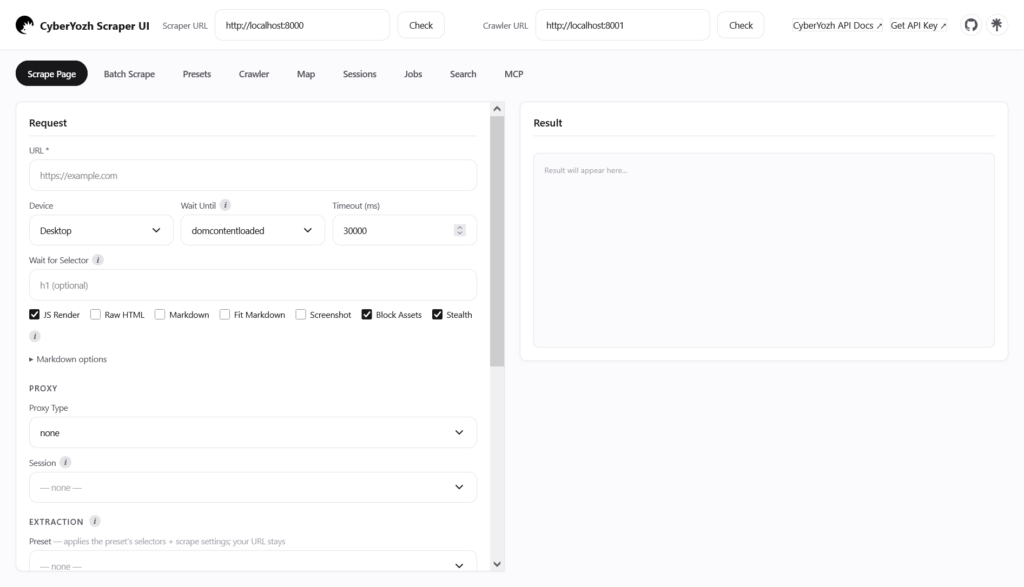
Essa divisão mapeia diretamente para um pipeline geral de coleta:
URL semente → rastrear e descobrir → recuperar ou renderizar → extrair → validar → persistir
Para um rastreamento, controles como mode, include_patterns, exclude_patterns, max_depth, max_pages, per_domain_rps e per_domain_concurrency definem para onde o crawler pode ir e com que velocidade. Para extração, o Yozh Scraper suporta render, wait_for_selector, extract, raw_html e requisições em lote (batch) através de /api/v1/scrape/pages.
Há limites operacionais que valem a pena considerar no design. O Yozh Crawler v1 não autentica seus endpoints, portanto mantenha-o em uma rede confiável ou atrás de seu próprio gateway. As tarefas de rastreamento são mantidas em memória em vez de servirem como seu armazenamento de dados de longo prazo, então persista o stream ou os resultados em seu próprio sistema. O roteamento por proxy é opcional: a coleta direta usa proxy_type: none, enquanto os tipos de proxy CyberYozh exigem CYBERYOZH_API_KEY.
Isso intencionalmente não substitui seu banco de dados, agendador ou camada de validação. É a parte de descoberta e recuperação/extração da pilha, o que facilita a troca de armazenamento ou orquestração sem reescrever o coletor.
Como coletar dados da web de forma responsável?
A coleta responsável começa antes da primeira requisição. Confirme que os dados e o uso pretendido são permitidos, mantenha a coleta limitada ao que o projeto realmente precisa, evite dados pessoais ou sensíveis desnecessários e não projete um crawler para sobrecarregar um serviço-alvo.
O robots.txt é um mecanismo padrão para que os proprietários de sites publiquem instruções para crawlers. O Protocolo de Exclusão de Robôs especifica como os clientes automatizados devem interpretar essas regras e também deixa claro que as regras de robôs não são uma forma de autorização de acesso. A documentação técnica atual do Yozh Crawler afirma que ele não consulta o robots.txt automaticamente, portanto uma implantação responsável deve verificar e aplicar as regras relevantes por conta própria através do design do rastreamento.
A política de uso e a política de alvos restritos do CyberYozh Data fornecem limites adicionais da plataforma. Acessibilidade técnica não é permissão, e visibilidade pública não elimina obrigações de privacidade, direitos autorais, contratuais ou específicas de jurisdição.
Considerações finais
A forma útil de pensar sobre coleta de dados da web é como um sistema de dados, não como um script de scraping. Descoberta, recuperação, extração, validação, armazenamento e monitoramento resolvem problemas diferentes, e mantê-los separados torna as falhas mais fáceis de detectar e o pipeline mais fácil de alterar.
Comece pelos campos e pela atualidade dos dados que você realmente precisa. Depois escolha o método de coleta mais simples que os exponha, valide o que retorna e projete a segunda execução antes de escalar a primeira.
Perguntas frequentes sobre coleta de dados da web
Estas perguntas cobrem os termos de busca restantes sem transformar questões gerais de metodologia de pesquisa em conselhos sobre web scraping. O foco permanece na obtenção de informações de sites e na transformação delas em dados utilizáveis.
O que são dados da web?
Dados da web são informações disponíveis através de sites, aplicações web, APIs, feeds, arquivos ou outras fontes acessíveis pela internet. Podem incluir texto, preços, atributos de produtos, avaliações públicas, listagens de vagas, resultados de busca, datas, links, imagens e metadados estruturados.
A coleta de dados da web é o mesmo que web scraping?
Não. O web scraping é geralmente a etapa de recuperação e extração, enquanto a coleta de dados da web também inclui seleção de fontes, descoberta de páginas, validação, armazenamento, atualização e monitoramento. O scraping pode, portanto, ser um componente de um sistema de coleta maior.
A IA pode automatizar a extração de dados da web?
A IA pode ajudar a inferir campos, gerar regras de extração, normalizar conteúdo inconsistente ou se recuperar de mudanças de layout. Ainda assim, deve ser restringida por um esquema e verificada em relação à fonte, pois um resultado plausível não é o mesmo que um resultado verificado.
Preciso de proxies para coleta automatizada de dados da web?
Nem sempre. Muitas fontes públicas ou cooperativas podem ser coletadas diretamente, especialmente com taxas de requisição moderadas. Os proxies são relevantes quando um fluxo de trabalho autorizado tem um requisito específico de roteamento de rede ou geográfico, e devem ser introduzidos por esse motivo, e não por padrão.