★ 88 звёзд на GitHub и продолжает расти. Yozh Crawler + Scraper — бесплатный, опенсорсный и создаётся публично — поставьте нам звезду, если он заслужил место в вашем стеке.
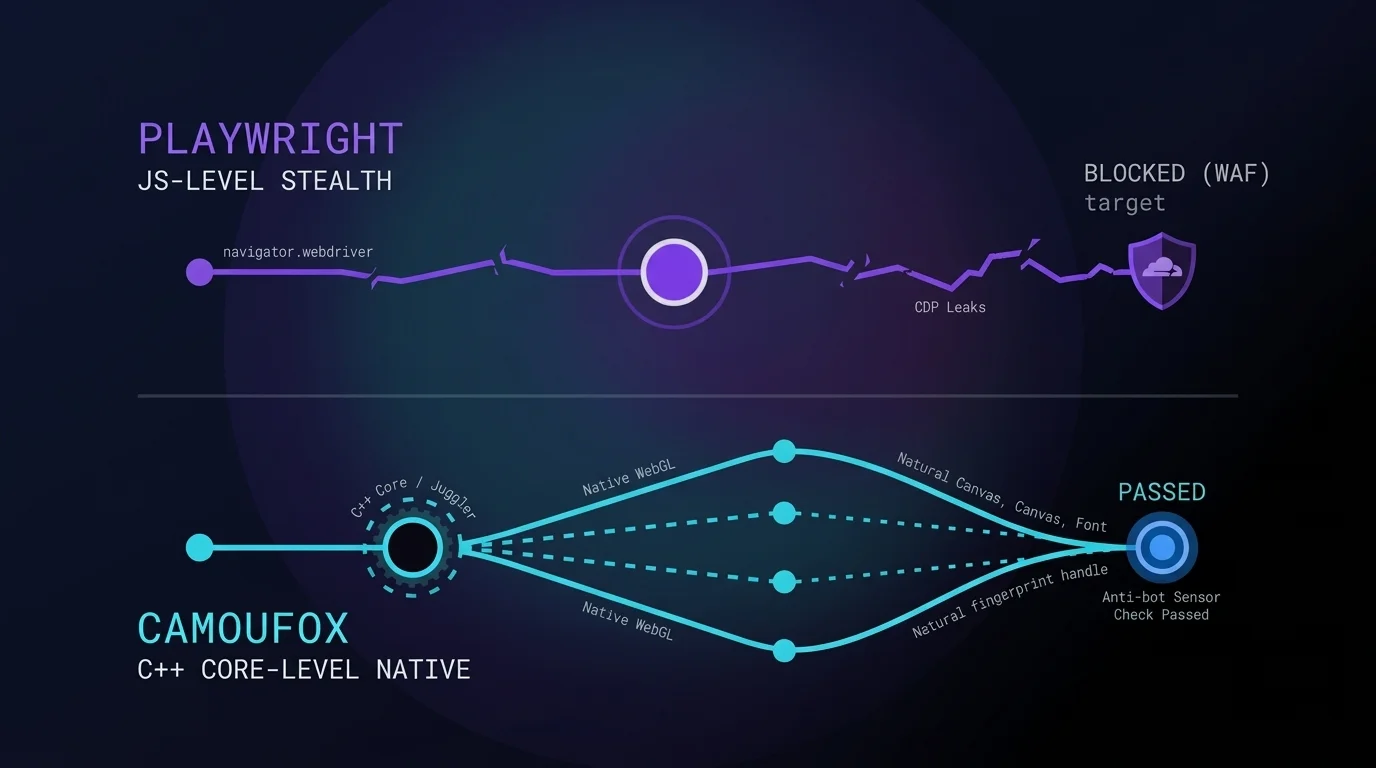
Camoufox против Playwright Stealth: C++ маскировка для автоматизации
3 мин чтения
RO Roman on1 октября, 2026

Camoufox против Playwright Stealth: C++ маскировка для автоматизации

Защита от автоматизированного сбора данных изменилась. В 2026 году Cloudflare и DataDome не опираются только на статические правила или анализ HTTP-заголовков. WAF-системы одновременно оценивают поведенческую биометрию и консистентность TLS-отпечатков (JA4). Дополнительно сервер глубоко инспектирует JavaScript-окружение на наличие внедрённых скриптов. Классические методы автоматизации перестали работать. Разработчикам необходим антидетект для парсинга, работающий на уровне исходного кода браузера. […]
Roman on24 сентября, 2026

Мобильные или резидентские прокси: Что выбрать для сбора данных

Выбор прокси для парсинга сайтов напрямую определяет архитектуру проекта. Современные алгоритмы проверяют не только…

Мобильные или резидентские прокси: Что выбрать для сбора данных 3 мин чтения
Roman on23 сентября, 2026

Настройка JA4 и TLS-отпечатков для стабильного сбора данных

Сетевые фильтры перестали доверять файлам cookie и заголовкам User-Agent. Сегодня системы защиты оценивают сам…

Настройка JA4 и TLS-отпечатков для стабильного сбора данных 3 мин чтения
Roman on10 сентября, 2026

Масштабирование RAG-систем: Очистка DOM-дерева и правильные MCP прокси для парсинга

Современные целевые сайты безжалостно отклоняют автоматизированные запросы. Вы запускаете краулер для сбора данных с…

3 мин чтения
Сбор данных с сайтов в 2026 году: методы, инструменты и как масштабировать процесс
3 мин чтения
RO Roman on7 сентября, 2026

Сбор данных с сайтов в 2026 году: методы, инструменты и как масштабировать процесс

Узнайте, как устроен сбор данных с веб-сайтов, какие методы подходят для разных сайтов, какие инструменты для этого нужны и как автоматизировать надёжный сбор данных в промышленных масштабах.

Узнать больше
Автоматизированный веб-скрапинг с Python: Обработка ротации мобильных IP через REST API
3 мин чтения
RO Roman on4 сентября, 2026

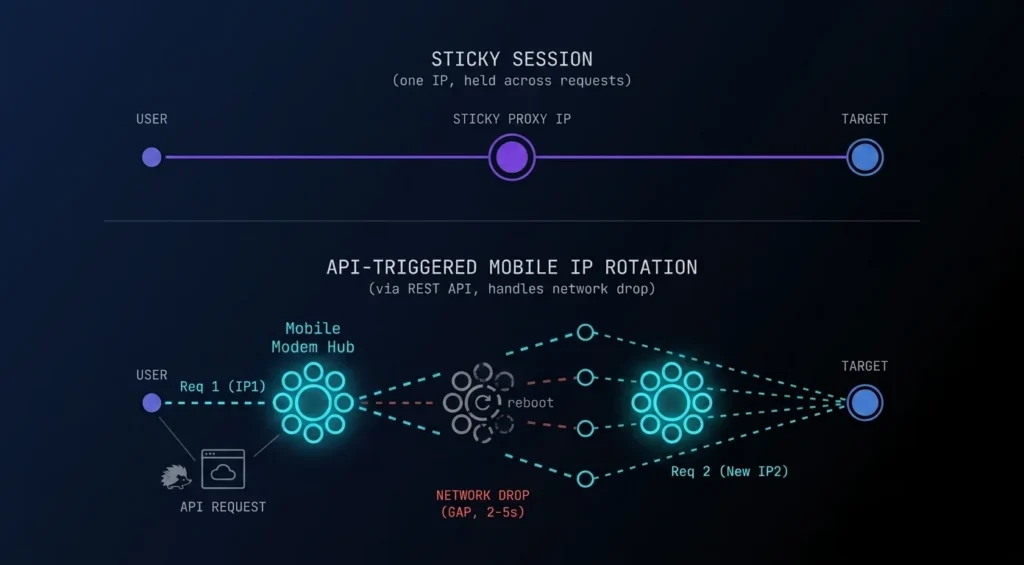
Автоматизированный веб-скрапинг с Python: Обработка ротации мобильных IP через REST API

TL;DR: Отказ от тяжёлых браузеров Браузерная автоматизация несёт колоссальные вычислительные издержки. Безголовые браузеры потребляют гигабайты оперативной памяти. Они рендерят ненужные элементы DOM-дерева. Они вызывают пиковые нагрузки на процессор при выполнении простых задач по сбору данных. Дата-инженеры рано или поздно сталкиваются с жёсткими аппаратными лимитами, пытаясь запустить сотни инстансов Selenium или Playwright. Перенос логики напрямую в […]

Узнать больше
3 мин чтения
RO Roman on3 сентября, 2026

Эволюция сетевой инфраструктуры 2026: От базового SOCKS5 к мобильным VLESS, XHTTP и XTLS-Reality сетям

Протокол SOCKS5 остаётся надёжным стандартом индустрии. Он идеально работает в доверенных корпоративных сетях. Но в условиях жёсткой DPI-фильтрации со стороны интернет-провайдеров чистый SOCKS5 становится уязвим. Локальные системы мониторинга распознают его паттерны. Сессии обрываются. Бизнес несёт убытки. Инженерам требуются дополнительные слои защиты. Корпоративные VLESS прокси для масштабирования бизнеса и автоматизации решают эту задачу. Каждый такой VLESS […]

Узнать больше
3 мин чтения
RO Roman on26 августа, 2026

Интеграция AI-агентов с веб-данными: Гайд по MCP-серверам и прокси (2026)

Краткий ответ: Протокол MCP позволяет большим языковым моделям (Claude, Cursor, Windsurf) самостоятельно искать информацию в интернете, парсить сайты и взаимодействовать с интерфейсами. Чтобы собирать данные без прерываний, необходимо маршрутизировать запросы через мобильные или резидентские IP для парсинга, поддерживающие длительное удержание сессии (sticky-сессии). Что такое протокол MCP и зачем он нужен языковым моделям Архитектура работы искусственного […]

Узнать больше
RO Roman on19 августа, 2026

Подводные камни при скрапинге: Playwright vs Puppeteer и почему ротация IP решает всё

Когда команды выбирают, что использовать: Playwright или Puppeteer для парсинга, они часто фокусируются на синтаксисе и скорости выполнения кода. Но ландшафт сбора данных кардинально изменился. Целевые веб-сайты используют агрессивный поведенческий анализ, проверку TLS-отпечатков и динамические мутации DOM-дерева. Чтобы ваш конвейер выжил в таких условиях, одного лишь фреймворка недостаточно. TL;DR: Playwright или Puppeteer для парсинга E-commerce […]

Узнать больше
3 мин чтения
RO Roman on14 августа, 2026

Скрейпинг для генерации лидов: полный гайд на 2026 год

Практический гайд по построению надёжного процесса парсинга лидов: от поиска публичных бизнес-данных до краулинга, извлечения, валидации, выбора прокси и получения данных, готовых к загрузке в CRM.

Узнать больше