За одне післяобіддя ми замінили наш внутрішній кластер Playwright на Yozh. Кінцева точка MCP одразу ж інтегрувалася в наш агент Claude — жодного допоміжного коду, а сканер і скрепер просто запрацювали.
Простий веб-скрейпінг
для штучного інтелекту
та людей
Інструмент з відкритим кодом для збору та вилучення даних. Почніть з одного URL-адреси, проскануйте сайт і отримуйте структуровані дані під час завантаження сторінок. Працює з MCP та такими інструментами, як Claude і Cursor, і має готові пресети для торгових майданчиків, таких як Amazon та eBay.
Скануйте веб-сайти повністю та отримуйте дані за один прохід
Yozh Crawler створює карту всієї структури сайту та обробляє сторінки по мірі їх виявлення. Ви отримуєте як повне охоплення, так і корисні результати за один прохід, без необхідності керувати окремими етапами сканування та вилучення даних. Ця функція працює безпосередньо в рамках ваших існуючих робочих процесів збору та вилучення даних.
Yozh Crawler, вбудований NEW
Почніть з одного URL-адреси та проскануйте весь сайт. Сторінки виявляються та обробляються за один прохід, тож ви отримуєте повне охоплення без додаткових кроків.
Режим «Відкриття» NEW
Потрібні лише посилання? Перейдіть у режим сканування та створіть карту сайту без аналізу. Швидше, легше та зручно для аудитів і перевірки структури.
Браузер із режимом прихованого перегляду
Зіставляє заголовки, місцезнаходження та сигнали браузера з вашим проксі-сервером. Допомагає забезпечити узгодженість сеансів у різних регіонах.
Пакетне вилучення даних
Виконуйте сотні URL-адрес в одному запиті. Обробляйте все паралельно, отримуючи єдиний чіткий результат.
Двоступеневе скасування NEW
Призупиніть виконання завдань, не порушуючи результатів. Дозвольте активним сторінкам завершити роботу або миттєво зупиніть усі процеси, коли це потрібно.
Інтеграція MCP
Підключіться безпосередньо до таких інструментів, як Claude та Cursor. Використовуйте скрейпінг та сканування веб-сторінок у рамках ваших існуючих робочих процесів.
10 вбудованих пресетів
Amazon, eBay, Walmart, Google, Google Shopping, YouTube, LinkedIn, Bing, Yandex — передайте назву джерела та параметри, отримайте нормалізовану відповідь. Не потрібно писати селектори.
Функція самовідновлення LLM NEW
Сайт оновив макет, а ваші CSS-селектори повертають порожні результати? Парсер звертається до великої мови (LLM) (OpenAI / Anthropic / Gemini / OpenRouter) з проханням миттєво перегенерувати селектор. Процес продовжує працювати.
Пресети, створені за допомогою штучного інтелекту NEW
Потрібен сайт, для якого у нас немає готового пресета? Опишіть, що потрібно витягти, та вставте зразок URL-адреси — POST /api/v1/presets/generate повертає готовий пресет у форматі JSON.
Сесії з автентифікацією NEW
Увійдіть один раз за допомогою декларативної DSL (goto / fill / click / wait) або вставте експортовані файли cookie. Використовуйте цю сесію під час кожного скрейпінгу. Це необхідно для об’єктів із обмеженим доступом, таких як пресет LinkedIn.
Проста інфраструктура для скрейпінгу, яку ви можете повністю контролювати
Налаштуйте свій робочий процес в одному місці та запускайте його так, як вам потрібно. Все зрозуміло, впорядковано та легко керується без додаткових інструментів.
Вбудовані проксі-сервери, готові до використання
Отримайте доступ до проксі-серверів для домашнього використання, мобільних пристроїв та центрів обробки даних у понад 120 країнах. Понад 50 мільйонів IP-адрес із часом безвідмовної роботи 99,9%. Включає підтримку функції ідентифікації за відбитками (fingerprinting) для узгодження поведінки пристрою, браузера та мережі, що забезпечує стабільність сеансів та кращий контроль.
Гнучке вилучення даних
Використовуйте селектори CSS, XPath або функцію автоматичного виявлення для популярних сайтів. Отримуйте чистий, структурований JSON без складних налаштувань.
Усі дані в одному місці
Отримайте вихідний HTML-код, скріншоти та проаналізовані дані в одному місці. Все, що вам потрібно, без необхідності перемикатися між інструментами.
Просте управління та доступ до MCP
Ви можете в будь-який момент зупинити завдання одним кліком і перемикатися між режимами «скрейпер» та «краулер». Ваш робочий процес залишається простим і повністю під вашим контролем.
Штучний інтелект, призначений для веб-скрейпінгу та веб-сканування
Підключіть Yozh Crawler та Yozh Scraper до Claude, Cursor або будь-якого клієнта MCP. Перемикайте інструменти одним натисканням — додатковий код не потрібен.
Функції веб-скрейпінгу
Усі функції Yozh Scraper доступні у вигляді функцій для вашого агента, включаючи витяг даних, пакетне виконання та створення скріншотів.
Підключення займе одну хвилину
Скопіюйте файл конфігурації, перезапустіть клієнт — і все готово.
Працює з будь-яким клієнтом MCP
«Claude Desktop», «Cursor», «Cline» або власні агенти.
Повний контроль над набором інструментів
Виберіть, як ваш агент буде виконувати завдання: від окремих сторінок до цілих партій.
Зробіть це по-своєму
Використовуйте локальний сервер MCP або розгорніть його у власній інфраструктурі.
// ~/Library/Application Support/Claude/claude_desktop_config.json { "mcpServers": { "yozh-scraper": { "type": "http", "url": "http://localhost:8000/mcp" }, "yozh-crawler": { "type": "http", "url": "http://localhost:8001/mcp" } } }
// Cursor → Settings → MCP → Add new MCP Server { "mcpServers": { "yozh-scraper": { "type": "http", "url": "http://localhost:8000/mcp" }, "yozh-crawler": { "type": "http", "url": "http://localhost:8001/mcp" } } }
// Cline → MCP Servers → Edit cline_mcp_settings.json { "mcpServers": { "yozh-scraper": { "type": "http", "url": "http://localhost:8000/mcp", "disabled": false }, "yozh-crawler": { "type": "http", "url": "http://localhost:8001/mcp", "disabled": false } } }
// Anthropic Messages API · MCP via Streamable HTTP // Note: scraper must be reachable from Anthropic's servers (deploy publicly) import Anthropic from "@anthropic-ai/sdk"; const response = await new Anthropic().messages.create({ model: "claude-opus-4-8", mcp_servers: [ { type: "url", url: "https://your-host/mcp", name: "yozh-scraper" }, { type: "url", url: "https://your-host:8001/mcp", name: "yozh-crawler" } ], messages: [...] });
Сканування, потокове завантаження та аналіз сторінок у режимі реального часу
Yozh Crawler починає з одного URL-адреси, виявляє сторінки на всьому сайті та обробляє їх під час завантаження, надаючи вам повну структуру та корисні дані за один прохід.
Пряма трансляція
Сторінки з’являються по мірі їх виявлення та обробки. Переходьте до них безпосередньо з вашого клієнта, агента або конвеєра, не чекаючи на завершення повного циклу обробки.
Режим «Відкриття»
Потрібні лише посилання? Створіть карту сайту без аналізу. Це швидше та економічніше для перевірки структури та аудиту.
Двоступеневе скасування
Безпечно зупиняйте завдання. Дочекайтеся завершення активних сторінок або миттєво зупиніть усі процеси, коли це потрібно.
Перемикач цільового режиму MCP
Перемикайтеся між режимами «скрейпер» і «краулер» одним перемикачем. Ваш агент використовує відповідний інструмент для кожного завдання.
Інтерактивна структура сайту в інтерфейсі користувача
Спостерігайте за побудовою структури сайту в режимі реального часу. Слідкуйте за ходом роботи сторінка за сторінкою, не виходячи з панелі управління.
Result
▶ Site Map (0 pages)
| URL | Parent | Depth | Status | Took |
|---|
Від одного URL-адреси до повного охоплення сайту
Пошуковий робот знаходить сторінки, скрейпер їх обробляє, а ваш агент на базі штучного інтелекту використовує отримані результати — система розроблена як для початківців, так і для експертів.
Гусеничний
Виявляє всі URL-адреси
Yozh Scraper
Витяги у форматі JSON
Штучний інтелект-агент
Аналізує та приймає рішення
Аналіз конкурентного середовища
Відстежуйте каталоги конкурентів, ціни та детальну інформацію про товари в одному місці. Виявляйте прогалини у власних пропозиціях та швидше реагуйте на зміни на ринку.
Моніторинг цін
Автоматично відстежуйте зміни цін на різних торгових майданчиках. Налаштуйте сповіщення та отримуйте повідомлення в Telegram або Slack, коли ціни змінюються.
Дані для навчання ML
Збирайте чисті, структуровані набори даних із відкритих джерел, готові до аналізу або навчання моделей. Розроблено для надійного збору даних у великих обсягах.
Почніть скрейпінг одразу ж, скориставшись готовими пресетами
Локалі, валюти, селектори та захист від ботів — уже налаштовані. Оберіть пресет, щоб побачити, які дані витягуються.
Every Amazon listing, normalized
All fields below are extracted automatically — no selectors to write.
Потрібен сайт, який ми ще не охоплюємо?
Створіть запит на GitHub або поділіться власним пресетом — ми розглядаємо запити на злиття протягом тижня.
Проксі-сервери, створені для веб-скрейпінгу
Три типи, шість конфігурацій. Обирайте залежно від завдань, швидкості та бюджету.
Мобільні 4G/5G
Справжні мобільні пристрої в мережах операторів зв’язку. Найвищий рівень надійності з суворими системами захисту від ботів.
Особистий пристрій, ручна зміна IP-адреси через API
Один пристрій — кілька користувачів
Дізнайтеся більше про мобільні проксі-сервери
Як це працює
Кожна IP-адреса належить реальному смартфону або LTE/5G-модему, підключеному до мережі одного з провідних операторів мобільного зв’язку. Цією IP-адресою користуються тисячі звичайних абонентів, тому її блокування призвело б до блокування реальних користувачів — саме тому системи захисту від ботів найбільше довіряють мобільним IP-адресам.
Найкраще підходить для
- Управління акаунтами в соціальних мережах
- Агресивні заходи проти ботів (Cloudflare, PerimeterX)
- Партнерська діяльність та перевірка реклами
- Завдання, що вимагають стабільної «людської» довіри
Технічні характеристики
- Мережі 4G LTE та 5G по всьому світу
- Підтримка протоколу UDP, підключення через VPN VLESS
- Ручна зміна IP-адреси через API або посилання на панель управління
- Налаштування «відбитка» ОС
- Необмежена пропускна здатність у більшості тарифних планів
Резидентські
IP-адреси реальних домашніх користувачів Інтернету з понад 120 країн. Доступ до понад 50 млн IP-адрес із оптимальним співвідношенням надійності та вартості.
Справжні маршрутизатори, фіксована IP-адреса на весь термін оренди
Пул IP-адрес понад 100 млн, автоматична ротація за таймером або за запитом
Дізнайтеся більше про проксі-сервери для домашнього використання
Як це працює
Побутові IP-адреси отримуються від реальних абонентів домашнього інтернету, які дають згоду на спільне використання пропускної здатності в обмін на винагороду через прозору мережу з добровільною участю. Їхнє підключення виглядає як у будь-якого іншого домашнього користувача — адже це і є домашнє підключення.
Найкраще підходить для
- Масовий веб-скрейпінг (оптимальний варіант)
- Збір даних з торгових майданчиків
- SEO-дослідження, скрейпінг результатів пошуку (SERP)
- Моніторинг брендів та цін
- Кампанії з перевірки реклами
Технічні характеристики
- Понад 120 країн, понад 100 млн унікальних IP-адрес у пулі з ротацією
- Можливість вибору між статичним та ротаційним режимом залежно від завдання
- Доступне таргетування за містом та ASN
- Підтримка протоколів HTTPS та SOCKS5
- Фіксовані сесії тривалістю до 30 хвилин
Центр обробки даних
Максимальна швидкість, мінімальні витрати. Понад 2 млн IP-адрес у дата-центрах по всьому світу.
Один IP-адреса, виділена саме вам, необмежений трафік
Спільний пул — економічний варіант для простих завдань
Дізнайтеся більше про проксі-сервери Datacenter
Як це працює
IP-адреси розміщуються в дата-центрах і не підключені до домашніх або мобільних користувачів. Вони дешевші та швидші за домашні, але системи захисту від ботів можуть розпізнавати їх як нелюдські, тому використовуйте їх там, де рівень довіри не має вирішального значення.
Найкраще підходить для
- Масове сканування дружніх сайтів
- Розробка внутрішніх інструментів та навантажувальне тестування
- Кінцеві точки API без фільтрів довіри до IP-адрес
- Завдання, в яких швидкість важливіша за маскування
Технічні характеристики
- Понад 2 млн IPv4- та IPv6-адрес
- Виділені або спільні конфігурації
- Необмежена пропускна здатність у виділених тарифних планах
- Підтримка протоколів HTTPS та SOCKS5
- Найнижча затримка серед усіх трьох типів
Етика є невід’ємною частиною того, як ми керуємо нашою платформою
Відкритий код — це лише відправна точка. Не менш важливе значення має те, як збираються дані та звідки беруться проксі-сервери. Це стандарти, яких ми дотримуємося на практиці, а не просто слова на сторінці.
Етичний збір даних
Ми створюємо інструменти, а не лазівки. Yozh Scraper розроблено для того, щоб забезпечити надійне вилучення законних відкритих даних — а не для того, щоб порушувати цілісність того, що має залишатися закритим.
- Тільки загальнодоступні дані — за замовчуванням заборонено збирання даних користувачами, що увійшли в систему
- Вбудовані обмеження швидкості запобігають перевантаженню сервера
- За замовчуванням дотримуються файли robots.txt та sitemap (можливе перевизначення)
- Збір та зберігання персональних даних не здійснюється — ні нами, ні за замовчуванням для користувачів
- Інструменти, які допоможуть вам забезпечити відповідність вимогам GDPR та CCPA
Прозора мережа проксі-серверів
Походження IP-адрес для домашнього використання є випробуванням на чесність для кожного провайдера проксі-серверів. Ось звідки саме походять наші адреси — ми чітко зазначаємо це:
- Мережа за принципом добровільної участі. Справжні користувачі дають згоду та заробляють, надаючи частину своєї пропускної здатності
- Відмова від розсилки одним кліком у будь-який час, без зайвих запитань
- Перевірений ланцюг постачання з документально підтвердженими джерелами постачання
- Жодного шкідливого програмного забезпечення, жодного прихованого вбудовування SDK — ніколи
- Адреси Mobile IP з пристроїв, які нам належать і якими ми керуємо, а не зі зламаних мобільних телефонів
Швидке реагування на випадки зловживання
Якщо хтось зловживає нашою інфраструктурою, щоб завдати шкоди іншим, ми хочемо про це дізнатися — і вжити заходів, перш ніж ситуація погіршиться.
- Прямий зв’язок із реальною людиною, а не черга на обробку запитів
- Прозорий процес розслідування кожного обґрунтованого повідомлення
- Активна співпраця з правоохоронними органами щодо підтверджених випадків
- Публічна політика щодо зловживань, викладена не дрібним шрифтом
Якщо сценарій використання передбачає зловживання або заподіяння шкоди, наші інструменти не призначені для цього. Ми ставимо відповідальне використання вище, ніж зростання кількості клієнтів.
Якщо певний випадок використання вимагає приховування особи для заподіяння шкоди іншим, наші інструменти для цього не призначені. Крапка. Ми краще втратимо клієнта, ніж відступимо від своїх принципів.
Наші політики та стандарти
Чіткі правила, що визначають нашу діяльність — від збору даних до пошуку представників та використання платформи. Це саме ті політики, яких дотримується наша команда, а не їхні короткі виклади.
Політика використання
Визначає, що дозволено на нашій інфраструктурі, а що обмежено, із чітким обґрунтуванням.
Політика реагування на зловживання
Пояснює, як звернення розглядаються, обробляються та вирішуються, включно з термінами реагування.
Стандарти формування мережі
Описує, як отримуються резидентні та мобільні IP, із моделлю opt-in і перевіреним постачанням.
Політика верифікації клієнтів
Охоплює онбординг, випадки, коли потрібна верифікація, та як обробляються дані користувачів.
Обмежені цілі
Перелічує заблоковані домени й сценарії використання, включно з чутливими секторами, як-от державний сектор і фінанси.
Політика обробки даних
Пояснює, які дані збираються, що не зберігається, обмеження щодо зберігання та передавання третім сторонам.
Як команди використовують
дані CyberYozh
Впровадження в реальних умовах
Веб-скрейпінг та аналітика
Автоматизуйте збір великих обсягів відкритих даних: каталоги товарів, рейтинги, відгуки, геодані. Yozh Scraper у поєднанні з проксі-серверами для приватного використання — легально, стабільно та без спаму.
Дізнатися більше
Штучний інтелект та автоматизація
Створюйте автономні агенти, які збирають дані, аналізують їх і виконують дії. Завдяки інтеграції з MCP Yozh Scraper стає вбудованим інструментом для Claude та Cursor — додаткова інтеграція не потрібна.
Дізнатися більше
Електронна комерція та торгові майданчики
Відстежуйте ціни, запаси та наявність товарів на Amazon, eBay та інших світових торгових майданчиках. Готові налаштування дозволяють заощадити тижні розробки.
Дізнатися більшеЩо кажуть ЗМІ та підприємства
Об’єктивні висновки з незалежних джерел
Усі статті
AFFMaven Reviews CyberYozh's Proxy & Multi-Accounting Platform
"CyberYozh stands out as a powerful platform for affiliates and arbitrage teams, combining reliable proxy infrastructure, identity tools, and strong support in one ecosystem."
TechBullion Covers CyberYozh's B2B Platform Expansion
"CyberYozh App enables businesses to launch, test, and operate digital products across more than 30 countries through a scalable infrastructure built for global connectivity, verification, and digital operations."
Grit Daily Highlights CyberYozh's Infrastructure for Enterprise Proxy Workloads
"Built for organizations that rely on proxies every day, CyberYozh App delivers infrastructure designed for stability, scalability, and high-volume workloads rather than one-off sessions."
Нас люблять data-команди та AI-розробники
Що кажуть люди, які створюють проекти за допомогою Yozh
Система пресетів — це головна фішка. Ми передаємо назву джерела й отримуємо у відповідь чистий JSON; функція автоматичного відновлення навіть встигла виявити дві зміни у макеті Amazon ще до того, як ми їх помітили.
Нарешті з’явився скрейпер з відкритим кодом, який розглядає проксі-сервери та сесії як повноцінні компоненти. Ми використовуємо його для доступу до партнерських порталів, що вимагають авторизації — сесії зберігаються, а результати залишаються однаковими в усіх регіонах.
Підключив його до Cursor через MCP, і тепер мій агент отримує веб-дані в режимі реального часу під час виконання завдання. Потокове сканування через SSE — це саме те, чого бракувало робочим процесам агента.
Ми відмовилися від платного API для зчитування даних, щоб скоротити витрати, і готувалися до погіршення якості — але отримали зовсім протилежний результат. Сервіс розміщений на власному хостингу, оплата не стягується за кожен запит, а схема вихідних даних є чіткішою, ніж та, за яку ми раніше платили.
Про веб-скрейпінг, веб-сканування та агенти на основі штучного інтелекту
Блог та статті
Усі статті
Збір даних із вебу у 2026 році: методи, інструменти та масштабування
Дізнайтеся, як працює збір даних з вебсайтів, які методи підходять для різних сайтів, які інструменти потрібні та як автоматизувати надійний збір даних у великих масштабах.
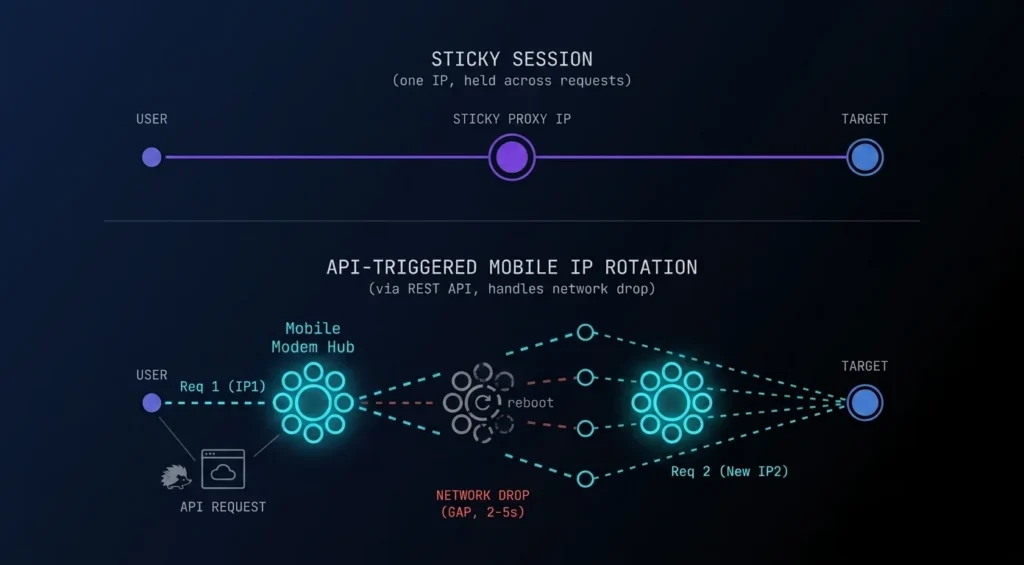
Автоматизований скрейпинг з Python: обробка ротації мобільних IP через REST API
TL;DR: Відмова від важких браузерів Браузерна автоматизація несе колосальні обчислювальні витрати. Безголові браузери потребують гігабайтів оперативної пам’яті. Вони рендерять непотрібні елементи DOM-дерева. Вони викликають пікові навантаження…
Еволюція мережевої інфраструктури 2026: Від базового SOCKS5 до мобільних мереж VLESS, XHTTP і XTLS-Reality
Протокол SOCKS5 залишається надійним стандартом індустрії. Він ідеально працює в довірених корпоративних мережах. Але за умов жорсткої DPI-фільтрації з боку інтернет-провайдерів чистий SOCKS5 стає вразливим. Локальні…
Журнал змін та оновлення щодо веб-скрейпінгу
Yozh Scraper — це проект з відкритим кодом, усі оновлення якого доступні на GitHub. Ось найважливіші новинки.
v0.1.12
- Every built-in preset now ships as an explicit per-engine variant,
<name>_chromiumand<name>_camoufox(e.g.google_search_chromium,yandex_search_camoufox). A request names the exact variant it wants; each preset carries its ownbrowser_engine. - Structured, correlated logging: business events get stable names and a request/job correlation id threaded through the scrape -> queue -> browser chain, so success/error rate and latency are answerable from logs. An opt-in JSON log shape is available via
LOG_FORMAT=json(defaulttext). - Browser egress policy knobs: an
EGRESS_ALLOW_HOSTSallowlist (empty by default) and anEGRESS_TRANSPORT_GUARDtoggle (on by default). - BREAKING (presets): the old single-name built-ins (
google_search,google_shopping,amazon_product,amazon_search,bing_search,ebay_search,linkedin_profile,walmart_product,yandex_search,youtube_video) are replaced by their per-engine variants. A request using a bare old name now returns 404preset_not_found; append the engine suffix (_chromium, or_camoufoxfor the two anti-bot targetsyandex_searchandwalmart_product). - BREAKING (deploy):
GET /api/v1/proxies/availableand the entire/api/v2/prem-proxies/*catalog now requireSERVICE_TOKENand fail closed (503 when the token is unconfigured, 401 without it). Any consumer of these endpoints must send theX-Service-Tokenheader; deploy the consumer first, or its calls degrade (for the proxy geo catalog, silently).
v0.1.11
- The job results response carries
unreadable_slots. A job with one corrupt or schema-skewed result slot now returns its other pages (HTTP 200) and names the bad slot, instead of the whole job failing with a 500 and becoming un-cancellable until its TTL expires. - The login-replay page is masked with the same host-aligned WebGL/GPU, native-looking
navigator, and Client-Hints (Sec-CH-UA) as the main fetch path, via a shared page-preparation helper. A credentialed login no longer submits a contradictory fingerprint (previously a macOS GPU and aHeadlessChromeClient-Hint under a Windows user agent). - Self-heal can no longer persist a degraded preset over a working one. It now contributes only the regenerated selector (and its dialect), keeping the preset's
all/attr/post_processand required fields, and it is graded against the original contract — so a heal that returns a bare string where a coerced list belongs is no longer counted as a recovery. It also never heals from a transient 5xx error page. This closes a class of silent preset corruption. - Proxy credentials are kept out of logs, error messages and 502 response bodies. The SOCKS bridge, the rotating-credentials response and the username log no longer emit
user:pass; a shared redactor masks proxy URLs while preservinghost:portfor diagnostics. litellmis bounded<1.98: 1.98.0 importsNotRequiredfromtypingunguarded and fails to import on the Python 3.10 this project targets, so a fresh install or image build would produce a container that cannot start.
v0.1.10
- Chromium WebGL now claims the host's actual GPU vendor/renderer, kept coherent with the Windows fingerprint the browser already presents, reusing the host-GPU detection from the Camoufox path (
HOST_GPU_VENDOR). Without it the restored context reported a generic SwiftShader/ANGLE software-renderer string, itself an automation tell. - Chromium returned a null WebGL context on GPU-less / headless hosts (Chrome 136+ dropped the automatic SwiftShader fallback), and "no WebGL context at all" is a strong bot tell that real desktop Chrome never shows. A working software WebGL context is restored via
--enable-unsafe-swiftshader, gated by the newSOFTWARE_WEBGLsetting (default on, Chromium-only; revertible by env without a code change). - README now links the project site (
data.cyberyozh.pro) with per-service pages for the scraper and crawler.
v0.1.9
- Bing organic results now unwrap Bing's click-tracking redirect links (
bing.com/ck/a?...&u=a1<base64url>) to the real destination URL. A field that should have been unwrapped but yielded nothing raises a warning instead of silently shipping the tracking link. - A failed warmup navigation is now reported (in
meta.applied_warmup) instead of being indistinguishable from a request that ran no warmup at all, so a warmup that silently failed is visible rather than looking like a no-op. - A page already classified as blocked/CAPTCHA no longer waits out the full
wait_for_selectortimeout for an extraction anchor it will never grow: the block is returned at once (roughly a 45s saving per blocked page) instead of after the selector deadline. - Yandex's self-resolving browser-check interstitial is no longer mistaken for a hard block, so it no longer burns a proxy rotation on a page that resolves itself.
- Amazon's "Sorry! Something went wrong!" throttle page is now classified as a block, so it is rotated and retried instead of returned as a successful but empty fetch that pollutes results. Guarded behind a page-size ceiling so a normal product/search page cannot false-positive on the phrase.
v0.1.0 - Durable queue, Camoufox engine & CyberYozh proxy v2
- New required services. Browsers no longer run inside the API process. You must now run the
redisandscraper-workerservices (both are already indocker-compose.yml). Scale capacity withdocker compose up -d --scale scraper-worker=N. POST /scrape/pageand/scrape/pagescan now return503 queue_fullwhen the Redis stream depth exceedsQUEUE_MAXSIZE(previously the in-memory queue was unbounded).- Removed env vars (ignored, warned at startup if set):
JOB_TIMEOUT_MS→ usePAGE_TASK_TIMEOUT_S;JOB_RESULT_MAX→ eviction is now a native Redis TTL (JOB_RESULT_TTL_S);JOBS_ENABLED→ the queue is always on. - New env vars:
REDIS_URL,PAGE_TASK_TIMEOUT_S,LOGIN_TASK_TIMEOUT_S,LOGIN_RESULT_GRACE_S,RECLAIM_IDLE_S,JOB_RESULT_TTL_S,BROWSER_MAX_PAGES,BROWSER_IDLE_SHUTDOWN_S,WARMUP_DWELL_MS. - The in-process job queue and browser worker pool are replaced by a taskiq stream on Redis. The
web-scrapercontainer only enqueues page tasks and reads results; browsers run in separate, horizontally scalablescraper-workercontainers.
Почніть працювати з веб-скрейпінгом за лічені секунди
Три команди — і у вас вже працює скрейпер + краулер з кінцевими точками HTTP та MCP.
git clone https://github.com/\ CyberYozh-data/yozh-scraper cd yozh-scraper
cp .env.example .env docker compose up --build
curl -X POST localhost:8000/api/v1/scrape/page \
-H 'Content-Type: application/json' \
-d '{"url":"https://example.com"}'
Зв’яжіться з нами
Справжня людина читає все, що надходить. Оберіть зручний для вас канал — Telegram працює найшвидше.
Готові до скребкування?
Yozh Crawler + Scraper — це безкоштовна програма. Назавжди. Поставте нам зірочку, якщо вона вам допомогла — кожна зірочка має значення.
Yozh Crawler + Scraper розповсюджується за ліцензією MIT. Користуйтеся ним. Створюйте форки. Розробляйте на його основі.