88 estrellas en GitHub y la cifra sigue aumentando. Yozh Crawler + Scraper es gratuito, de código abierto y se desarrolla de forma pública; danos una estrella si se gana un hueco en tu pila de herramientas.
v0.1.12 · Ya está aquí Yozh Crawler

Extracción
de datos web sencilla para agentes
de IA y personas

Una herramienta de código abierto para la recopilación y extracción de datos. Empieza con una sola URL, rastrea el sitio y obtén datos estructurados a medida que se cargan las páginas. Funciona con MCP y herramientas como Claude y Cursor, y cuenta con configuraciones predefinidas para plataformas de venta como Amazon y eBay.

88 Estrellas en GitHub
MIT Licencia · Gratis para siempre
v0.1.12 Última versión
Open Scraper Tester
Scraper URL http://localhost:8000 Check ok Crawler URL http://localhost:8001 Check ok CyberYozh API Docs ↗ Get API Key ↗
Scrape Page
Batch Scrape
Crawler
Jobs
MCP
Crawl Parameters
Seed URL *
Scope Mode
same-domain
Max Depth
3
Max Pages
47
Per-domain RPS
1.0
Per-domain
1
Include Patterns (regex, one per line)
^https://amazon\.co\.uk/dp/
Exclude Patterns (regex, one per line)
/cart|/account|/checkout
Crawl Proxy⚠ crawl proxy=none — no IP rotation
Proxy Type
none
Enable scraping (keep raw_html / screenshot / extracted data per page)
Result
crawl_________________ · status: idle · visited: 0 / 30 · queued: 0 · failed: 0 · dedup: 0
Crawl progress and pages will appear here...
Novedades · v0.1.12

Explora páginas web completas y obtén datos de una sola vez

Yozh Crawler genera un mapa de toda la estructura del sitio y procesa las páginas a medida que las va encontrando. De este modo, obtienes tanto cobertura como resultados útiles en una sola ejecución, sin necesidad de gestionar por separado los pasos de rastreo y extracción de datos. Funciona directamente dentro de tus flujos de trabajo existentes de recopilación de datos y extracción.

Yozh Crawler, integrado NEW

Empieza por una URL y rastrea todo el sitio web. Las páginas se detectan y procesan en una sola pasada, por lo que obtienes una cobertura completa sin pasos adicionales.

Modo Descubrimiento NEW

¿Solo necesitas enlaces? Cambia al modo de exploración y genera un mapa del sitio sin analizar el código. Es más rápido, más ligero y útil para auditorías y comprobaciones de estructura.

Navegador de incógnito

Sincroniza los encabezados, la ubicación y las señales del navegador con tu proxy. Ayuda a mantener la coherencia de las sesiones en diferentes regiones.

Extracción por lotes

Ejecuta cientos de URL en una sola solicitud. Procesa todo en paralelo con un único resultado claro.

Cancelación en dos fases NEW

Detén las tareas sin afectar a los resultados. Deja que las páginas activas terminen o detén todo al instante cuando sea necesario.

Integración de MCP

Conéctate directamente con herramientas como Claude y Cursor. Incorpora el scraping y el crawling a tus flujos de trabajo actuales.

10 preajustes integrados

Amazon, eBay, Walmart, Google, Google Shopping, YouTube, LinkedIn, Bing, Yandex: introduce el nombre de la fuente y los parámetros, y obtén una respuesta normalizada. No hay que escribir ningún selector.

Autorreparación de LLM NEW

¿Una página web implementa un cambio en el diseño y tus selectores CSS devuelven un resultado vacío? El analizador solicita a un modelo de lenguaje grande (LLM) (OpenAI / Anthropic / Gemini / OpenRouter) que vuelva a generar el selector sobre la marcha. El proceso continúa ejecutándose.

Ajustes predefinidos generados por IA NEW

¿Necesitas una página web para la que no ofrecemos una configuración predefinida? Describe qué hay que extraer y pega una URL de ejemplo — POST /api/v1/presets/generate devuelve un JSON de configuración predefinida listo para usar.

Sesiones autenticadas NEW

Inicia sesión una vez mediante un lenguaje de programación declarativo (ir a / rellenar / hacer clic / esperar) o pega las cookies exportadas. Reutiliza la sesión en cada rastreo. Es necesario para objetivos con acceso restringido, como la configuración preestablecida de LinkedIn.

Interfaz

Una infraestructura sencilla de extracción de datos bajo tu control

Configura tu flujo de trabajo en un solo lugar y ejecútalo como mejor te convenga. Todo está claro, organizado y es fácil de gestionar sin necesidad de herramientas adicionales.

1

Proxies integrados, listos para usar

Accede a proxies residenciales, móviles y de centros de datos en más de 120 países. Más de 50 millones de direcciones IP con un tiempo de actividad del 99,9 %. Incluye compatibilidad con la identificación de dispositivos para adaptar el comportamiento de estos, del navegador y de la red, lo que garantiza sesiones estables y un mayor control.

2

Extracción flexible de datos

Utiliza selectores CSS, XPath o la detección automática para sitios web populares. Obtén datos JSON limpios y estructurados sin necesidad de configuraciones complejas.

3

Todos los datos en un solo lugar

Obtén código HTML sin formato, capturas de pantalla y datos analizados, todo en un mismo lugar. Todo lo que necesitas, sin tener que cambiar de herramienta.

4

Control sencillo y acceso a MCP

Detén las tareas en cualquier momento con un solo clic y cambia entre el modo «scraper» y el modo «crawler». Tu flujo de trabajo sigue siendo sencillo y lo tienes todo bajo control.

MCP · Protocolo de contexto de modelo

Agentes de IA diseñados para el scraping y el rastreo web

Conecta Yozh Crawler y Yozh Scraper a Claude, Cursor o cualquier cliente MCP. Cambia de herramienta con un solo clic, sin necesidad de código adicional.

Funcionalidades de web scraping

Todas las funciones de Yozh Scraper están disponibles como funciones para tu agente, incluyendo el scraping, las ejecuciones por lotes y las capturas de pantalla.

Un minuto para conectarse

Copia la configuración, reinicia el cliente y ya está todo listo.

Funciona con cualquier cliente MCP

Claude Desktop, Cursor, Cline o agentes personalizados.

Control total del conjunto de herramientas

Elige cómo quiere que tu agente ejecute las tareas, desde páginas individuales hasta lotes completos.

Hazlo a tu manera

Utiliza un servidor MCP local o impleméntalo en tu propia infraestructura.

// ~/Library/Application Support/Claude/claude_desktop_config.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cursor → Settings → MCP → Add new MCP Server
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cline → MCP Servers → Edit cline_mcp_settings.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp",
      "disabled": false
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp",
      "disabled": false
    }
  }
}
// Anthropic Messages API · MCP via Streamable HTTP
// Note: scraper must be reachable from Anthropic's servers (deploy publicly)
import Anthropic from "@anthropic-ai/sdk";

const response = await new Anthropic().messages.create({
  model: "claude-opus-4-8",
  mcp_servers: [
    { type: "url", url: "https://your-host/mcp", name: "yozh-scraper" },
    { type: "url", url: "https://your-host:8001/mcp", name: "yozh-crawler" }
  ],
  messages: [...]
});
Guía completa de integración de MCP
Yozh Crawler · v0.1.12

Rastrear, transmitir y analizar páginas en tiempo real

Yozh Crawler parte de una URL, descubre las páginas de todo el sitio web y las procesa a medida que se cargan, lo que te proporciona una estructura completa y datos útiles en una sola ejecución.

Retransmisión en directo

Las páginas aparecen a medida que se detectan y se procesan. Accede directamente desde tu cliente, agente o canal de ventas sin tener que esperar a que se completen los procesos.

Modo Descubrimiento

¿Solo necesitas enlaces? Genera un mapa del sitio sin necesidad de analizar el código. Es más rápido y más económico para las comprobaciones de estructura y las auditorías.

Cancelación en dos fases

Detén los procesos de forma segura. Deja que las páginas activas terminen de cargarse o detén todo al instante cuando sea necesario.

Interruptor de destino MCP

Cambia entre el «scraper» y el «crawler» con un solo botón. Tu agente utiliza la herramienta adecuada para cada tarea.

Árbol de la página web en tiempo real en la interfaz de usuario

Observa cómo se va creando la estructura del sitio web en tiempo real. Sigue el progreso página a página sin salir del panel de control.

Result

crawl_a8f3c124b6e0d7 · status: idle · visited: 0 / 30 · queued: 0 · failed: 0 · dedup: 0 · out-of-scope: 0 · retries: 0
Site Map (0 pages)

                    
URL Parent Depth Status Took
Combinado · Oruga + Raspador

De una URL a la cobertura completa del sitio web

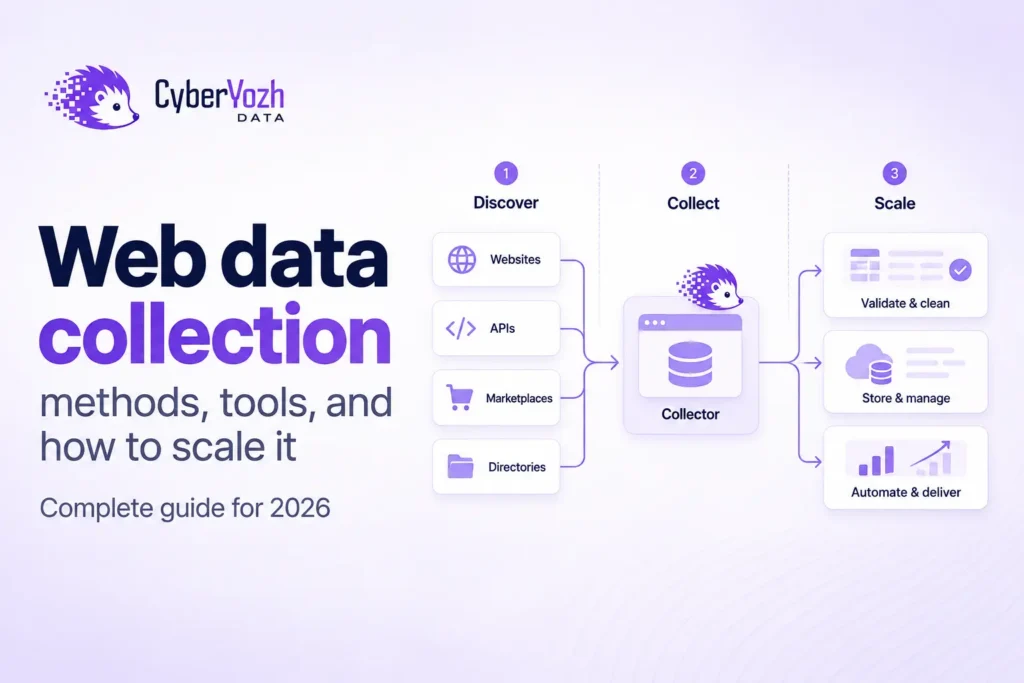
El rastreador encuentra páginas, el extractor las procesa y tu agente de IA utiliza los resultados; todo ello diseñado tanto para principiantes como para expertos.

Crawler

Detecta todas las URL

Yozh Scraper

Extracto en formato JSON

Agente de IA

Analiza y decide

Análisis de la competencia

Realiza un seguimiento de los catálogos, los precios y los detalles de los productos de la competencia en un solo lugar. Detecta las carencias en tus propios listados y reacciona más rápido a los cambios del mercado.

Rastreador JSON IA

Seguimiento de precios

Realiza un seguimiento automático de los cambios de precios en los distintos mercados. Configura alertas y recibe notificaciones en Telegram o Slack cuando los precios varíen.

Tareas por lotes programación alertas

Datos de entrenamiento de ML

Recopila conjuntos de datos limpios y estructurados procedentes de fuentes públicas, listos para su análisis o para el entrenamiento de modelos. Diseñado para una recopilación de datos fiable a gran escala.

Stealth Proxy JSON
Configuraciones predeterminadas del mercado y del sitio web

Empieza a hacer scraping ahora mismo con ajustes predefinidos listos para usar

Configuración regional, divisas, selectores y gestión antibots: todo ya configurado. Elige un perfil predefinido para ver qué datos se extraen.

10 preajustes integrados · Autorreparación del LLM cuando cambia el diseño de una página web · Genera los tuyos propios a partir de una URL de ejemplo Solicitar un preajuste →


Every Amazon listing, normalized

All fields below are extracted automatically — no selectors to write.

¿Necesitas una página web que aún no hayamos incluido?

Abre una incidencia en GitHub o comparte tu propio ajuste predefinido; revisamos las solicitudes de incorporación de cambios en el plazo de una semana.

Abrir una incidencia
Proxies

Proxies diseñados para el scraping

Tres tipos, seis configuraciones. Elige según el trabajo, la velocidad y el presupuesto.

Móvil 4G/5G

Dispositivos móviles reales conectados a redes de operadores. El nivel más alto de fiabilidad, con estrictos sistemas contra los bots.

Privado y exclusivo desde $1.7/día

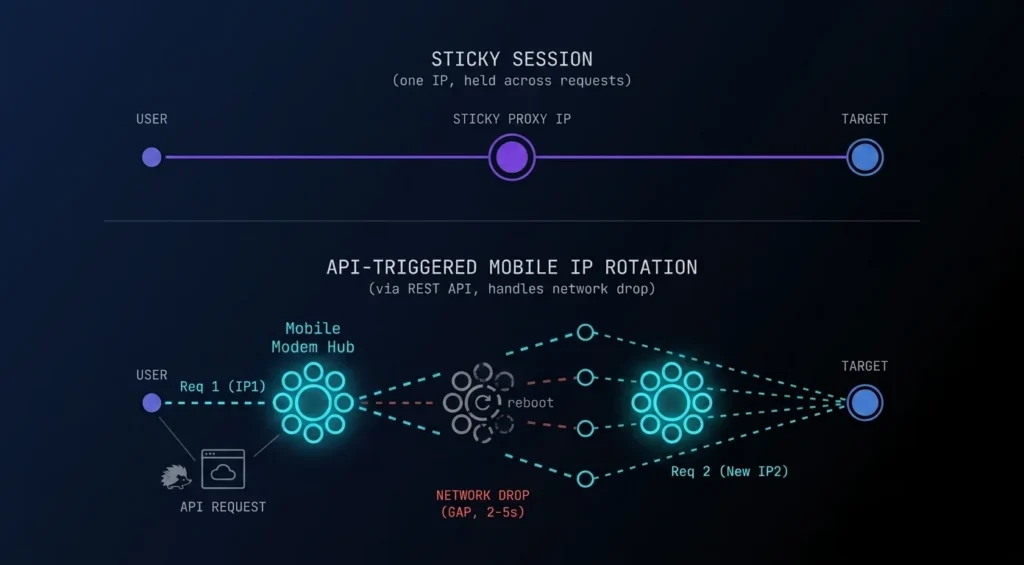
Dispositivo personal, rotación manual de IP a través de la API

Compartido desde $0.9/día

Un dispositivo, varios usuarios

Más información sobre los proxies móviles
Cómo funciona

Cada dirección IP procede de un smartphone real o de un módem LTE/5G conectado a un operador de telefonía móvil importante. La dirección IP la comparten miles de suscriptores habituales, por lo que bloquearla supondría bloquear a usuarios reales; de ahí que los sistemas antibots confíen sobre todo en las direcciones IP móviles.

Ideal para
  • Gestión de cuentas en redes sociales
  • Medidas agresivas contra los bots (Cloudflare, PerimeterX)
  • Trabajo de afiliados y verificación de anuncios
  • Tareas que requieren una confianza «similar a la humana» de forma continuada
Características técnicas
  • Redes 4G LTE y 5G en todo el mundo
  • Compatibilidad con UDP, conectividad VPN VLESS
  • Rotación manual de direcciones IP a través de la API o del enlace al panel de control
  • Ajuste de la huella digital del sistema operativo
  • Ancho de banda ilimitado en la mayoría de los planes

Centro de datos

Máxima velocidad, mínimo coste. Más de 2 millones de direcciones IP en centros de datos de todo el mundo.

Estático dedicado desde $1.9/mes

Una dirección IP asignada a ti, tráfico ilimitado

Estático compartido desde $0.5/mes

Shared Pool, la opción económica para trabajos sencillos

Más información sobre los proxies de centros de datos
Cómo funciona

Las direcciones IP están alojadas en centros de datos y no están conectadas a usuarios domésticos ni móviles. Son más baratas y rápidas que las residenciales, pero los sistemas antibots pueden identificarlas como no humanas, por lo que conviene utilizarlas en casos en los que la confianza no sea un factor crítico.

Ideal para
  • Extracción masiva de datos de sitios web amigos
  • Herramientas internas y pruebas de carga
  • Puntos finales de API sin filtros de confianza de IP
  • Tareas en las que la velocidad es más importante que el camuflaje
Características técnicas
  • Más de 2 millones de direcciones IPv4 e IPv6
  • Configuraciones dedicadas o compartidas
  • Ancho de banda ilimitado en los planes dedicados
  • Compatible con los protocolos HTTPS y SOCKS5
  • La latencia más baja de los tres tipos
Elige los proxies que mejor se adapten a tu caso de uso → Es necesario iniciar sesión
Ética · No negociable

La ética forma parte integral del funcionamiento de nuestra plataforma

El código abierto es solo el punto de partida. La forma en que se recopilan los datos y cómo se obtienen los proxies es igual de importante. Estas son las normas que seguimos en la práctica, no meras declaraciones en una página.

Recopilación ética de datos

Creamos herramientas, no lagunas legales. Yozh Scraper está diseñado para garantizar la fiabilidad de la extracción de datos públicos legítimos, no para vulnerar lo que debe permanecer privado.

  • Solo datos de acceso público: por defecto, no se permite el scraping a usuarios registrados
  • Los límites de velocidad integrados evitan la sobrecarga del servidor
  • Cumplimiento de «robots.txt» y del mapa del sitio de forma predeterminada (se puede anular)
  • No se recopilan ni almacenan datos de carácter personal, ni por nuestra parte ni, por defecto, por parte de los usuarios.
  • Herramientas que te ayudan a cumplir con el RGPD y la CCPA

Red de proxy transparente

El origen de las direcciones IP residenciales es la prueba de honestidad para cualquier proveedor de proxies. A continuación te explicamos de dónde proceden las nuestras, de forma explícita:

  • Red de participación voluntaria. Los usuarios reales dan su consentimiento y obtienen ingresos por compartir su ancho de banda.
  • Puedes darte de baja en cualquier momento con un solo clic, sin que te hagan preguntas.
  • Cadena de suministro auditada con un proceso de abastecimiento documentado
  • Sin malware, sin inyección oculta de SDK — en ningún momento
  • Direcciones IP móviles de dispositivos que poseemos y gestionamos, no de teléfonos móviles que hayan sido objeto de un ataque

Respuesta rápida ante los abusos

Si alguien hace un uso indebido de nuestra infraestructura para causar daño a otras personas, queremos saberlo y tomar medidas antes de que la situación empeore.

  • Línea directa con una persona de verdad, sin tener que esperar en una cola de tickets
  • Un proceso de investigación transparente para cada denuncia legítima
  • Cooperación activa con las fuerzas del orden en los casos confirmados
  • Política sobre el abuso público, sin esconderla entre la letra pequeña
abuse-reports@cyberyozh.com
Tiempo medio de respuesta: 45 minutos

Si un caso de uso implica un uso indebido o causa daños, nuestras herramientas no están diseñadas para ello. Damos prioridad al uso responsable frente al crecimiento de la clientela.

Si un caso de uso implica ocultar la identidad con el fin de causar daño a otras personas, nuestras herramientas no sirven para eso. Y punto. Preferimos perder al cliente antes que traicionar nuestros principios.

Apreciado por los equipos de datos y los desarrolladores de IA

Lo que dicen quienes crean con Yozh

5,0 / 5 · 5 reseñas
GitHub
En una sola tarde cambiamos nuestro clúster interno de Playwright por Yozh. El punto final de MCP se integró directamente en nuestro agente Claude: sin necesidad de código de enlace, el rastreador y el extractor funcionaron a la primera.
Marcus Reinhardt Ingeniero jefe de datos Northwind Analytics
X
El sistema de preajustes es la característica estrella. Introducimos el nombre de una fuente y obtenemos un JSON limpio; la función de autocorrección incluso detectó dos cambios en el diseño de Amazon antes de que nos diéramos cuenta.
Priya Nair Fundador ScrapeStack
Reddit
Por fin, un rastreador de código abierto que trata los proxies y las sesiones como elementos de primer orden. Lo ejecutamos tras las barreras de inicio de sesión de los portales de nuestros socios: las sesiones se mantienen y los resultados son coherentes en todas las regiones.
Daniel Osei Ingeniero de backend Loopfeed
X
Lo he conectado a Cursor a través de MCP y ahora mi agente extrae datos web en tiempo real mientras realiza la tarea. El rastreo en tiempo real a través de SSE es justo lo que les faltaba a los flujos de trabajo de los agentes.
Elena Kovac Ingeniero de IA Vektor Labs
GitHub
Dejamos de utilizar una API de extracción de datos de pago para reducir costes y nos preparamos para un empeoramiento del servicio, pero ocurrió todo lo contrario. Es autohospedada, no hay facturación por solicitud y el esquema de salida es más claro que el que solíamos pagar.
Sofia Almeida Jefe de Ingeniería Tabbly
Registro de cambios

Registro de cambios y actualizaciones de Web scraping

Yozh Scraper es un proyecto de código abierto, y todas las actualizaciones están disponibles en GitHub. A continuación se detallan las novedades más destacadas.

v0.1.12 1 septiembre 2026 Latest

v0.1.12

  • Every built-in preset now ships as an explicit per-engine variant, <name>_chromium and <name>_camoufox (e.g. google_search_chromium, yandex_search_camoufox). A request names the exact variant it wants; each preset carries its own browser_engine.
  • Structured, correlated logging: business events get stable names and a request/job correlation id threaded through the scrape -> queue -> browser chain, so success/error rate and latency are answerable from logs. An opt-in JSON log shape is available via LOG_FORMAT=json (default text).
  • Browser egress policy knobs: an EGRESS_ALLOW_HOSTS allowlist (empty by default) and an EGRESS_TRANSPORT_GUARD toggle (on by default).
  • BREAKING (presets): the old single-name built-ins (google_search, google_shopping, amazon_product, amazon_search, bing_search, ebay_search, linkedin_profile, walmart_product, yandex_search, youtube_video) are replaced by their per-engine variants. A request using a bare old name now returns 404 preset_not_found; append the engine suffix (_chromium, or _camoufox for the two anti-bot targets yandex_search and walmart_product).
  • BREAKING (deploy): GET /api/v1/proxies/available and the entire /api/v2/prem-proxies/* catalog now require SERVICE_TOKEN and fail closed (503 when the token is unconfigured, 401 without it). Any consumer of these endpoints must send the X-Service-Token header; deploy the consumer first, or its calls degrade (for the proxy geo catalog, silently).
v0.1.11 25 agosto 2026

v0.1.11

  • The job results response carries unreadable_slots. A job with one corrupt or schema-skewed result slot now returns its other pages (HTTP 200) and names the bad slot, instead of the whole job failing with a 500 and becoming un-cancellable until its TTL expires.
  • The login-replay page is masked with the same host-aligned WebGL/GPU, native-looking navigator, and Client-Hints (Sec-CH-UA) as the main fetch path, via a shared page-preparation helper. A credentialed login no longer submits a contradictory fingerprint (previously a macOS GPU and a HeadlessChrome Client-Hint under a Windows user agent).
  • Self-heal can no longer persist a degraded preset over a working one. It now contributes only the regenerated selector (and its dialect), keeping the preset's all / attr / post_process and required fields, and it is graded against the original contract — so a heal that returns a bare string where a coerced list belongs is no longer counted as a recovery. It also never heals from a transient 5xx error page. This closes a class of silent preset corruption.
  • Proxy credentials are kept out of logs, error messages and 502 response bodies. The SOCKS bridge, the rotating-credentials response and the username log no longer emit user:pass; a shared redactor masks proxy URLs while preserving host:port for diagnostics.
  • litellm is bounded <1.98: 1.98.0 imports NotRequired from typing unguarded and fails to import on the Python 3.10 this project targets, so a fresh install or image build would produce a container that cannot start.
v0.1.10 20 agosto 2026

v0.1.10

  • Chromium WebGL now claims the host's actual GPU vendor/renderer, kept coherent with the Windows fingerprint the browser already presents, reusing the host-GPU detection from the Camoufox path (HOST_GPU_VENDOR). Without it the restored context reported a generic SwiftShader/ANGLE software-renderer string, itself an automation tell.
  • Chromium returned a null WebGL context on GPU-less / headless hosts (Chrome 136+ dropped the automatic SwiftShader fallback), and "no WebGL context at all" is a strong bot tell that real desktop Chrome never shows. A working software WebGL context is restored via --enable-unsafe-swiftshader, gated by the new SOFTWARE_WEBGL setting (default on, Chromium-only; revertible by env without a code change).
  • README now links the project site (data.cyberyozh.pro) with per-service pages for the scraper and crawler.
v0.1.9 18 agosto 2026

v0.1.9

  • Bing organic results now unwrap Bing's click-tracking redirect links (bing.com/ck/a?...&u=a1<base64url>) to the real destination URL. A field that should have been unwrapped but yielded nothing raises a warning instead of silently shipping the tracking link.
  • A failed warmup navigation is now reported (in meta.applied_warmup) instead of being indistinguishable from a request that ran no warmup at all, so a warmup that silently failed is visible rather than looking like a no-op.
  • A page already classified as blocked/CAPTCHA no longer waits out the full wait_for_selector timeout for an extraction anchor it will never grow: the block is returned at once (roughly a 45s saving per blocked page) instead of after the selector deadline.
  • Yandex's self-resolving browser-check interstitial is no longer mistaken for a hard block, so it no longer burns a proxy rotation on a page that resolves itself.
  • Amazon's "Sorry! Something went wrong!" throttle page is now classified as a block, so it is rotated and retried instead of returned as a successful but empty fetch that pollutes results. Guarded behind a page-size ceiling so a normal product/search page cannot false-positive on the phrase.
v0.1.0 9 julio 2026 First release

v0.1.0 - Durable queue, Camoufox engine & CyberYozh proxy v2

  • New required services. Browsers no longer run inside the API process. You must now run the redis and scraper-worker services (both are already in docker-compose.yml). Scale capacity with docker compose up -d --scale scraper-worker=N.
  • POST /scrape/page and /scrape/pages can now return 503 queue_full when the Redis stream depth exceeds QUEUE_MAXSIZE (previously the in-memory queue was unbounded).
  • Removed env vars (ignored, warned at startup if set): JOB_TIMEOUT_MS → use PAGE_TASK_TIMEOUT_S; JOB_RESULT_MAX → eviction is now a native Redis TTL (JOB_RESULT_TTL_S); JOBS_ENABLED → the queue is always on.
  • New env vars: REDIS_URL, PAGE_TASK_TIMEOUT_S, LOGIN_TASK_TIMEOUT_S, LOGIN_RESULT_GRACE_S, RECLAIM_IDLE_S, JOB_RESULT_TTL_S, BROWSER_MAX_PAGES, BROWSER_IDLE_SHUTDOWN_S, WARMUP_DWELL_MS.
  • The in-process job queue and browser worker pool are replaced by a taskiq stream on Redis. The web-scraper container only enqueues page tasks and reads results; browsers run in separate, horizontally scalable scraper-worker containers.
Inicio rápido

Empieza a extraer datos de la web en cuestión de segundos

Tres comandos y ya tienes un scraper y un crawler en funcionamiento con puntos de conexión HTTP y MCP.

1 Clonar
git clone https://github.com/\
  CyberYozh-data/yozh-scraper
cd yozh-scraper
2 Correr
cp .env.example .env
docker compose up --build
3 Raspar
curl -X POST localhost:8000/api/v1/scrape/page \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com"}'
Documentación completa Conéctate a Claude / Cursor a través de MCP →
Contacto · Asistencia técnica

Ponte en contacto con nosotros

Una persona de verdad lee todo lo que llega. Elige el canal que más te convenga: Telegram es el más rápido.

Oficina
Jurija Gagarina 231/329
Novi Beograd · Serbia
Asistencia en dos niveles, prácticamente las 24 horas del día Servicio de primera línea disponible casi las 24 horas del día, los 7 días de la semana. Los ingenieros sénior se encargan de los casos más complejos.
Código abierto · Licencia MIT · 88 ★

¿Listo para raspar?

Yozh Crawler + Scraper es gratis. Para siempre. Danos una estrella si te resulta útil: cada estrella cuenta.

Yozh Crawler + Scraper se distribuye bajo la licencia MIT. Úsalo. Haz un fork. Desarrolla con él.