★ 89 зірок на GitHub, і їхня кількість продовжує зростати. Yozh Crawler + Scraper — це безкоштовний проект з відкритим кодом, який розробляється відкрито. Поставте нам зірку, якщо він заслуговує на місце у вашому стеку.
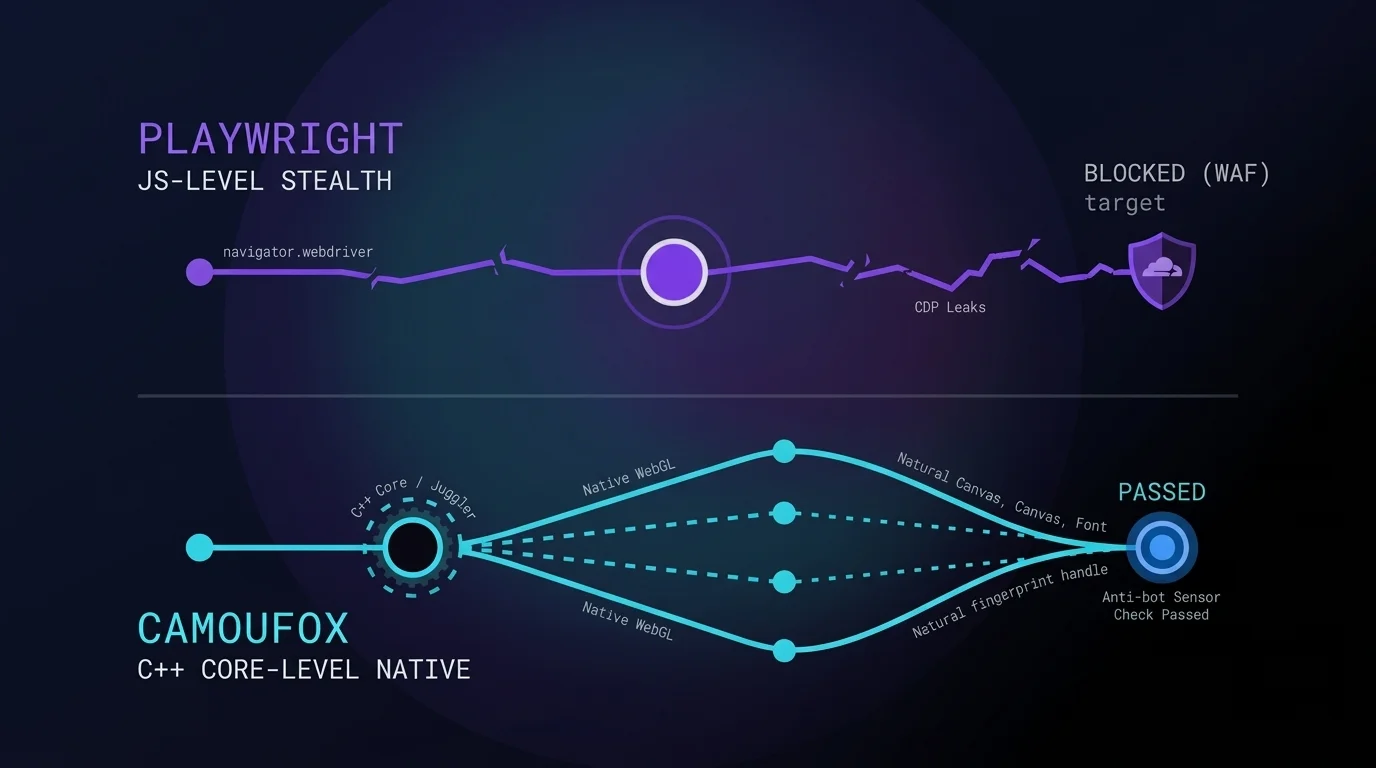
Camoufox проти Playwright Stealth: маскування на C++ для автоматизації
3 Час читання
RO Roman on1 Жовтня, 2026

Camoufox проти Playwright Stealth: маскування на C++ для автоматизації

Захист від автоматизованого збору даних змінився. У 2026 році Cloudflare та DataDome спираються не лише на статичні правила чи аналіз HTTP-заголовків. WAF-системи одночасно оцінюють поведінкову біометрію та консистентність TLS-відбитків (JA4). Крім того, сервер глибоко інспектує JavaScript-оточення на наявність упроваджених скриптів. Класичні методи автоматизації перестали працювати. Розробникам потрібен антидетект для парсингу, що працює на рівні вихідного […]
Roman on24 Вересня, 2026

Мобільні чи резидентські проксі: що обрати для збору даних

Вибір проксі для парсингу сайтів насамперед визначає архітектуру проєкту. Сучасні алгоритми перевіряють не лише…

Мобільні чи резидентські проксі: що обрати для збору даних 3 Час читання
Roman on23 Вересня, 2026

Налаштування JA4 та TLS-відбитків для стабільного збору даних

Мережеві фільтри давно перестали довіряти файлам cookie і заголовкам User-Agent. Сьогодні системи захисту оцінюють…

Налаштування JA4 та TLS-відбитків для стабільного збору даних 3 Час читання
Roman on10 Вересня, 2026

Масштабування RAG-систем: очищення DOM-дерева та правильні MCP проксі для парсингу

Сучасні цільові сайти безжально відсіюють автоматизовані запити. Ви запускаєте краулер для збору даних із…

3 Час читання
3 Час читання
RO Roman on3 Вересня, 2026

Еволюція мережевої інфраструктури 2026: Від базового SOCKS5 до мобільних мереж VLESS, XHTTP і XTLS-Reality

Протокол SOCKS5 залишається надійним стандартом індустрії. Він ідеально працює в довірених корпоративних мережах. Але за умов жорсткої DPI-фільтрації з боку інтернет-провайдерів чистий SOCKS5 стає вразливим. Локальні системи моніторингу розпізнають його патерни. Сесії обриваються. Бізнес несе збитки. Інженерам потрібні додаткові рівні захисту. Корпоративні VLESS проксі для масштабування бізнесу й автоматизації вирішують це завдання. Кожен такий VLESS […]

Дізнатися більше
3 Час читання
RO Roman on26 Серпня, 2026

Інтеграція AI-агентів з веб-даними: гайд по MCP-серверах та проксі (2026)

Коротка відповідь: Протокол MCP дозволяє великим мовним моделям (Claude, Cursor, Windsurf) самостійно шукати інформацію в інтернеті, парсити сайти та взаємодіяти з інтерфейсами. Щоб збирати дані без перерв, потрібно маршрутизувати запити через мобільні або резидентські IP для парсингу, які підтримують тривале утримання сесії (sticky-сесії). Що таке протокол MCP і навіщо він потрібен мовним моделям Архітектура роботи […]

Дізнатися більше
RO Roman on19 Серпня, 2026

Підводні камені під час скрейпингу: Playwright проти Puppeteer і чому ротація IP розв’язує все

Коли команди вибирають, що використовувати: Playwright чи Puppeteer для парсингу, вони часто зосереджуються на синтаксисі та швидкості виконання коду. Але ландшафт збору даних кардинально змінився. Цільові веб-сайти застосовують агресивний поведінковий аналіз, перевірку TLS-відбитків і динамічні мутації DOM-дерева. Щоб ваш конвеєр вижив у таких умовах, самого лише фреймворка недостатньо. TL;DR: Playwright чи Puppeteer для парсингу E-commerce […]

Дізнатися більше
Скрейпинг для лідогенерації: повний гайд на 2026 рік
3 Час читання
RO Roman on14 Серпня, 2026

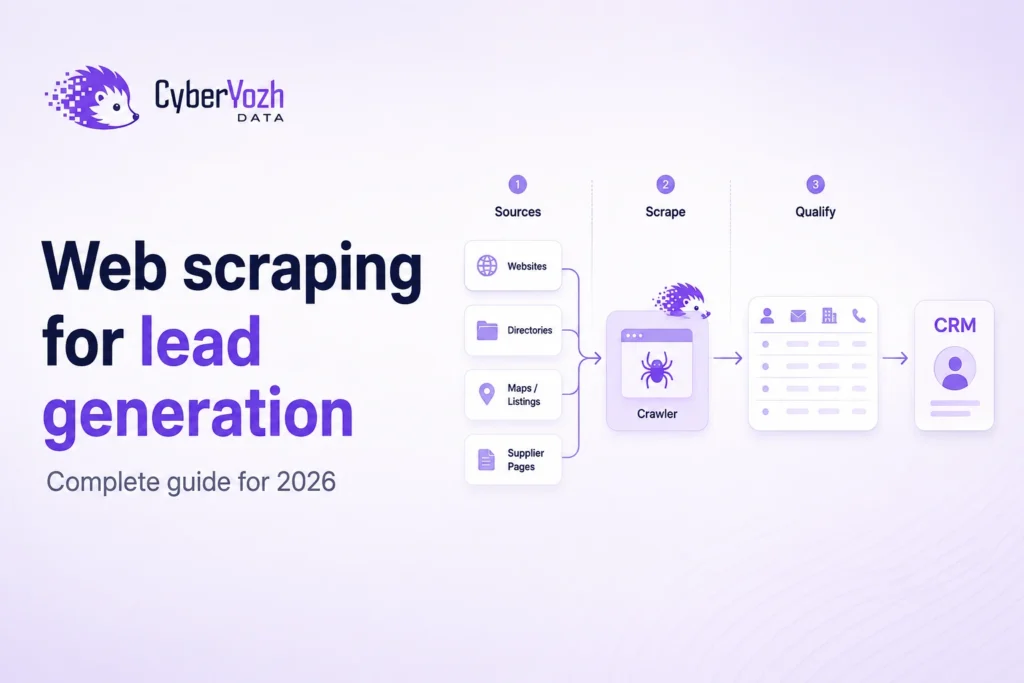
Скрейпинг для лідогенерації: повний гайд на 2026 рік

Практичний гайд зі створення надійного процесу скрейпингу для лідогенерації: від пошуку публічних бізнес-даних до краулінгу, вилучення даних, валідації, вибору проксі та підготовки виводу, готового для CRM.

Дізнатися більше
Найкращі інструменти та методи парсингу рейтингових даних товарів Amazon у 2026 році
3 Час читання
RO Roman on14 Серпня, 2026

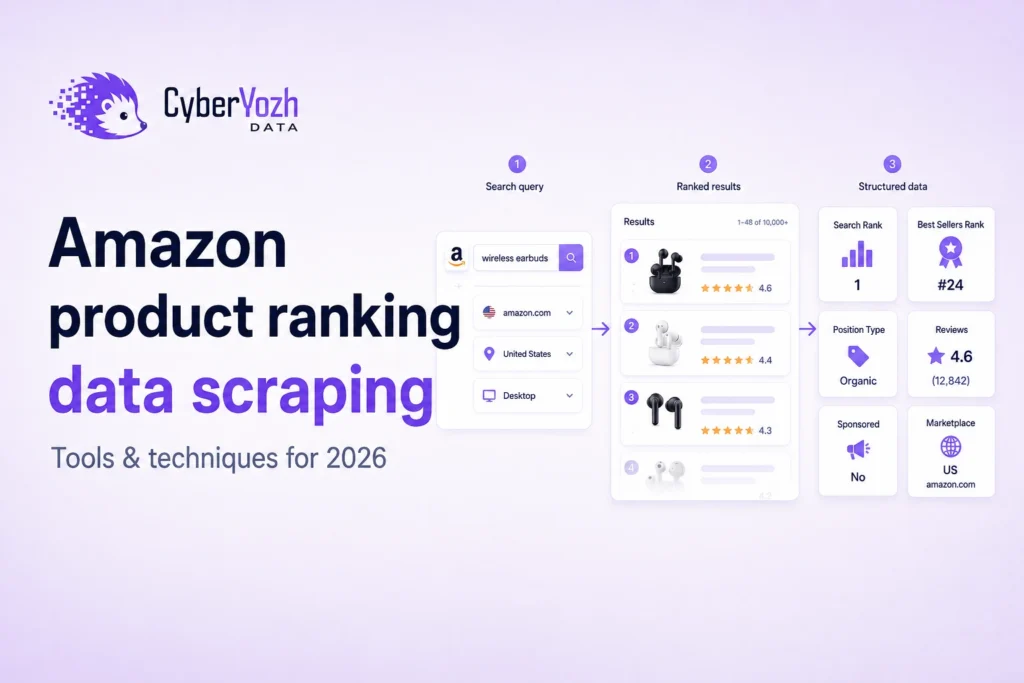
Найкращі інструменти та методи парсингу рейтингових даних товарів Amazon у 2026 році

Практичний гайд зі збору даних про позиції в пошуку Amazon, Best Sellers Rank, відгуки, ціни та дані конкурентів за допомогою CyberYozh Data зі збереженням контексту маркетплейсу, локації, часової мітки та рейтингу.

Дізнатися більше
RO Roman on14 Серпня, 2026

Впровадження LLM-парсингу з автоналаштуванням у Yozh Scraper

Збір веб-даних — фундаментальна основа для розробки сучасного штучного інтелекту, маркетингової аналітики та конкурентної розвідки. Однак створення надійних конвеєрів даних залишається головним інженерним викликом. Цільові веб-сайти постійно впроваджують структурні зміни, проводять A/B-тестування та використовують динамічну обфускацію, через що жорсткі скрипти збору даних неминуче ламаються. Для розв’язання цієї проблеми крихкості екосистема веб-скрейпингу потребує фундаментального архітектурного зсуву. […]

Дізнатися більше