★ 90 bintang di GitHub dan terus bertambah. Yozh Crawler + Scraper adalah perangkat lunak gratis, sumber terbuka, dan dikembangkan secara terbuka — berikan kami bintang jika alat ini layak masuk ke dalam tumpukan teknologi Anda.
RO Roman onOktober 1, 2026

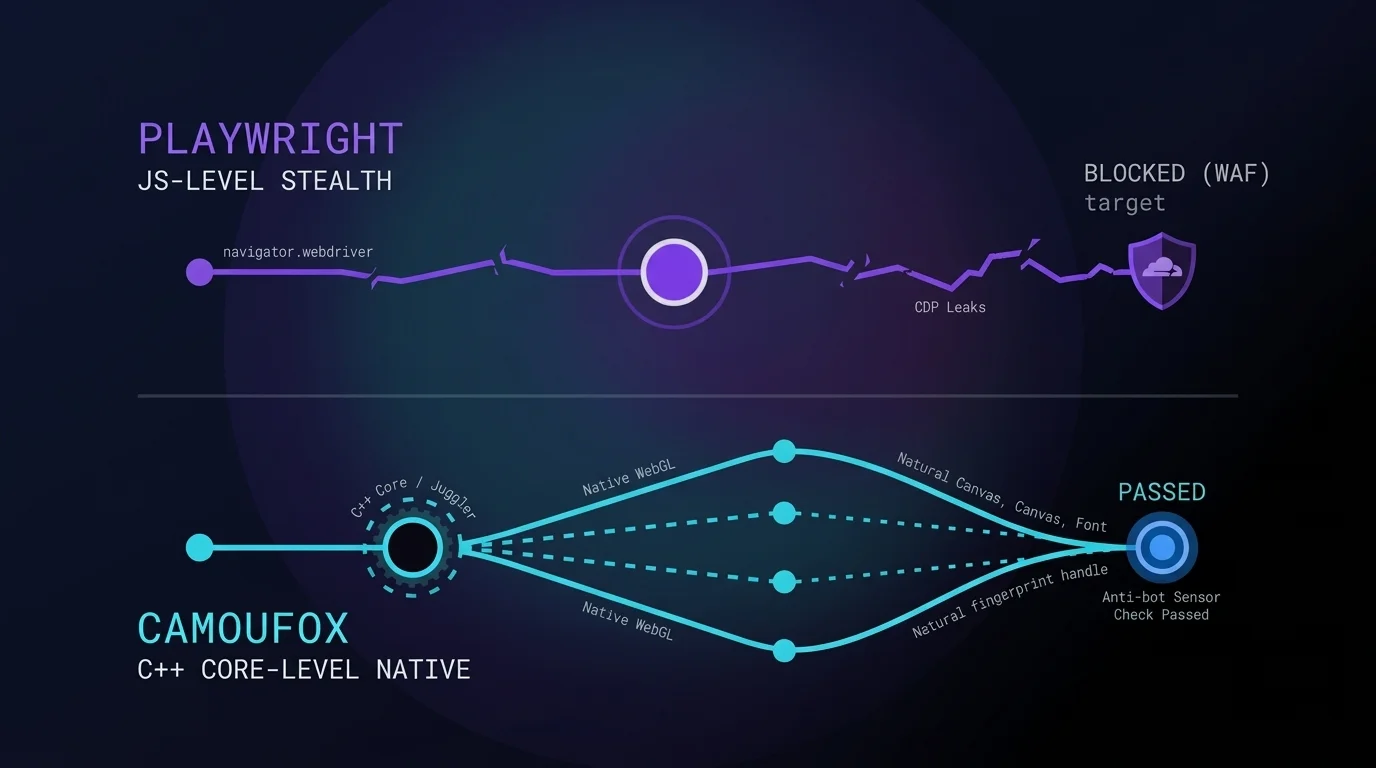
Playwright vs Camoufox: Masa Depan Otomasi Browser Anti-Deteksi

Keamanan ekstraksi data telah berubah. Pada tahun 2026, Cloudflare dan DataDome tidak lagi mengandalkan penguraian user-agent dasar. Platform-platform ini mengevaluasi biometrik perilaku bersama dengan TLS fingerprinting struktural (JA4). Algoritma pertahanan juga memeriksa lingkungan untuk mendeteksi manipulasi JavaScript. Patch JavaScript tradisional gagal. Para insinyur membutuhkan solusi anti detect browser scraping yang tertanam langsung pada level kode […]
Roman onSeptember 24, 2026

Proxy Mobile vs. Residential: Jenis IP Mana yang Unggul untuk Ekstraksi Data

Memilih infrastruktur IP yang optimal secara langsung membentuk arsitektur proyek Anda. Menulis kode Python…

Proxy Mobile vs. Residential: Jenis IP Mana yang Unggul untuk Ekstraksi Data 10 Waktu Baca:
Roman onSeptember 23, 2026

TLS Pasca-Kuantum: Standar Baru Deteksi Bot

Content delivery network kini mengevaluasi jabat tangan kriptografi, bukan mengandalkan cookie atau rotasi user…

TLS Pasca-Kuantum: Standar Baru Deteksi Bot 7 Waktu Baca:
Roman onSeptember 10, 2026

Memberi Makan Sistem RAG dalam Skala Besar: Cara Membersihkan Kebisingan DOM dan Merotasi Proxy untuk Ingesti LLM yang Bersih

Menargetkan situs web modern untuk melatih model AI dapat merusak pipeline ekstraksi data tradisional.…

7 Waktu Baca:
RO Roman onAgustus 14, 2026

Pipeline Scraping yang Tangguh: Memperkenalkan LLM Self-Healing Parsing di Yozh Scraper

Ekstraksi data adalah lapisan fundamental dalam pengembangan kecerdasan buatan modern, intelijen pasar, dan analisis kompetitif. Namun, membangun pipeline data yang andal tetap menjadi hambatan rekayasa. Situs web target terus-menerus menerapkan perubahan struktural, pengujian A/B, dan obfuskasi dinamis, yang menyebabkan skrip ekstraksi kaku menjadi gagal. Untuk mengatasi paradigma kerapuhan ini, ekosistem web scraping memerlukan perubahan arsitektur […]

Temukan Lebih Banyak Lagi