★ 89 bintang di GitHub dan terus bertambah. Yozh Crawler + Scraper adalah perangkat lunak gratis, sumber terbuka, dan dikembangkan secara terbuka — berikan kami bintang jika alat ini layak masuk ke dalam tumpukan teknologi Anda.
RO Roman onSeptember 24, 2026

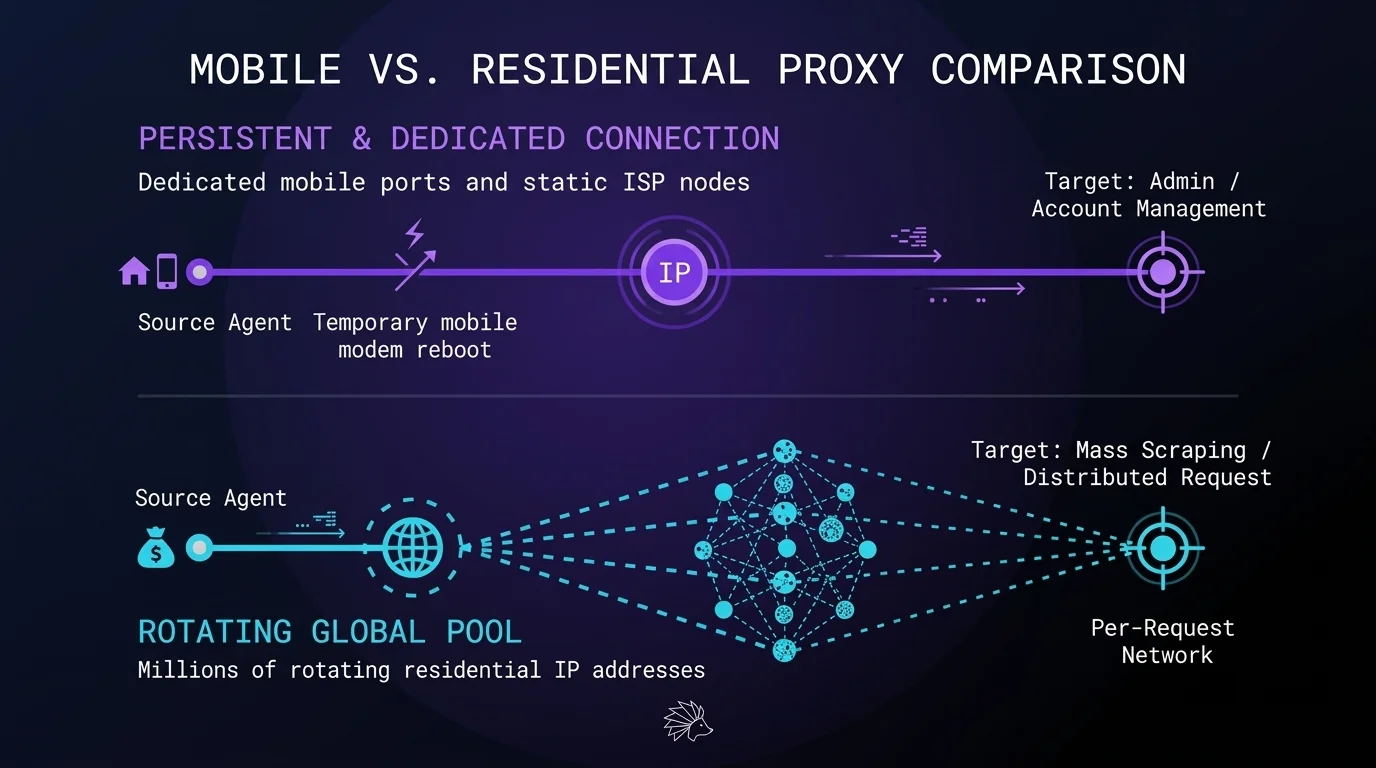
Proxy Mobile vs. Residential: Jenis IP Mana yang Unggul untuk Ekstraksi Data

Memilih infrastruktur IP yang optimal secara langsung membentuk arsitektur proyek Anda. Menulis kode Python yang sempurna tidak dapat mengimbangi jejak jaringan yang bertentangan dengan data aplikasi Anda. Algoritma pemfilteran modern menganalisis lapisan transport bersamaan dengan header browser standar. Alamat datacenter menyediakan throughput besar untuk platform publik, tetapi jaringan dengan proteksi tinggi memerlukan solusi yang berbeda. […]
Roman onSeptember 23, 2026

TLS Pasca-Kuantum: Standar Baru Deteksi Bot

Content delivery network kini mengevaluasi jabat tangan kriptografi, bukan mengandalkan cookie atau rotasi user…

TLS Pasca-Kuantum: Standar Baru Deteksi Bot 7 Waktu Baca:
Roman onSeptember 10, 2026

Memberi Makan Sistem RAG dalam Skala Besar: Cara Membersihkan Kebisingan DOM dan Merotasi Proxy untuk Ingesti LLM yang Bersih

Menargetkan situs web modern untuk melatih model AI dapat merusak pipeline ekstraksi data tradisional.…

7 Waktu Baca:
Roman onSeptember 7, 2026

Pengumpulan data web di 2026: Metode, alat, dan cara menskalakannya

Pelajari cara kerja pengumpulan data web, metode mana yang cocok untuk berbagai situs, alat…

Pengumpulan data web di 2026: Metode, alat, dan cara menskalakannya 10 Waktu Baca:
RO Roman onSeptember 10, 2026

Memberi Makan Sistem RAG dalam Skala Besar: Cara Membersihkan Kebisingan DOM dan Merotasi Proxy untuk Ingesti LLM yang Bersih

Menargetkan situs web modern untuk melatih model AI dapat merusak pipeline ekstraksi data tradisional. Anda mengarahkan browser headless ke katalog produk dinamis. Server target langsung menganalisis tanda tangan TLS Client Hello Anda. Server memeriksa urutan frame HTTP/2 Anda sebelum mengirimkan satu byte data pun. Jika koneksi Anda tidak memiliki ekosistem proxy yang kuat untuk otomatisasi […]

Temukan Lebih Banyak Lagi
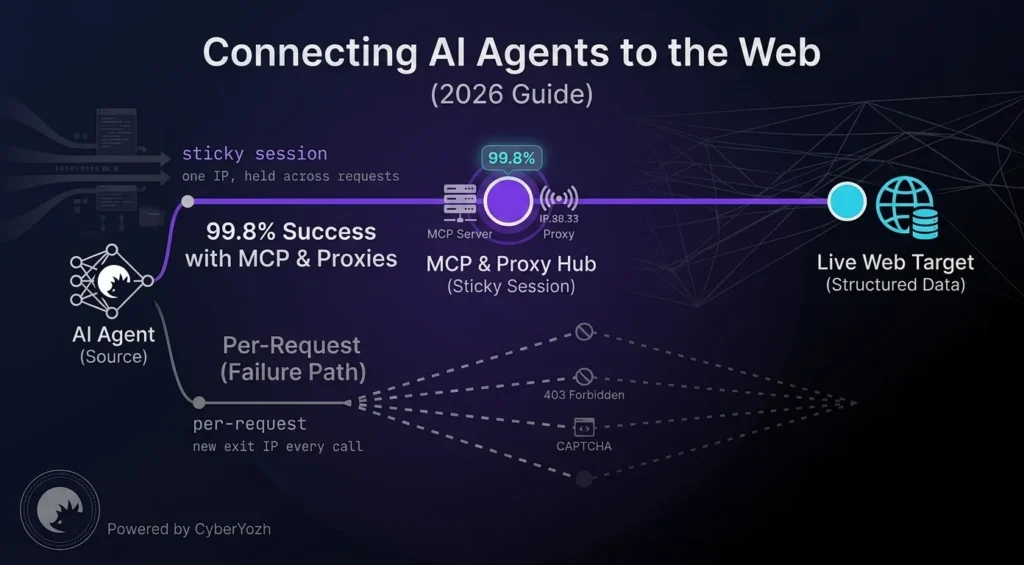
Menghubungkan Agen AI ke Web: Tingkat Keberhasilan 99,8% dengan Server MCP & Proxy (2026)
5 Waktu Baca:
RO Roman onAgustus 26, 2026

Menghubungkan Agen AI ke Web: Tingkat Keberhasilan 99,8% dengan Server MCP & Proxy (2026)

Jawaban Singkat: Model Context Protocol (MCP) berfungsi sebagai jembatan universal, memungkinkan agen AI (seperti Claude Desktop atau Cursor) untuk menjelajahi web secara langsung, merender JavaScript, dan mengekstrak data terstruktur. Namun, untuk mencegah pemblokiran IP dan CAPTCHA selama crawling web otomatis, agen AI harus merutekan permintaan mereka melalui proxy residensial atau seluler dengan tingkat kepercayaan tinggi […]

Temukan Lebih Banyak Lagi
RO Roman onAgustus 19, 2026

Playwright vs. Puppeteer untuk Scraping E-commerce: Mengapa Rotasi IP Cerdas adalah Pembeda Utama

Saat mengevaluasi Playwright vs Puppeteer untuk scraping e-commerce, para engineer sering terlalu terpaku pada kecepatan eksekusi dan sintaks API. Namun, pada tahun 2026, lanskap ekstraksi data telah berubah secara fundamental. Situs target menerapkan analisis perilaku yang agresif, TLS fingerprinting, dan mutasi DOM yang dinamis. Membangun pipeline yang mampu bertahan dari pertahanan ini membutuhkan jauh lebih […]

Temukan Lebih Banyak Lagi
RO Roman onAgustus 14, 2026

Pipeline Scraping yang Tangguh: Memperkenalkan LLM Self-Healing Parsing di Yozh Scraper

Ekstraksi data adalah lapisan fundamental dalam pengembangan kecerdasan buatan modern, intelijen pasar, dan analisis kompetitif. Namun, membangun pipeline data yang andal tetap menjadi hambatan rekayasa. Situs web target terus-menerus menerapkan perubahan struktural, pengujian A/B, dan obfuskasi dinamis, yang menyebabkan skrip ekstraksi kaku menjadi gagal. Untuk mengatasi paradigma kerapuhan ini, ekosistem web scraping memerlukan perubahan arsitektur […]

Temukan Lebih Banyak Lagi