★ 90 estrellas en GitHub y la cifra sigue aumentando. Yozh Crawler + Scraper es gratuito, de código abierto y se desarrolla de forma pública; danos una estrella si se gana un hueco en tu pila de herramientas.
RO Roman onoctubre 1, 2026

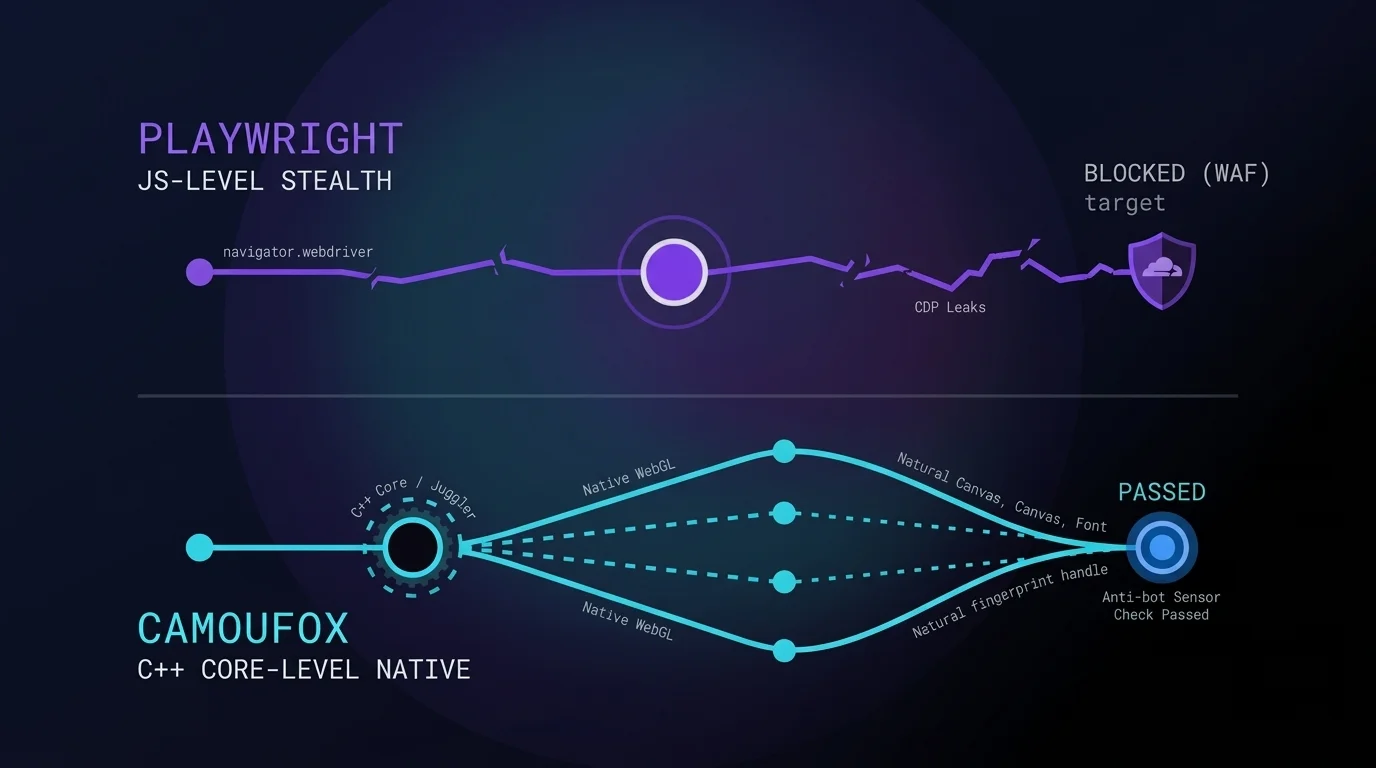
Playwright vs Camoufox: el futuro de la automatización de navegadores anti-detección

La seguridad en la extracción de datos ha cambiado. En 2026, Cloudflare y DataDome no dependen del análisis básico de user-agent. Estas plataformas evalúan la biometría del comportamiento junto con el fingerprinting TLS estructural (JA4). Los algoritmos de defensa también examinan el entorno en busca de manipulaciones de JavaScript. Los parches tradicionales de JavaScript fallan. […]
Roman onseptiembre 24, 2026

Proxies móviles vs. residenciales: qué tipo de IP gana para la extracción de datos

Seleccionar la infraestructura de IP óptima moldea directamente la arquitectura de tu proyecto. Escribir…

Proxies móviles vs. residenciales: qué tipo de IP gana para la extracción de datos 13 Tiempo de lectura:
Roman onseptiembre 23, 2026

TLS Post-Cuántico: El Nuevo Estándar de Detección de Bots

Las redes de distribución de contenido ahora evalúan el protocolo criptográfico en lugar de…

TLS Post-Cuántico: El Nuevo Estándar de Detección de Bots 9 Tiempo de lectura:
Roman onseptiembre 10, 2026

Alimentar sistemas RAG a gran escala: cómo eliminar el ruido del DOM y rotar proxies para una ingestión limpia en LLM

Apuntar a sitios web modernos para entrenar modelos de IA rompe los pipelines tradicionales…

9 Tiempo de lectura:
RO Roman onseptiembre 10, 2026

Alimentar sistemas RAG a gran escala: cómo eliminar el ruido del DOM y rotar proxies para una ingestión limpia en LLM

Apuntar a sitios web modernos para entrenar modelos de IA rompe los pipelines tradicionales de extracción de datos. Diriges un navegador headless hacia un catálogo de productos dinámico. El servidor de destino analiza instantáneamente la firma de tu TLS Client Hello. Verifica la secuencia de frames de HTTP/2 antes de enviar un solo byte de […]

Descubre más
7 Tiempo de lectura:
RO Roman onagosto 26, 2026

Conectando agentes de IA a la web: 99,8% de éxito con servidores MCP y proxies (2026)

Respuesta rápida: El Model Context Protocol (MCP) actúa como un puente universal que permite a los agentes de IA (como Claude Desktop o Cursor) navegar por la web en vivo, renderizar JavaScript y extraer datos estructurados. Sin embargo, para evitar baneos de IP y CAPTCHAs durante el crawling web automatizado, los agentes de IA deben […]

Descubre más
RO Roman onagosto 19, 2026

Playwright vs. Puppeteer para el scraping de e-commerce: por qué la rotación inteligente de IP es el factor diferenciador definitivo

Al evaluar Playwright frente a Puppeteer para el scraping de e-commerce, los ingenieros suelen obsesionarse con la velocidad de ejecución y la sintaxis de la API. Sin embargo, en 2026, el panorama de la extracción de datos ha cambiado radicalmente. Los sitios web objetivo despliegan análisis de comportamiento agresivos, fingerprinting TLS y mutaciones dinámicas del […]

Descubre más
RO Roman onagosto 14, 2026

Pipelines de scraping resilientes: presentamos el análisis autorreparable con LLM en Yozh Scraper

La extracción de datos es la capa fundamental del desarrollo moderno de inteligencia artificial, la inteligencia de mercado y el análisis competitivo. Sin embargo, construir pipelines de datos confiables sigue siendo un cuello de botella de ingeniería. Los sitios web objetivo despliegan continuamente mutaciones estructurales, pruebas A/B y ofuscación dinámica, lo que provoca que los […]

Descubre más