★ 89 estrellas en GitHub y la cifra sigue aumentando. Yozh Crawler + Scraper es gratuito, de código abierto y se desarrolla de forma pública; danos una estrella si se gana un hueco en tu pila de herramientas.

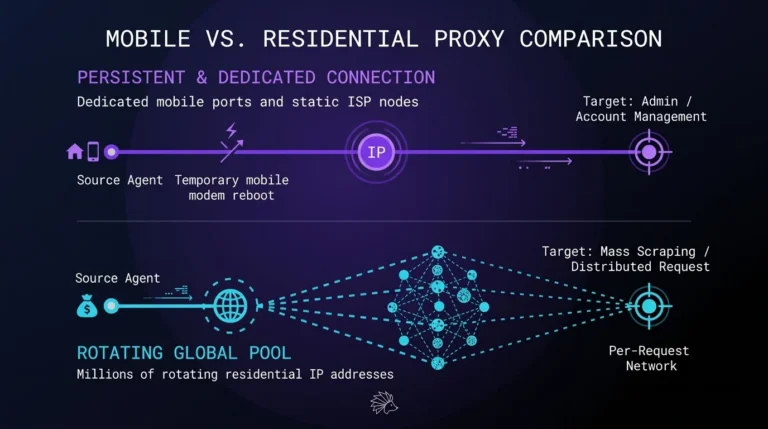
Proxies móviles vs. residenciales: qué tipo de IP gana para la extracción de datos

Seleccionar la infraestructura de IP óptima moldea directamente la arquitectura de tu proyecto. Escribir código Python impecable no puede compensar una huella de red que contradiga los datos de tu aplicación. Los algoritmos de filtrado modernos analizan la capa de transporte junto con los encabezados estándar del navegador. Las direcciones de centro de datos proporcionan […]
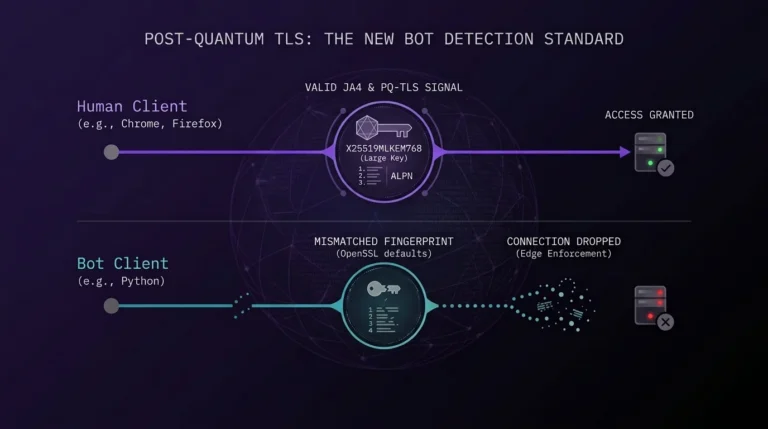
TLS Post-Cuántico: El Nuevo Estándar de Detección de Bots

Las redes de distribución de contenido ahora evalúan el protocolo criptográfico en lugar de depender de cookies o de la rotación de agentes de usuario. Los nodos de borde modernos inspeccionan la secuencia exacta de bytes en la solicitud de conexión inicial mucho antes de que el cliente transmita una carga útil HTTP. Si las […]

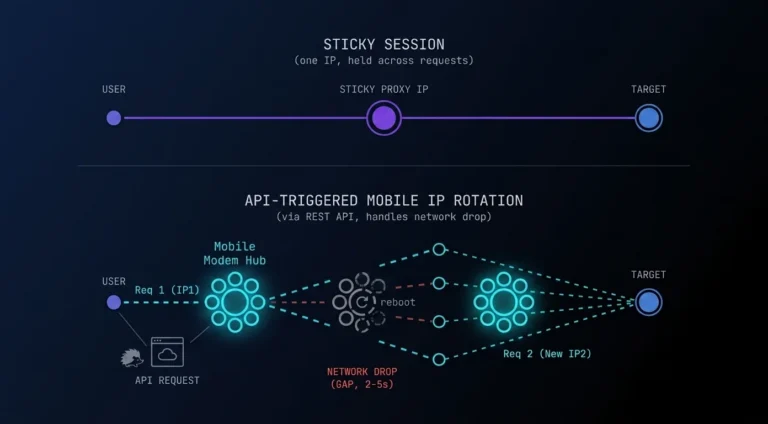
Automatización de Web Scraping con Python: Gestión de la rotación de IP móvil mediante solicitudes a la API REST

Resumen: Superando los cuellos de botella del navegador La automatización de navegadores conlleva una sobrecarga computacional considerable. Los navegadores headless consumen gigabytes de RAM. Renderizan elementos DOM innecesarios. Provocan picos en el uso de CPU durante tareas simples de extracción de datos. Los ingenieros de datos eventualmente alcanzan límites de escalabilidad estrictos al ejecutar cientos […]

Evolución de la infraestructura de red 2026: de SOCKS5 básico a redes móviles VLESS, XHTTP y XTLS-Reality

El protocolo SOCKS5 sigue siendo un estándar confiable de la industria. Funciona perfectamente en redes corporativas de confianza. Sin embargo, bajo un filtrado DPI estricto de los proveedores de internet locales, el SOCKS5 puro se vuelve vulnerable. Los sistemas de monitoreo reconocen sus firmas. Las conexiones se caen. Las empresas pierden ingresos. Los ingenieros de […]

Playwright vs. Puppeteer para el scraping de e-commerce: por qué la rotación inteligente de IP es el factor diferenciador definitivo

Al evaluar Playwright frente a Puppeteer para el scraping de e-commerce, los ingenieros suelen obsesionarse con la velocidad de ejecución y la sintaxis de la API. Sin embargo, en 2026, el panorama de la extracción de datos ha cambiado radicalmente. Los sitios web objetivo despliegan análisis de comportamiento agresivos, fingerprinting TLS y mutaciones dinámicas del […]