★ 89 звёзд на GitHub и продолжает расти. Yozh Crawler + Scraper — бесплатный, опенсорсный и создаётся публично — поставьте нам звезду, если он заслужил место в вашем стеке.
Мобильные или резидентские прокси: Что выбрать для сбора данных
3 мин чтения
RO Roman on24 сентября, 2026

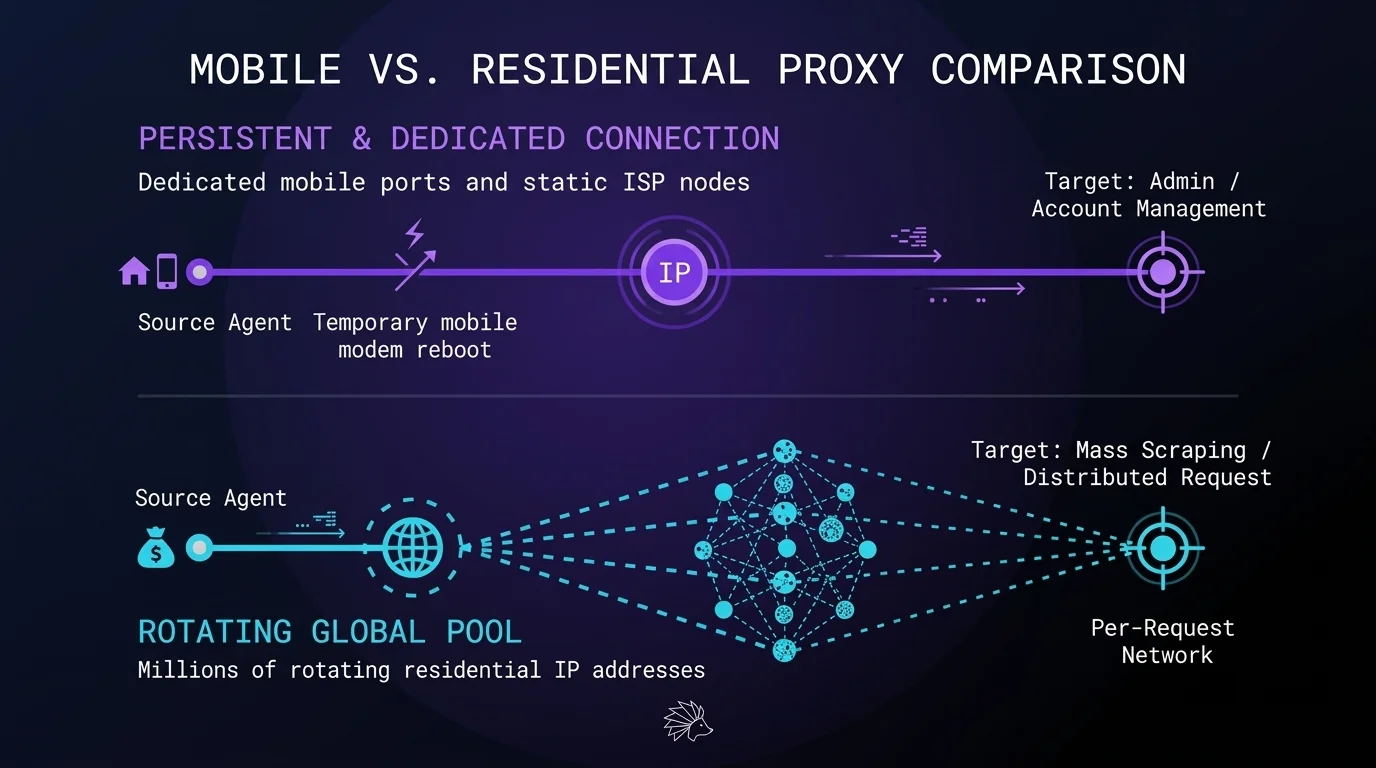
Мобильные или резидентские прокси: Что выбрать для сбора данных

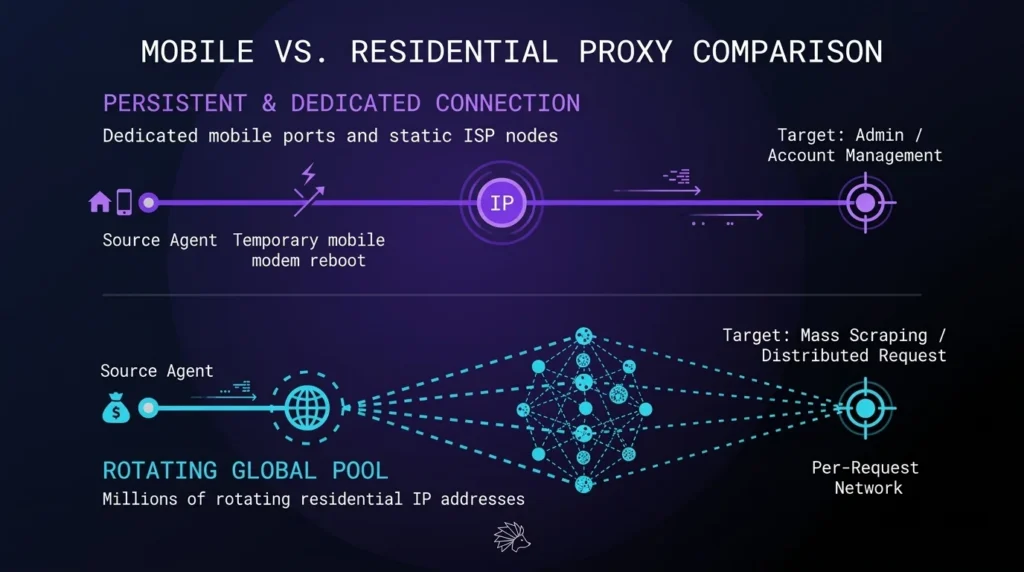
Выбор прокси для парсинга сайтов напрямую определяет архитектуру проекта. Современные алгоритмы проверяют не только заголовки User-Agent, но и транспортный уровень соединения. Датацентровые адреса обеспечивают отличную пропускную способность для открытых платформ, однако высокозащищенные сети требуют иных инфраструктурных решений. Инженеры сравнивают мобильные прокси и резидентские прокси, чтобы подобрать оптимальные IP-адреса, соответствующие естественному пользовательскому трафику. TL;DR: Основы сетевой […]
Roman on23 сентября, 2026

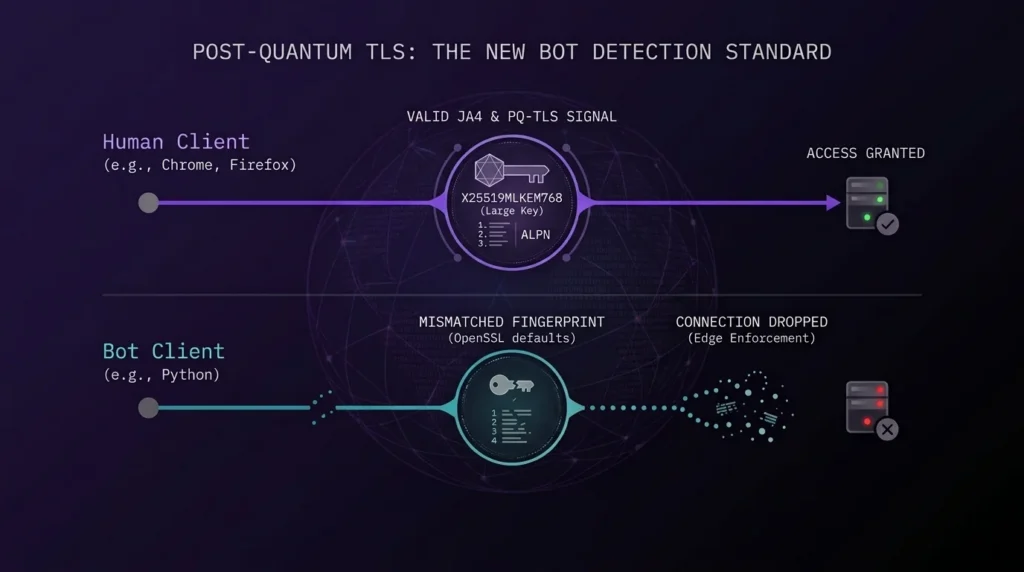
Настройка JA4 и TLS-отпечатков для стабильного сбора данных

Сетевые фильтры перестали доверять файлам cookie и заголовкам User-Agent. Сегодня системы защиты оценивают сам…

Настройка JA4 и TLS-отпечатков для стабильного сбора данных 3 мин чтения
Roman on10 сентября, 2026

Масштабирование RAG-систем: Очистка DOM-дерева и правильные MCP прокси для парсинга

Современные целевые сайты безжалостно отклоняют автоматизированные запросы. Вы запускаете краулер для сбора данных с…

3 мин чтения
Roman on7 сентября, 2026

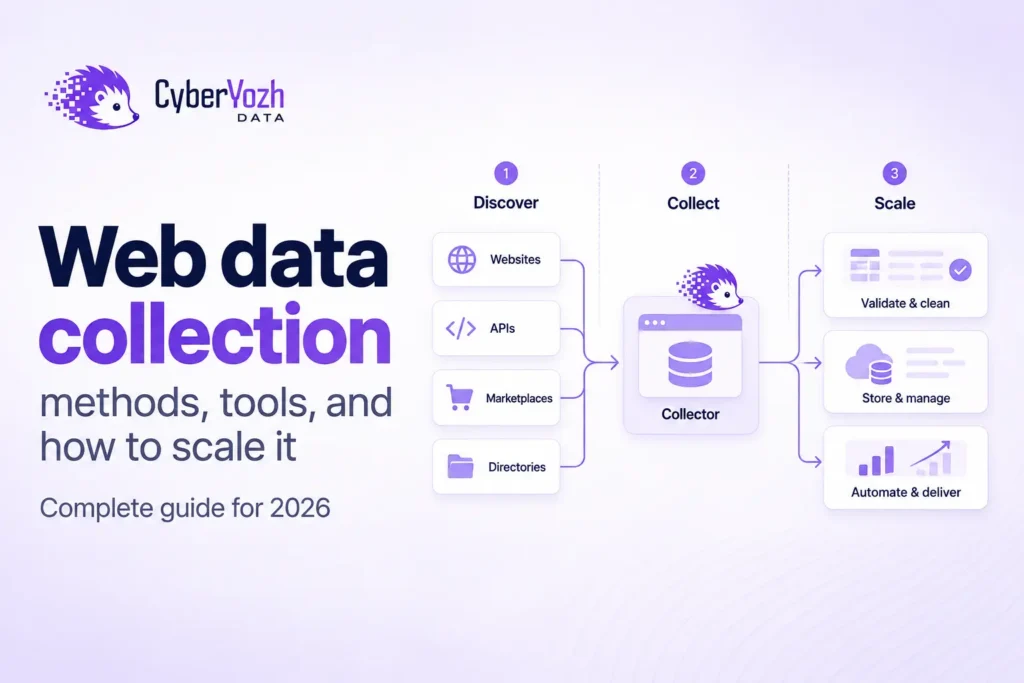
Сбор данных с сайтов в 2026 году: методы, инструменты и как масштабировать процесс

Узнайте, как устроен сбор данных с веб-сайтов, какие методы подходят для разных сайтов, какие…

Сбор данных с сайтов в 2026 году: методы, инструменты и как масштабировать процесс 3 мин чтения
Мобильные или резидентские прокси: Что выбрать для сбора данных
3 мин чтения
RO Roman on24 сентября, 2026

Мобильные или резидентские прокси: Что выбрать для сбора данных

Выбор прокси для парсинга сайтов напрямую определяет архитектуру проекта. Современные алгоритмы проверяют не только заголовки User-Agent, но и транспортный уровень соединения. Датацентровые адреса обеспечивают отличную пропускную способность для открытых платформ, однако высокозащищенные сети требуют иных инфраструктурных решений. Инженеры сравнивают мобильные прокси и резидентские прокси, чтобы подобрать оптимальные IP-адреса, соответствующие естественному пользовательскому трафику. TL;DR: Основы сетевой […]
Узнать больше
Настройка JA4 и TLS-отпечатков для стабильного сбора данных
3 мин чтения
RO Roman on23 сентября, 2026

Настройка JA4 и TLS-отпечатков для стабильного сбора данных

Сетевые фильтры перестали доверять файлам cookie и заголовкам User-Agent. Сегодня системы защиты оценивают сам процесс установки соединения, анализируя каждый байт еще до получения HTTP-запроса. Если вы используете стандартные библиотеки вроде Python requests, сервер моментально сбрасывает коннект или выдает ошибку 403. Стабильное извлечение данных теперь полностью зависит от правильной генерации сетевых пакетов на уровне криптографии. TL;DR: […]

Узнать больше
RO Roman on10 сентября, 2026

Масштабирование RAG-систем: Очистка DOM-дерева и правильные MCP прокси для парсинга

Современные целевые сайты безжалостно отклоняют автоматизированные запросы. Вы запускаете краулер для сбора данных с товарного каталога. Система защиты моментально сканирует ваш TLS-отпечаток. Она проверяет порядок следования служебных фреймов HTTP/2 до начала загрузки контента. Серверные адреса дают отличную скорость для открытых API. Однако агрессивные системы защиты потребительских маркетплейсов часто сбрасывают такие соединения. Прохождение первичного сетевого фильтра […]

Узнать больше
Сбор данных с сайтов в 2026 году: методы, инструменты и как масштабировать процесс
3 мин чтения
RO Roman on7 сентября, 2026

Сбор данных с сайтов в 2026 году: методы, инструменты и как масштабировать процесс

Узнайте, как устроен сбор данных с веб-сайтов, какие методы подходят для разных сайтов, какие инструменты для этого нужны и как автоматизировать надёжный сбор данных в промышленных масштабах.

Узнать больше
Автоматизированный веб-скрапинг с Python: Обработка ротации мобильных IP через REST API
3 мин чтения
RO Roman on4 сентября, 2026

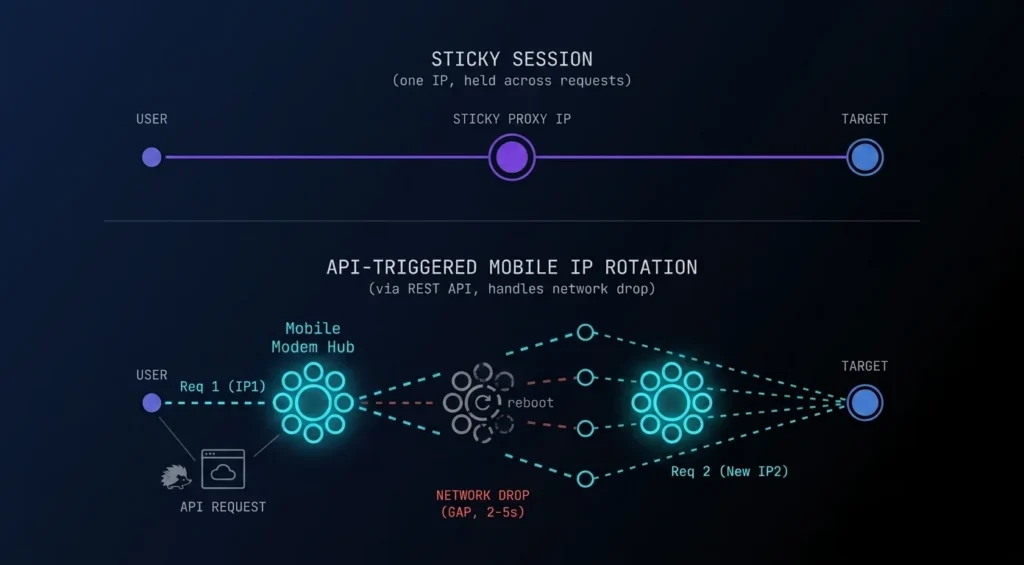
Автоматизированный веб-скрапинг с Python: Обработка ротации мобильных IP через REST API

TL;DR: Отказ от тяжёлых браузеров Браузерная автоматизация несёт колоссальные вычислительные издержки. Безголовые браузеры потребляют гигабайты оперативной памяти. Они рендерят ненужные элементы DOM-дерева. Они вызывают пиковые нагрузки на процессор при выполнении простых задач по сбору данных. Дата-инженеры рано или поздно сталкиваются с жёсткими аппаратными лимитами, пытаясь запустить сотни инстансов Selenium или Playwright. Перенос логики напрямую в […]

Узнать больше
RO Roman on19 августа, 2026

Подводные камни при скрапинге: Playwright vs Puppeteer и почему ротация IP решает всё

Когда команды выбирают, что использовать: Playwright или Puppeteer для парсинга, они часто фокусируются на синтаксисе и скорости выполнения кода. Но ландшафт сбора данных кардинально изменился. Целевые веб-сайты используют агрессивный поведенческий анализ, проверку TLS-отпечатков и динамические мутации DOM-дерева. Чтобы ваш конвейер выжил в таких условиях, одного лишь фреймворка недостаточно. TL;DR: Playwright или Puppeteer для парсинга E-commerce […]

Узнать больше