在 GitHub 已获得 88 个星标,且数量仍在增加。Yozh Crawler + Scraper 是一款免费、开源且公开开发的工具——如果它能成为您技术栈中的一员,请给我们点个星标
3 预计阅读时间
RO Roman on10 9 月, 2026

大规模投喂 RAG 系统:如何剥离 DOM 噪声并轮换代理以实现干净的 LLM 数据摄取

针对现代网站进行 AI 模型训练会破坏传统的数据提取流程。你用无头浏览器访问一个动态商品目录,目标服务器会立即 […]
Roman on7 9 月, 2026

2026年的网络数据采集:方法、工具及如何实现规模化

了解网络数据采集的工作原理、…

2026年的网络数据采集:方法、工具及如何实现规模化 3 预计阅读时间
Roman on4 9 月, 2026

使用 Python 进行自动化网页抓取:通过 REST API 请求处理移动 IP 轮换

摘要:克服浏览器瓶颈 浏览器…

使用 Python 进行自动化网页抓取:通过 REST API 请求处理移动 IP 轮换 3 预计阅读时间
Roman on3 9 月, 2026

2026网络基础设施演进:从基础SOCKS5到移动VLESS、XHTTP和XTLS-Reality网络

SOCKS5协议仍是可靠的行…

3 预计阅读时间
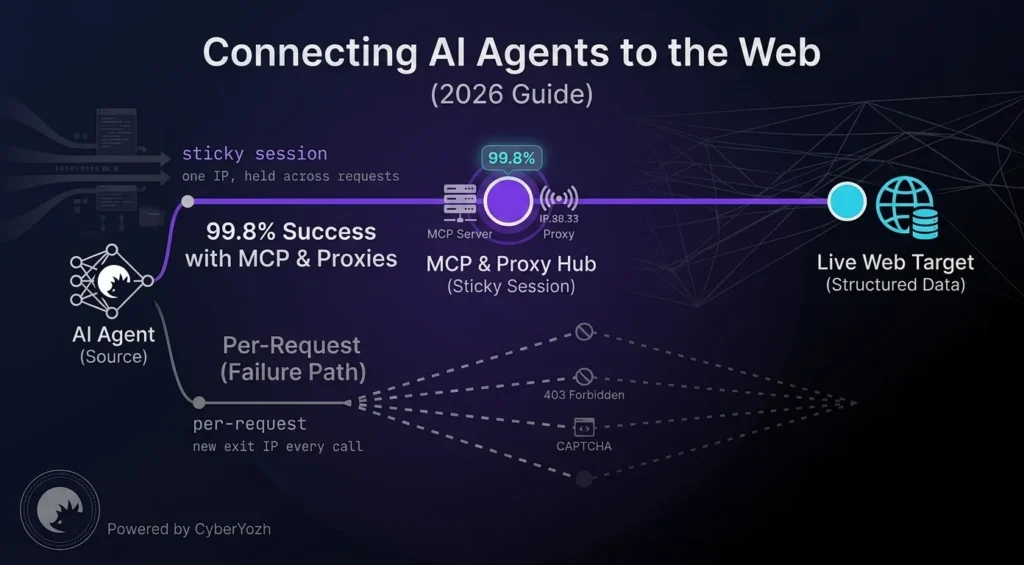
将AI智能体连接到互联网:使用MCP服务器与代理实现99.8%的成功率(2026年)
3 预计阅读时间
RO Roman on26 8 月, 2026

将AI智能体连接到互联网:使用MCP服务器与代理实现99.8%的成功率(2026年)

快速答案:模型上下文协议(MCP)充当通用桥梁,使AI智能体(如Claude Desktop或Cursor)能 […]

了解更多
3 预计阅读时间
RO Roman on19 8 月, 2026

Playwright 与 Puppeteer 在电商爬取中的对比:为什么智能 IP 轮换是终极差异化因素

在评估用于电商爬取的 Playwright 与 Puppeteer 时,工程师往往过分关注执行速度和 API […]

了解更多
用于潜在客户开发的网页抓取:2026年完全指南
3 预计阅读时间
RO Roman on14 8 月, 2026

用于潜在客户开发的网页抓取:2026年完全指南

一份构建可靠潜在客户开发网页抓取工作流的实用指南,涵盖从发现公开商业数据、爬取、提取、验证、代理选择到生成可直接导入 CRM 的输出的全过程。

了解更多
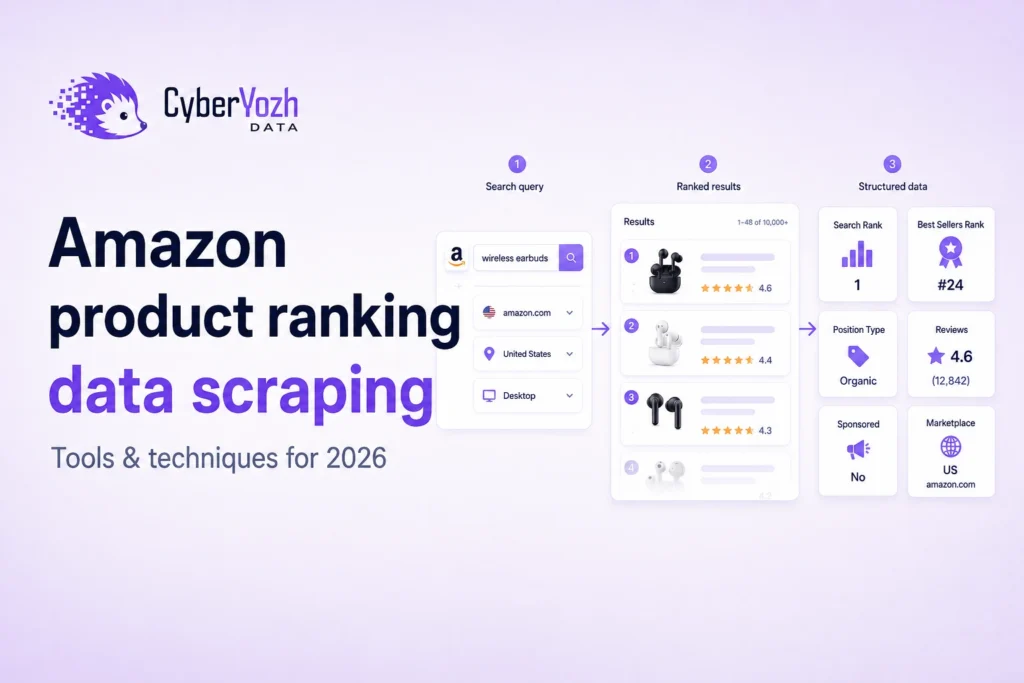
2026年最佳亚马逊产品排名数据抓取工具与技术
3 预计阅读时间
RO Roman on14 8 月, 2026

2026年最佳亚马逊产品排名数据抓取工具与技术

一份实用指南,介绍如何使用 CyberYozh Data 采集亚马逊搜索排名、畅销商品排名(BSR)、评论、价格及竞品数据,同时保留市场、地区、时间戳和排名上下文信息。

了解更多
3 预计阅读时间
RO Roman on14 8 月, 2026

弹性抓取管道:Yozh Scraper 推出 LLM 自愈解析功能

数据提取是现代人工智能开发、市场情报和竞争分析的基础层。然而,构建可靠的数据管道仍然是一个工程瓶颈。目标网站不 […]

了解更多
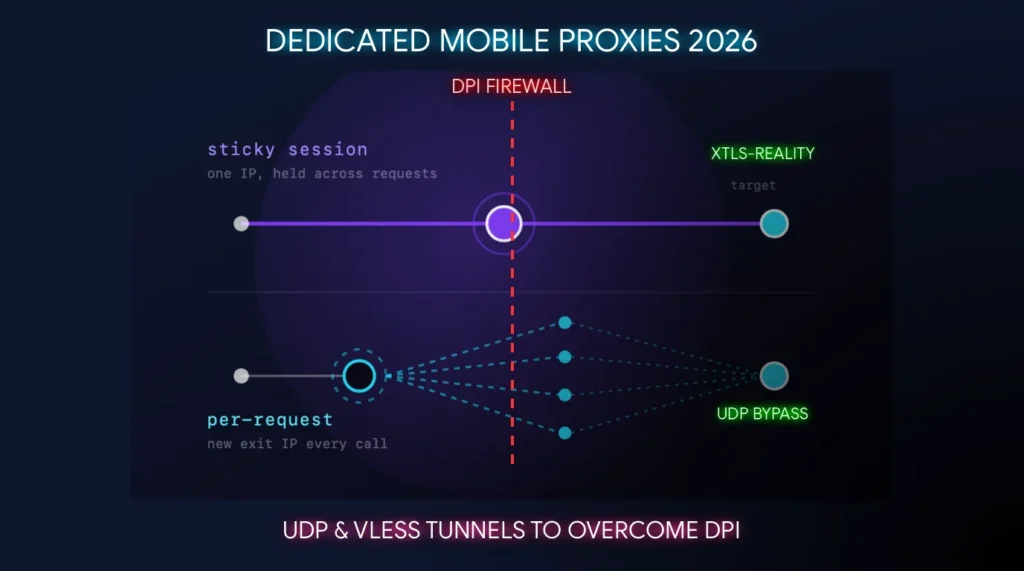
2026年专用移动代理:为何UDP与VLESS隧道是突破DPI的必要条件
3 预计阅读时间
RO Roman on7 8 月, 2026

2026年专用移动代理:为何UDP与VLESS隧道是突破DPI的必要条件

深度包检测(DPI)系统会主动扫描并丢弃标准VPN连接。OpenVPN和WireGuard会在几分钟内失效。这 […]

了解更多