


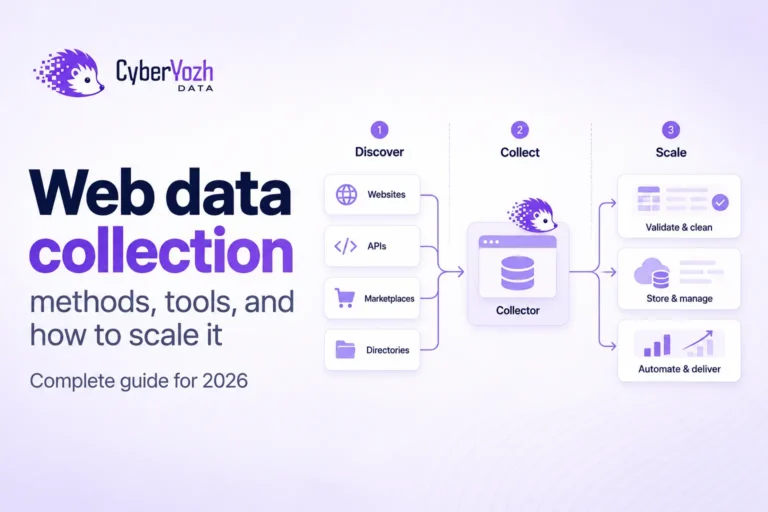
Збір даних із вебу у 2026 році: методи, інструменти та масштабування
Дізнайтеся, як працює збір даних з вебсайтів, які методи підходять для різних сайтів, які інструменти потрібні та як автоматизувати надійний збір даних у великих масштабах.
Дізнайтеся, як працює збір даних з вебсайтів, які методи підходять для різних сайтів, які інструменти потрібні та як автоматизувати надійний збір даних у великих масштабах.
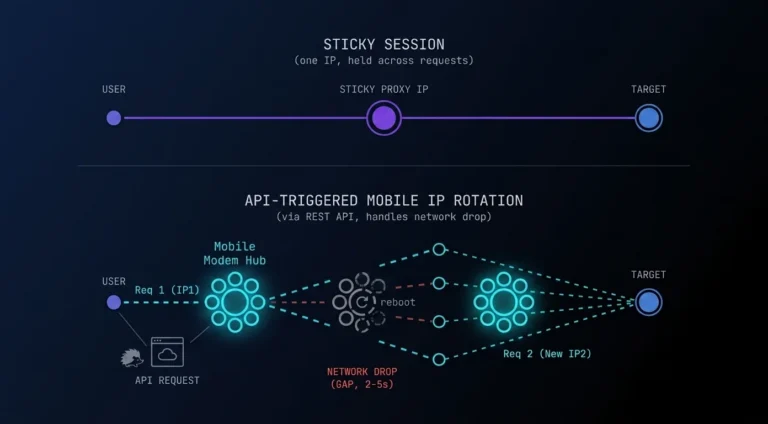
TL;DR: Відмова від важких браузерів Браузерна автоматизація несе колосальні обчислювальні витрати. Безголові браузери потребують гігабайтів оперативної пам’яті. Вони рендерять непотрібні елементи DOM-дерева. Вони викликають пікові навантаження на процесор при виконанні простих завдань зі збору даних. Дата-інженери рано чи пізно стикаються з жорсткими апаратними лімітами, намагаючись запустити сотні інстансів Selenium або Playwright. Перенесення логіки в скрипти […]
Коли команди вибирають, що використовувати: Playwright чи Puppeteer для парсингу, вони часто зосереджуються на синтаксисі та швидкості виконання коду. Але ландшафт збору даних кардинально змінився. Цільові веб-сайти застосовують агресивний поведінковий аналіз, перевірку TLS-відбитків і динамічні мутації DOM-дерева. Щоб ваш конвеєр вижив у таких умовах, самого лише фреймворка недостатньо. TL;DR: Playwright чи Puppeteer для парсингу E-commerce […]
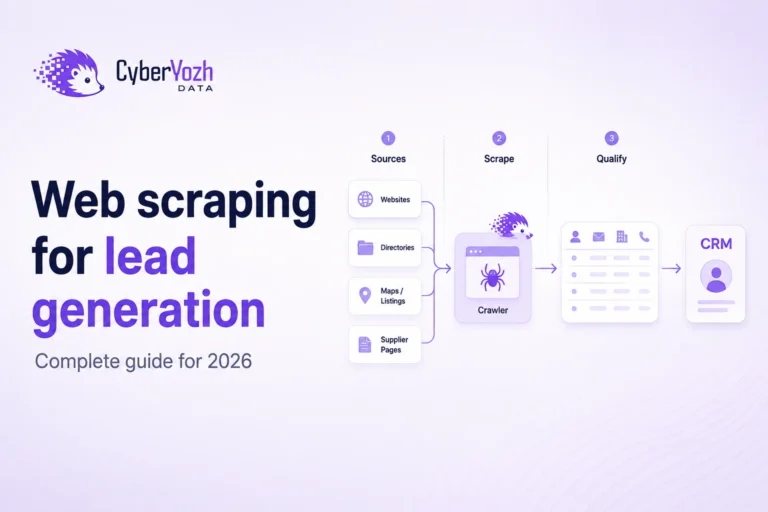
Практичний гайд зі створення надійного процесу скрейпингу для лідогенерації: від пошуку публічних бізнес-даних до краулінгу, вилучення даних, валідації, вибору проксі та підготовки виводу, готового для CRM.
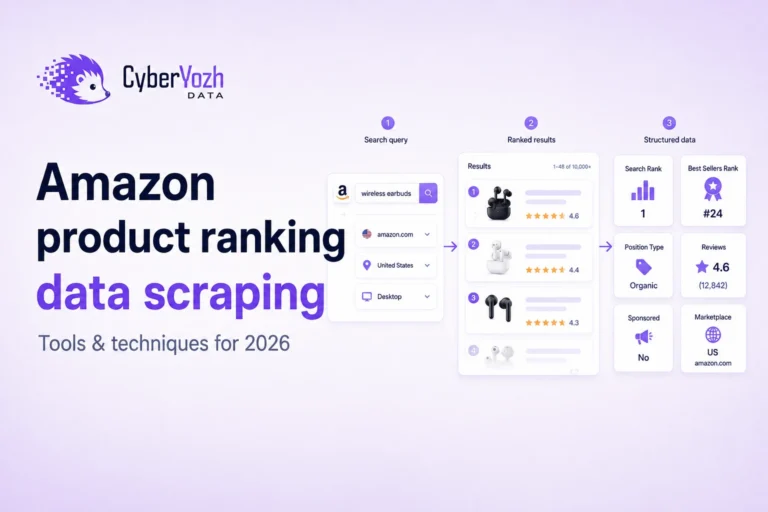
Практичний гайд зі збору даних про позиції в пошуку Amazon, Best Sellers Rank, відгуки, ціни та дані конкурентів за допомогою CyberYozh Data зі збереженням контексту маркетплейсу, локації, часової мітки та рейтингу.
Збір веб-даних — фундаментальна основа для розробки сучасного штучного інтелекту, маркетингової аналітики та конкурентної розвідки. Однак створення надійних конвеєрів даних залишається головним інженерним викликом. Цільові веб-сайти постійно впроваджують структурні зміни, проводять A/B-тестування та використовують динамічну обфускацію, через що жорсткі скрипти збору даних неминуче ламаються. Для розв’язання цієї проблеми крихкості екосистема веб-скрейпингу потребує фундаментального архітектурного зсуву. […]

Порівняйте Instant Data Scraper із CyberYozh і дізнайтеся, коли стають необхідними масштабовані краулери, ротація проксі, геотаргетинг, сесії та автоматизація.