88 звёзд на GitHub и продолжает расти. Yozh Crawler + Scraper — бесплатный, опенсорсный и создаётся публично — поставьте нам звезду, если он заслужил место в вашем стеке.
web data collection methods

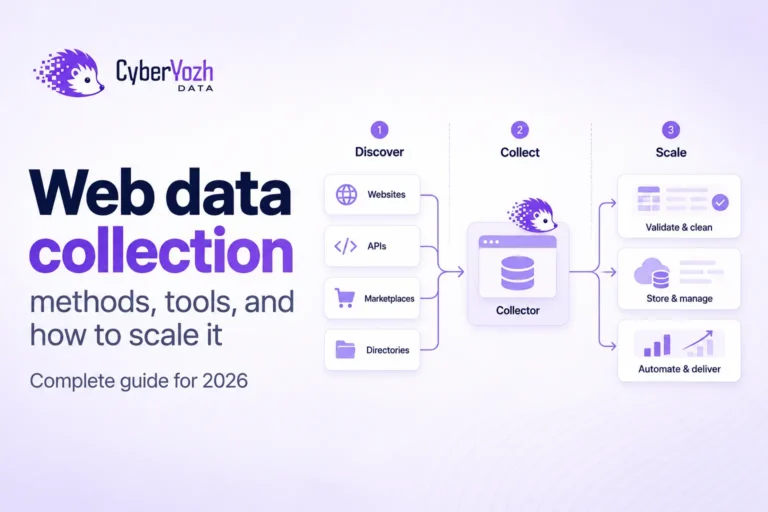
Сбор данных с сайтов в 2026 году: методы, инструменты и как масштабировать процесс

Узнайте, как устроен сбор данных с веб-сайтов, какие методы подходят для разных сайтов, какие инструменты для этого нужны и как автоматизировать надёжный сбор данных в промышленных масштабах.
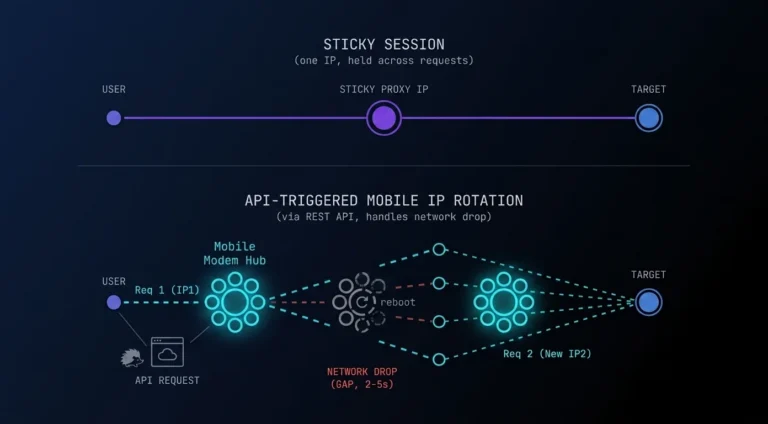
Автоматизированный веб-скрапинг с Python: Обработка ротации мобильных IP через REST API

TL;DR: Отказ от тяжёлых браузеров Браузерная автоматизация несёт колоссальные вычислительные издержки. Безголовые браузеры потребляют гигабайты оперативной памяти. Они рендерят ненужные элементы DOM-дерева. Они вызывают пиковые нагрузки на процессор при выполнении простых задач по сбору данных. Дата-инженеры рано или поздно сталкиваются с жёсткими аппаратными лимитами, пытаясь запустить сотни инстансов Selenium или Playwright. Перенос логики напрямую в […]

Подводные камни при скрапинге: Playwright vs Puppeteer и почему ротация IP решает всё

Когда команды выбирают, что использовать: Playwright или Puppeteer для парсинга, они часто фокусируются на синтаксисе и скорости выполнения кода. Но ландшафт сбора данных кардинально изменился. Целевые веб-сайты используют агрессивный поведенческий анализ, проверку TLS-отпечатков и динамические мутации DOM-дерева. Чтобы ваш конвейер выжил в таких условиях, одного лишь фреймворка недостаточно. TL;DR: Playwright или Puppeteer для парсинга E-commerce […]

Скрейпинг для генерации лидов: полный гайд на 2026 год

Практический гайд по построению надёжного процесса парсинга лидов: от поиска публичных бизнес-данных до краулинга, извлечения, валидации, выбора прокси и получения данных, готовых к загрузке в CRM.

amazon-web-scraping

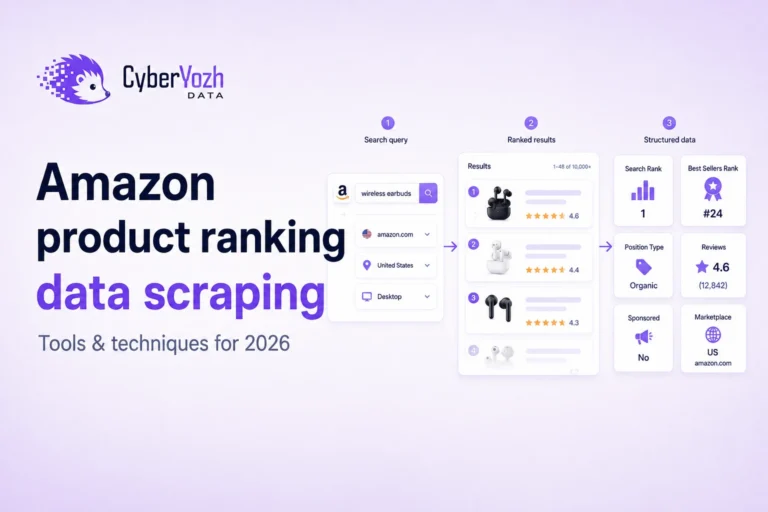
Лучшие инструменты и техники скрейпинга данных о рейтинге товаров Amazon в 2026 году

Практический гайд по сбору рейтингов поиска Amazon, Best Sellers Rank, отзывов, цен и данных о конкурентах с помощью CyberYozh Data с сохранением контекста маркетплейса, локации, времени и позиции в рейтинге.

Внедрение LLM-парсинга с самовосстановлением в Yozh Scraper

Сбор веб-данных является фундаментальным уровнем для разработки современного искусственного интеллекта, маркетинговой аналитики и конкурентной разведки. Однако создание надежных конвейеров данных остается главным инженерным узким местом. Целевые веб-сайты постоянно внедряют структурные изменения, проводят A/B-тестирования и используют динамическую обфускацию, из-за чего скрипты сбора данных неизбежно ломаются. Для решения этой проблемы хрупкости экосистема веб-скрапинга требует фундаментального архитектурного сдвига. […]