88 bintang di GitHub dan terus bertambah. Yozh Crawler + Scraper adalah perangkat lunak gratis, sumber terbuka, dan dikembangkan secara terbuka — berikan kami bintang jika alat ini layak masuk ke dalam tumpukan teknologi Anda.

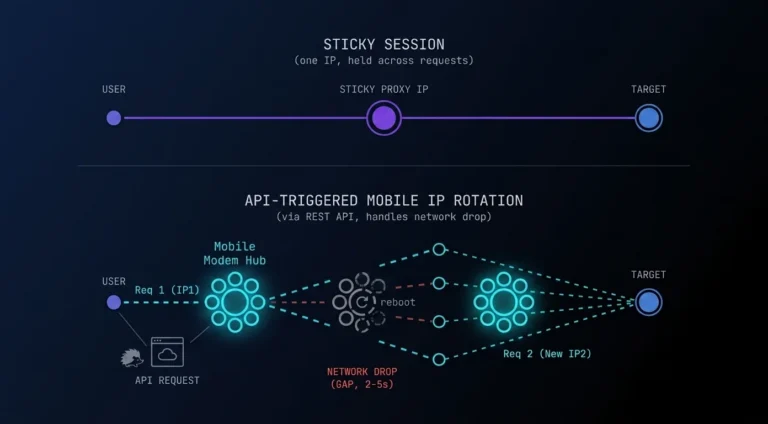
Web Scraping Otomatis dengan Python: Menangani Rotasi IP Mobile melalui Permintaan REST API

TL;DR: Mengatasi bottleneck browser Otomasi browser membawa overhead komputasi yang sangat besar. Browser headless mengonsumsi gigabyte RAM. Browser tersebut merender elemen DOM yang tidak diperlukan. CPU melonjak selama tugas ekstraksi data sederhana. Data engineer akhirnya mencapai batas penskalaan yang keras saat menjalankan ratusan instance Selenium atau Playwright. Memindahkan logika Anda langsung ke skrip tingkat HTTP […]

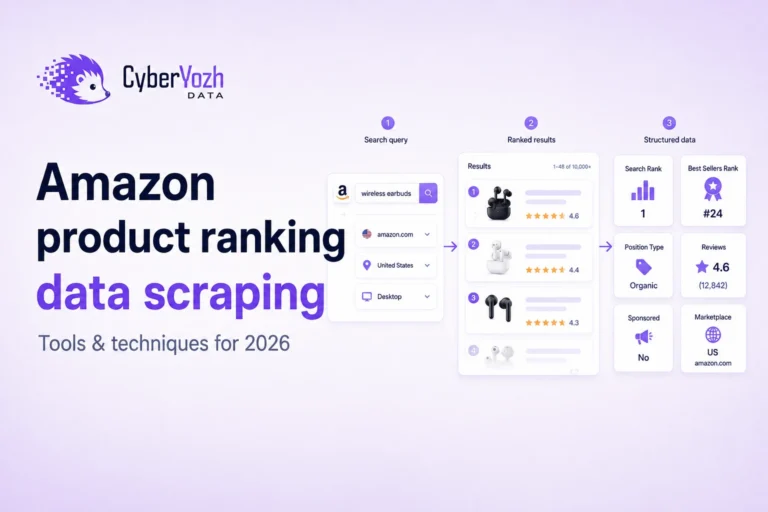
Playwright vs. Puppeteer untuk Scraping E-commerce: Mengapa Rotasi IP Cerdas adalah Pembeda Utama

Saat mengevaluasi Playwright vs Puppeteer untuk scraping e-commerce, para engineer sering terlalu terpaku pada kecepatan eksekusi dan sintaks API. Namun, pada tahun 2026, lanskap ekstraksi data telah berubah secara fundamental. Situs target menerapkan analisis perilaku yang agresif, TLS fingerprinting, dan mutasi DOM yang dinamis. Membangun pipeline yang mampu bertahan dari pertahanan ini membutuhkan jauh lebih […]

lead generation web scraping, web scraping for ecommerce, headers for web scraping, best Python tools for web scraping

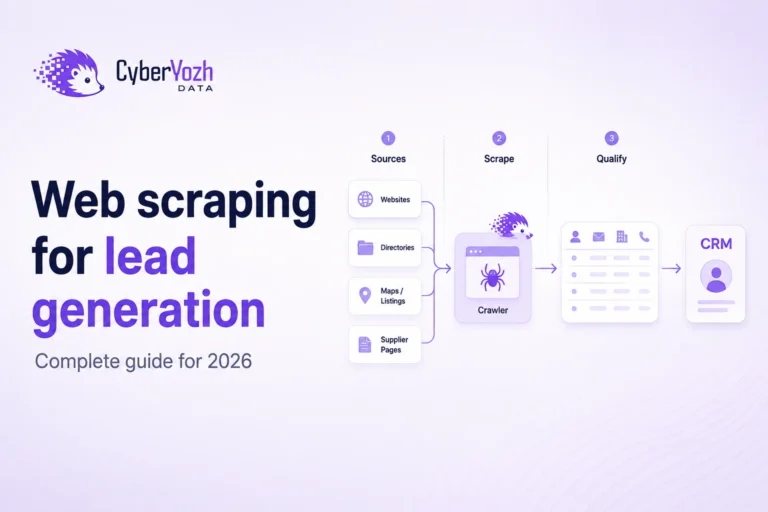
Web scraping untuk lead generation: Panduan lengkap 2026

Panduan praktis untuk membangun alur kerja web scraping lead generation yang andal, mulai dari menemukan data bisnis publik hingga crawling, ekstraksi, validasi, pemilihan proxy, dan output yang siap dipakai di CRM.

Pipeline Scraping yang Tangguh: Memperkenalkan LLM Self-Healing Parsing di Yozh Scraper

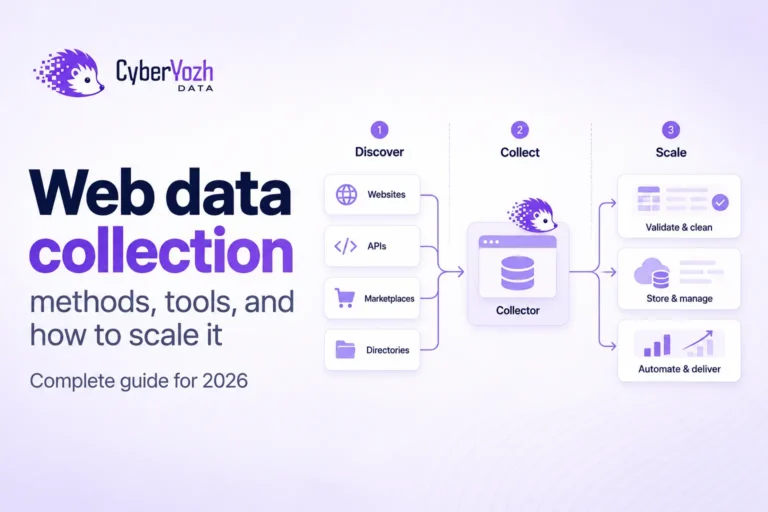
Ekstraksi data adalah lapisan fundamental dalam pengembangan kecerdasan buatan modern, intelijen pasar, dan analisis kompetitif. Namun, membangun pipeline data yang andal tetap menjadi hambatan rekayasa. Situs web target terus-menerus menerapkan perubahan struktural, pengujian A/B, dan obfuskasi dinamis, yang menyebabkan skrip ekstraksi kaku menjadi gagal. Untuk mengatasi paradigma kerapuhan ini, ekosistem web scraping memerlukan perubahan arsitektur […]