88 bintang di GitHub dan terus bertambah. Yozh Crawler + Scraper adalah perangkat lunak gratis, sumber terbuka, dan dikembangkan secara terbuka — berikan kami bintang jika alat ini layak masuk ke dalam tumpukan teknologi Anda.
v0.1.13 · Yozh Crawler sudah hadir

Pengambilan
data web yang mudah untuk agen
AI dan manusia

Salah satu alat sumber terbuka untuk pengumpulan dan penggalian data. Mulailah dari satu URL, jelajahi situs tersebut, dan peroleh data terstruktur seiring dimuatnya halaman-halaman. Dapat digunakan bersama MCP dan alat-alat seperti Claude dan Cursor, serta dilengkapi dengan pengaturan siap pakai untuk platform pasar seperti Amazon dan eBay.

88 Bintang di GitHub
MIT Lisensi · Gratis selamanya
v0.1.13 Rilis terbaru
Open Scraper Tester
Scraper URL http://localhost:8000 Check ok Crawler URL http://localhost:8001 Check ok CyberYozh API Docs ↗ Get API Key ↗
Scrape Page
Batch Scrape
Crawler
Jobs
MCP
Crawl Parameters
Seed URL *
Scope Mode
same-domain
Max Depth
3
Max Pages
47
Per-domain RPS
1.0
Per-domain
1
Include Patterns (regex, one per line)
^https://amazon\.co\.uk/dp/
Exclude Patterns (regex, one per line)
/cart|/account|/checkout
Crawl Proxy⚠ crawl proxy=none — no IP rotation
Proxy Type
none
Enable scraping (keep raw_html / screenshot / extracted data per page)
Result
crawl_________________ · status: idle · visited: 0 / 30 · queued: 0 · failed: 0 · dedup: 0
Crawl progress and pages will appear here...
Apa yang baru · v0.1.13

Jelajahi seluruh situs web dan peroleh datanya dalam satu kali proses

Yozh Crawler memetakan seluruh struktur situs dan memproses halaman-halaman yang ditemukan. Anda akan mendapatkan cakupan yang luas serta hasil yang dapat dimanfaatkan dalam satu kali proses, tanpa perlu mengelola langkah-langkah perayapan dan penggalian data secara terpisah. Alat ini dapat diintegrasikan langsung ke dalam alur kerja pengumpulan data dan penggalian data yang sudah ada.

Yozh Crawler, terintegrasi NEW

Mulailah dari satu URL dan peta seluruh situs. Halaman-halaman akan terdeteksi dan diproses dalam satu kali proses, sehingga Anda mendapatkan cakupan penuh tanpa perlu langkah tambahan.

Mode Penjelajahan NEW

Hanya butuh tautan? Beralihlah ke mode penjelajahan dan petakan situs tanpa melakukan parsing. Lebih cepat, lebih ringan, dan berguna untuk audit serta pemeriksaan struktur.

Browser tersembunyi

Menyesuaikan header, lokasi, dan sinyal browser dengan proxy Anda. Membantu menjaga konsistensi sesi di berbagai wilayah.

Pengambilan data secara batch

Jalankan ratusan URL dalam satu permintaan. Proses semuanya secara paralel dengan satu hasil yang rapi.

Pembatalan dua tahap NEW

Hentikan proses tanpa mengganggu hasil. Biarkan halaman yang sedang aktif menyelesaikan prosesnya, atau hentikan semuanya secara instan jika diperlukan.

Integrasi MCP

Terhubung langsung dengan alat-alat seperti Claude dan Cursor. Gunakan teknik scraping dan crawling sebagai bagian dari alur kerja yang sudah ada.

10 preset bawaan

Amazon, eBay, Walmart, Google, Google Shopping, YouTube, LinkedIn, Bing, Yandex — cukup masukkan nama sumber dan parameternya, lalu dapatkan respons yang telah dinormalisasi. Tidak perlu menulis selektor.

Fitur pemulihan otomatis LLM NEW

Sebuah situs melakukan perubahan tata letak, dan selektor CSS Anda mengembalikan hasil kosong? Parser meminta LLM (OpenAI / Anthropic / Gemini / OpenRouter) untuk membuat ulang selektor tersebut secara instan. Pipeline tetap berjalan.

Preset yang dihasilkan oleh AI NEW

Butuh situs yang belum kami sediakan preset-nya? Jelaskan apa yang ingin diekstraksi dan tempelkan URL contoh — POST /api/v1/presets/generate akan mengembalikan JSON preset yang siap pakai.

Sesi yang terotentikasi NEW

Masuk sekali saja melalui DSL deklaratif (goto / fill / click / wait) atau tempelkan cookie yang telah diekspor. Gunakan kembali sesi tersebut pada setiap proses pengambilan data. Diperlukan untuk target yang dibatasi aksesnya, seperti preset LinkedIn.

Antarmuka

Infrastruktur scraping sederhana yang dapat Anda kendalikan

Atur alur kerja Anda di satu tempat dan jalankan sesuai kebutuhan Anda. Semuanya jelas, teratur, dan mudah dikelola tanpa perlu alat tambahan.

1

Proksi bawaan, siap digunakan

Akses proxy perumahan, seluler, dan pusat data di lebih dari 120 negara. Tersedia lebih dari 50 juta alamat IP dengan tingkat ketersediaan 99,9%. Dilengkapi dengan dukungan fingerprinting untuk menyelaraskan perilaku perangkat, peramban, dan jaringan guna memastikan sesi yang stabil dan kontrol yang lebih baik.

2

Ekstraksi data yang fleksibel

Gunakan selektor CSS, XPath, atau fitur deteksi otomatis untuk situs-situs populer. Dapatkan data JSON yang rapi dan terstruktur tanpa perlu pengaturan yang rumit.

3

Semua data terpusat di satu tempat

Dapatkan kode HTML mentah, tangkapan layar, dan data yang telah diolah dalam satu tempat. Semua yang Anda butuhkan, tanpa perlu berpindah-pindah antar alat.

4

Pengendalian yang sederhana dan akses ke MCP

Hentikan tugas kapan saja hanya dengan satu klik dan beralih antara mode scraper dan crawler. Alur kerja Anda tetap sederhana dan tetap dalam kendali Anda.

MCP · Protokol Konteks Model

Agen AI yang dirancang untuk web scraping dan crawling

Hubungkan Yozh Crawler dan Yozh Scraper ke Claude, Cursor, atau klien MCP mana pun. Ganti alat hanya dengan satu tombol, tanpa perlu kode tambahan.

Fitur pengambilan data dari situs web

Semua fitur Yozh Scraper tersedia sebagai fungsi untuk agen Anda, termasuk pengambilan data, eksekusi batch, dan tangkapan layar.

Satu menit untuk terhubung

Salin berkas konfigurasi, mulai ulang klien Anda, dan Anda sudah siap.

Dapat digunakan dengan klien MCP apa pun

Claude Desktop, Cursor, Cline, atau agen kustom.

Kontrol penuh atas perangkat tersebut

Pilih cara agen Anda menjalankan tugas, mulai dari satu halaman hingga seluruh batch.

Lakukan sesuai keinginanmu

Gunakan server MCP lokal atau terapkan di infrastruktur Anda sendiri.

// ~/Library/Application Support/Claude/claude_desktop_config.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cursor → Settings → MCP → Add new MCP Server
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cline → MCP Servers → Edit cline_mcp_settings.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp",
      "disabled": false
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp",
      "disabled": false
    }
  }
}
// Anthropic Messages API · MCP via Streamable HTTP
// Note: scraper must be reachable from Anthropic's servers (deploy publicly)
import Anthropic from "@anthropic-ai/sdk";

const response = await new Anthropic().messages.create({
  model: "claude-opus-4-8",
  mcp_servers: [
    { type: "url", url: "https://your-host/mcp", name: "yozh-scraper" },
    { type: "url", url: "https://your-host:8001/mcp", name: "yozh-crawler" }
  ],
  messages: [...]
});
Panduan Integrasi MCP Lengkap
Yozh Crawler · v0.1.13

Menjelajahi, mengalirkan, dan mengurai halaman secara real time

Yozh Crawler memulai dari satu URL, menemukan halaman-halaman di seluruh situs, dan memprosesnya saat halaman-halaman tersebut dimuat, sehingga Anda mendapatkan struktur lengkap dan data yang dapat dimanfaatkan dalam satu kali proses.

Siaran langsung

Halaman akan muncul seiring dengan penemuan dan pemrosesannya. Akses langsung dari klien, agen, atau pipeline Anda tanpa perlu menunggu proses pemrosesan selesai sepenuhnya.

Mode Penjelajahan

Hanya butuh tautan? Lakukan pemetaan situs tanpa proses parsing. Lebih cepat dan lebih hemat biaya untuk pemeriksaan struktur dan audit.

Pembatalan dua tahap

Hentikan proses dengan aman. Biarkan halaman yang sedang aktif selesai terlebih dahulu, atau hentikan semuanya secara instan jika diperlukan.

Sakelar target MCP

Beralih antara scraper dan crawler hanya dengan satu tombol. Agen Anda akan menggunakan alat yang tepat untuk setiap tugas.

Pohon situs secara langsung di antarmuka pengguna

Lihat proses pembangunan struktur situs secara langsung. Pantau perkembangannya halaman demi halaman tanpa perlu meninggalkan dasbor.

Result

crawl_a8f3c124b6e0d7 · status: idle · visited: 0 / 30 · queued: 0 · failed: 0 · dedup: 0 · out-of-scope: 0 · retries: 0
Site Map (0 pages)

                    
URL Parent Depth Status Took
Paket · Crawler + Scraper

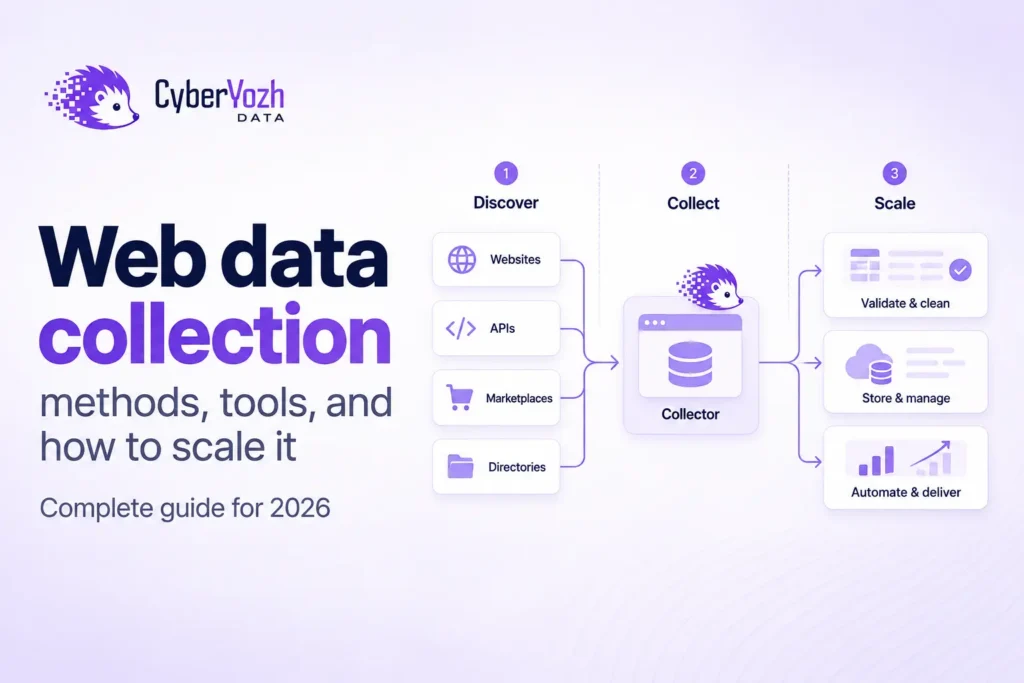
Dari satu URL hingga cakupan seluruh situs

Crawler menemukan halaman-halaman, scraper memprosesnya, dan agen AI Anda memanfaatkan hasilnya; dirancang untuk pemula maupun ahli.

Crawler

Menemukan semua URL

Yozh Scraper

Ekstrak ke JSON

Agen AI

Menganalisis & memutuskan

Analisis persaingan

Pantau katalog, harga, dan detail produk pesaing di satu tempat. Temukan celah dalam daftar produk Anda sendiri dan tanggapi perubahan pasar dengan lebih cepat.

Crawler JSON AI

Pemantauan harga

Pantau perubahan harga di berbagai platform jual beli secara otomatis. Atur pemberitahuan dan dapatkan notifikasi di Telegram atau Slack saat harga berubah.

Batch Jadwal Pemberitahuan

Data pelatihan ML

Mengumpulkan kumpulan data yang bersih dan terstruktur dari sumber-sumber publik, yang siap untuk dianalisis atau digunakan dalam pelatihan model. Dirancang untuk pengumpulan data yang andal dalam skala besar.

Stealth Proxy JSON
Pengaturan default marketplace & situs

Segera mulailah melakukan scraping dengan preset yang siap pakai

Pengaturan wilayah, mata uang, pemilih, dan penanganan anti-bot — sudah dikonfigurasi. Pilih salah satu preset untuk melihat data apa saja yang diekstraksi.

10 preset bawaan · LLM dapat memperbaiki diri sendiri saat tata letak situs berubah · buat preset Anda sendiri dari URL contoh Ajukan permintaan preset →


Every Amazon listing, normalized

All fields below are extracted automatically — no selectors to write.

Butuh situs yang belum kami liput?

Buka tiket di GitHub atau kirimkan preset buatan Anda sendiri — kami akan meninjau pull request dalam waktu seminggu.

Buka laporan masalah
Proksi

Proksi yang dirancang untuk pengambilan data

Tiga jenis, enam konfigurasi. Pilih berdasarkan jenis pekerjaan, kecepatan, dan anggaran.

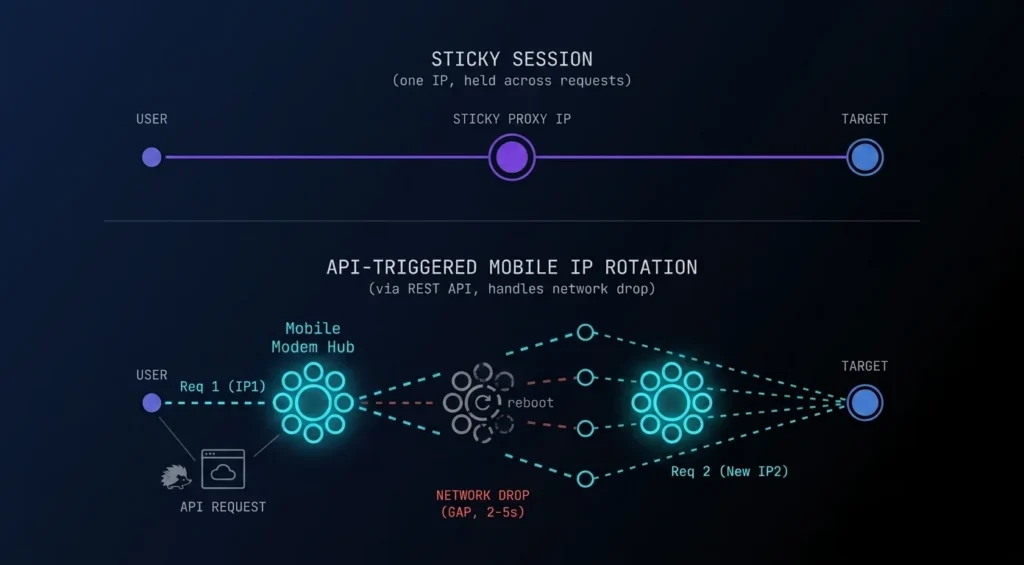
Seluler 4G/5G

Perangkat seluler asli yang terhubung ke jaringan operator. Tingkat kepercayaan tertinggi dengan sistem anti-bot yang ketat.

Pribadi dan khusus mulai $1.7/hari

Perangkat pribadi, rotasi IP manual melalui API

Dibagikan mulai $0.9/hari

Satu perangkat, banyak pengguna

Pelajari lebih lanjut tentang proxy seluler
Cara kerjanya

Setiap alamat IP berasal dari smartphone asli atau modem LTE/5G yang terhubung ke operator seluler besar. Alamat IP tersebut digunakan bersama oleh ribuan pelanggan reguler, sehingga memblokirnya berarti memblokir pengguna asli — itulah sebabnya sistem anti-bot paling mempercayai alamat IP seluler.

Paling cocok untuk
  • Pengelolaan akun di platform media sosial
  • Upaya agresif melawan bot (Cloudflare, PerimeterX)
  • Kerja afiliasi dan verifikasi iklan
  • Tugas-tugas yang membutuhkan kepercayaan yang berkelanjutan layaknya manusia
Spesifikasi
  • Jaringan 4G LTE dan 5G di seluruh dunia
  • Dukungan UDP, konektivitas VPN VLESS
  • Rotasi IP manual melalui API atau tautan dasbor
  • Penyesuaian sidik jari sistem operasi
  • Bandwidth tak terbatas pada sebagian besar paket

Pusat Data

Kecepatan maksimal, biaya minimal. Lebih dari 2 juta alamat IP di berbagai pusat data di seluruh dunia.

Statis khusus mulai $1.9/bln

Satu alamat IP yang dialokasikan untuk Anda, lalu lintas tak terbatas

Statis bersama mulai $0.5/bln

Shared pool, pilihan hemat untuk pekerjaan sederhana

Pelajari lebih lanjut tentang proxy pusat data
Cara kerjanya

IP tersebut dihosting di pusat data dan tidak terhubung ke pengguna rumahan maupun pengguna seluler. Harganya lebih murah dan kecepatannya lebih tinggi daripada IP rumahan, tetapi sistem anti-bot dapat mengidentifikasinya sebagai bukan manusia, jadi gunakanlah IP tersebut di tempat-tempat di mana faktor kepercayaan tidak terlalu penting.

Paling cocok untuk
  • Pengambilan data dalam volume besar dari situs-situs yang bersahabat
  • Pengembangan alat internal dan pengujian beban
  • Titik akhir API tanpa filter kepercayaan IP
  • Tugas-tugas di mana kecepatan lebih diutamakan daripada penyamaran
Spesifikasi
  • Lebih dari 2 juta alamat IPv4 dan IPv6
  • Konfigurasi khusus atau bersama
  • Bandwidth tak terbatas pada paket khusus
  • Mendukung protokol HTTPS dan SOCKS5
  • Latensi terendah di antara ketiga jenis tersebut
Pilih proxy yang sesuai dengan kebutuhan Anda → Harus masuk
Etika · Tidak dapat dinegosiasikan

Etika telah menjadi bagian integral dari cara kami mengelola platform ini

Kode sumber terbuka hanyalah titik awal. Cara pengumpulan data dan cara memperoleh proxy sama pentingnya. Inilah standar yang kami terapkan dalam praktik, bukan sekadar pernyataan di atas kertas.

Pengumpulan data yang etis

Kami mengembangkan alat, bukan celah. Yozh Scraper dirancang untuk memastikan pengambilan data publik yang sah dapat dilakukan dengan andal — bukan untuk merusak hal-hal yang seharusnya tetap tertutup.

  • Hanya data yang dapat diakses publik — secara default, tidak diperbolehkan melakukan scraping bagi pengguna yang sudah masuk
  • Batas laju bawaan mencegah terjadinya kelebihan beban pada server
  • Pemenuhan aturan robots.txt dan sitemap secara default (dapat diubah)
  • Tidak ada pengumpulan atau penyimpanan PII — baik oleh kami maupun secara default bagi pengguna
  • Perangkat yang membantu Anda tetap mematuhi GDPR dan CCPA

Jaringan proxy transparan

Asal usul alamat IP perumahan merupakan ujian kejujuran bagi setiap penyedia proxy. Inilah asal usul alamat IP kami — secara eksplisit:

  • Jaringan berbasis persetujuan. Pengguna sungguhan memberikan persetujuan dan mendapatkan imbalan dengan berbagi bandwidth
  • Anda dapat berhenti berlangganan dengan satu klik kapan saja, tanpa perlu memberikan alasan apa pun
  • Rantai pasokan yang telah diaudit dengan sumber pasokan yang terdokumentasi
  • Tanpa malware sama sekali, tanpa penyisipan SDK tersembunyi — sama sekali tidak pernah
  • Alamat IP seluler dari perangkat yang kami miliki dan kelola, bukan dari ponsel yang diretas

Tanggapan cepat terhadap pelecehan

Jika ada yang menyalahgunakan infrastruktur kami untuk merugikan orang lain, kami ingin mengetahuinya — dan segera mengambil tindakan sebelum situasinya semakin memburuk.

  • Saluran langsung ke petugas sungguhan, bukan antrean tiket
  • Proses penyelidikan yang transparan untuk setiap laporan yang sah
  • Kerja sama aktif dengan penegak hukum terkait kasus-kasus yang telah dikonfirmasi
  • Kebijakan tentang pelecehan di ruang publik, tidak tersembunyi di balik ketentuan-ketentuan yang rumit
abuse-reports@cyberyozh.pro
Waktu respons rata-rata: 45 menit

Jika suatu kasus penggunaan melibatkan penyalahgunaan atau kerugian, alat-alat kami tidak dirancang untuk itu. Kami lebih mengutamakan penggunaan yang bertanggung jawab daripada pertumbuhan pelanggan.

Jika suatu kasus penggunaan mengharuskan penyembunyian identitas untuk merugikan orang lain, alat-alat kami tidak diperuntukkan untuk itu. Titik. Kami lebih memilih kehilangan pelanggan daripada mengorbankan prinsip kami.

Disukai oleh tim data dan pengembang AI

Apa yang dikatakan oleh para pengembang yang menggunakan Yozh

5.0 / 5 · 5 ulasan
GitHub
Dalam satu sore, kami mengganti klaster Playwright internal kami dengan Yozh. Titik akhir MCP langsung terintegrasi ke dalam agen Claude kami — tanpa perlu kode penghubung sama sekali, crawler dan scraper langsung berfungsi dengan baik.
Marcus Reinhardt Insinyur Data Utama Northwind Analytics
X
Sistem preset ini adalah fitur andalannya. Kami memasukkan nama sumber dan mendapatkan respons JSON yang rapi; fitur pemulihan otomatisnya bahkan berhasil mendeteksi dua perubahan tata letak Amazon sebelum kami menyadarinya.
Priya Nair Pendiri ScrapeStack
Reddit
Akhirnya, ada scraper sumber terbuka yang memperlakukan proxy dan sesi sebagai fitur utama. Kami menjalankannya di balik sistem otentikasi untuk portal mitra — sesi tetap aktif dan hasilnya tetap konsisten di seluruh wilayah.
Daniel Osei Insinyur Backend Loopfeed
X
Setelah menghubungkannya ke Cursor melalui MCP, agen saya kini dapat mengambil data web secara langsung di tengah-tengah tugas. Proses pengambilan data streaming melalui SSE inilah yang selama ini menjadi hal yang kurang dalam alur kerja agen.
Elena Kovac Insinyur Kecerdasan Buatan Vektor Labs
GitHub
Kami beralih dari API pengambilan data berbayar untuk menghemat biaya dan bersiap menghadapi penurunan kualitas layanan — ternyata hasilnya justru sebaliknya. Sistem ini dihosting sendiri, tanpa tagihan per permintaan, dan skema outputnya lebih rapi daripada yang dulu kami bayar.
Sofia Almeida Manajer Teknik Tabbly
Daftar Perubahan

Catatan perubahan dan pembaruan web scraping

Yozh Scraper adalah perangkat lunak sumber terbuka, dengan semua pembaruan tersedia di GitHub. Berikut ini adalah fitur-fitur terbaru yang menonjol.

v0.1.13 16 September 2026 Latest

v0.1.13

  • Row-scoped extraction. An extract rule takes a container selector; every
  • device=legacy_wap — a feature-phone identity that unlocks Google's no-JS
  • resolve_redirects — names extracted fields whose values are the page's
  • New built-in presets: ozon_search, ozon_product, mobile_de_search,
  • A warning when a search engine answered a different query than the one asked.
v0.1.12 1 September 2026

v0.1.12

  • Every built-in preset now ships as an explicit per-engine variant, <name>_chromium and <name>_camoufox (e.g. google_search_chromium, yandex_search_camoufox). A request names the exact variant it wants; each preset carries its own browser_engine.
  • Structured, correlated logging: business events get stable names and a request/job correlation id threaded through the scrape -> queue -> browser chain, so success/error rate and latency are answerable from logs. An opt-in JSON log shape is available via LOG_FORMAT=json (default text).
  • Browser egress policy knobs: an EGRESS_ALLOW_HOSTS allowlist (empty by default) and an EGRESS_TRANSPORT_GUARD toggle (on by default).
  • BREAKING (presets): the old single-name built-ins (google_search, google_shopping, amazon_product, amazon_search, bing_search, ebay_search, linkedin_profile, walmart_product, yandex_search, youtube_video) are replaced by their per-engine variants. A request using a bare old name now returns 404 preset_not_found; append the engine suffix (_chromium, or _camoufox for the two anti-bot targets yandex_search and walmart_product).
  • BREAKING (deploy): GET /api/v1/proxies/available and the entire /api/v2/prem-proxies/* catalog now require SERVICE_TOKEN and fail closed (503 when the token is unconfigured, 401 without it). Any consumer of these endpoints must send the X-Service-Token header; deploy the consumer first, or its calls degrade (for the proxy geo catalog, silently).
v0.1.11 25 Agustus 2026

v0.1.11

  • The job results response carries unreadable_slots. A job with one corrupt or schema-skewed result slot now returns its other pages (HTTP 200) and names the bad slot, instead of the whole job failing with a 500 and becoming un-cancellable until its TTL expires.
  • The login-replay page is masked with the same host-aligned WebGL/GPU, native-looking navigator, and Client-Hints (Sec-CH-UA) as the main fetch path, via a shared page-preparation helper. A credentialed login no longer submits a contradictory fingerprint (previously a macOS GPU and a HeadlessChrome Client-Hint under a Windows user agent).
  • Self-heal can no longer persist a degraded preset over a working one. It now contributes only the regenerated selector (and its dialect), keeping the preset's all / attr / post_process and required fields, and it is graded against the original contract — so a heal that returns a bare string where a coerced list belongs is no longer counted as a recovery. It also never heals from a transient 5xx error page. This closes a class of silent preset corruption.
  • Proxy credentials are kept out of logs, error messages and 502 response bodies. The SOCKS bridge, the rotating-credentials response and the username log no longer emit user:pass; a shared redactor masks proxy URLs while preserving host:port for diagnostics.
  • litellm is bounded <1.98: 1.98.0 imports NotRequired from typing unguarded and fails to import on the Python 3.10 this project targets, so a fresh install or image build would produce a container that cannot start.
v0.1.10 20 Agustus 2026

v0.1.10

  • Chromium WebGL now claims the host's actual GPU vendor/renderer, kept coherent with the Windows fingerprint the browser already presents, reusing the host-GPU detection from the Camoufox path (HOST_GPU_VENDOR). Without it the restored context reported a generic SwiftShader/ANGLE software-renderer string, itself an automation tell.
  • Chromium returned a null WebGL context on GPU-less / headless hosts (Chrome 136+ dropped the automatic SwiftShader fallback), and "no WebGL context at all" is a strong bot tell that real desktop Chrome never shows. A working software WebGL context is restored via --enable-unsafe-swiftshader, gated by the new SOFTWARE_WEBGL setting (default on, Chromium-only; revertible by env without a code change).
  • README now links the project site (data.cyberyozh.pro) with per-service pages for the scraper and crawler.
v0.1.0 9 Juli 2026 First release

v0.1.0 - Durable queue, Camoufox engine & CyberYozh proxy v2

  • New required services. Browsers no longer run inside the API process. You must now run the redis and scraper-worker services (both are already in docker-compose.yml). Scale capacity with docker compose up -d --scale scraper-worker=N.
  • POST /scrape/page and /scrape/pages can now return 503 queue_full when the Redis stream depth exceeds QUEUE_MAXSIZE (previously the in-memory queue was unbounded).
  • Removed env vars (ignored, warned at startup if set): JOB_TIMEOUT_MS → use PAGE_TASK_TIMEOUT_S; JOB_RESULT_MAX → eviction is now a native Redis TTL (JOB_RESULT_TTL_S); JOBS_ENABLED → the queue is always on.
  • New env vars: REDIS_URL, PAGE_TASK_TIMEOUT_S, LOGIN_TASK_TIMEOUT_S, LOGIN_RESULT_GRACE_S, RECLAIM_IDLE_S, JOB_RESULT_TTL_S, BROWSER_MAX_PAGES, BROWSER_IDLE_SHUTDOWN_S, WARMUP_DWELL_MS.
  • The in-process job queue and browser worker pool are replaced by a taskiq stream on Redis. The web-scraper container only enqueues page tasks and reads results; browsers run in separate, horizontally scalable scraper-worker containers.
Panduan Cepat

Mulailah melakukan web scraping dalam hitungan detik

Cukup tiga perintah, dan Anda sudah memiliki scraper + crawler yang siap dijalankan dengan titik akhir HTTP dan MCP.

1 Klon
git clone https://github.com/\
  CyberYozh-data/yozh-scraper
cd yozh-scraper
2 Lari
cp .env.example .env
docker compose up --build
3 Mengikis
curl -X POST localhost:8000/api/v1/scrape/page \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com"}'
Dokumentasi lengkap Hubungkan ke Claude / Cursor melalui MCP →
Kontak · Dukungan

Hubungi kami

Seorang manusia sungguhan akan membaca semua pesan yang masuk. Pilih saluran yang paling cocok — Telegram adalah yang tercepat.

Kantor
Jurija Gagarina 231/329
Novi Beograd · Serbia
Layanan dukungan dua tingkatan, hampir sepanjang waktu Tim garis depan bertugas hampir 24 jam sehari, 7 hari seminggu. Insinyur senior menangani kasus-kasus yang rumit.
Sumber Terbuka · Lisensi MIT · 88 ★

Siap mengikis?

Yozh Crawler + Scraper gratis. Selamanya. Berikan bintang jika aplikasi ini bermanfaat — setiap bintang sangat berarti.

Yozh Crawler + Scraper didistribusikan di bawah lisensi MIT. Silakan gunakan. Buat cabang (fork). Gunakan untuk mengembangkan aplikasi.