88 bintang di GitHub dan terus bertambah. Yozh Crawler + Scraper adalah perangkat lunak gratis, sumber terbuka, dan dikembangkan secara terbuka — berikan kami bintang jika alat ini layak masuk ke dalam tumpukan teknologi Anda.

Memberi Makan Sistem RAG dalam Skala Besar: Cara Membersihkan Kebisingan DOM dan Merotasi Proxy untuk Ingesti LLM yang Bersih

Menargetkan situs web modern untuk melatih model AI dapat merusak pipeline ekstraksi data tradisional. Anda mengarahkan browser headless ke katalog produk dinamis. Server target langsung menganalisis tanda tangan TLS Client Hello Anda. Server memeriksa urutan frame HTTP/2 Anda sebelum mengirimkan satu byte data pun. Jika koneksi Anda tidak memiliki ekosistem proxy yang kuat untuk otomatisasi […]
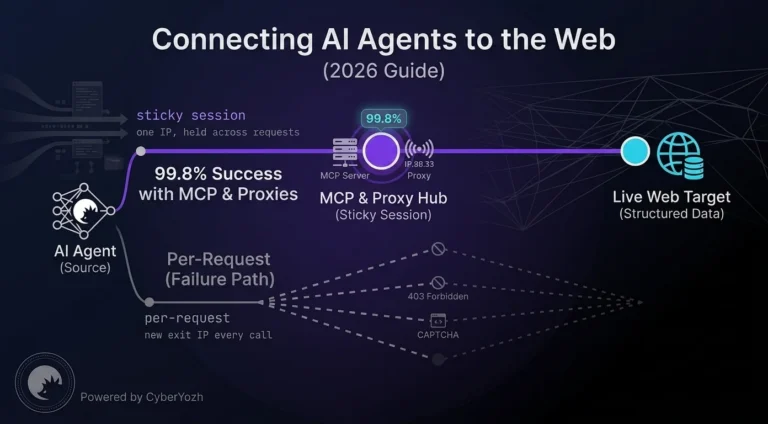
Menghubungkan Agen AI ke Web: Tingkat Keberhasilan 99,8% dengan Server MCP & Proxy (2026)

Jawaban Singkat: Model Context Protocol (MCP) berfungsi sebagai jembatan universal, memungkinkan agen AI (seperti Claude Desktop atau Cursor) untuk menjelajahi web secara langsung, merender JavaScript, dan mengekstrak data terstruktur. Namun, untuk mencegah pemblokiran IP dan CAPTCHA selama crawling web otomatis, agen AI harus merutekan permintaan mereka melalui proxy residensial atau seluler dengan tingkat kepercayaan tinggi […]

Playwright vs. Puppeteer untuk Scraping E-commerce: Mengapa Rotasi IP Cerdas adalah Pembeda Utama

Saat mengevaluasi Playwright vs Puppeteer untuk scraping e-commerce, para engineer sering terlalu terpaku pada kecepatan eksekusi dan sintaks API. Namun, pada tahun 2026, lanskap ekstraksi data telah berubah secara fundamental. Situs target menerapkan analisis perilaku yang agresif, TLS fingerprinting, dan mutasi DOM yang dinamis. Membangun pipeline yang mampu bertahan dari pertahanan ini membutuhkan jauh lebih […]

Pipeline Scraping yang Tangguh: Memperkenalkan LLM Self-Healing Parsing di Yozh Scraper

Ekstraksi data adalah lapisan fundamental dalam pengembangan kecerdasan buatan modern, intelijen pasar, dan analisis kompetitif. Namun, membangun pipeline data yang andal tetap menjadi hambatan rekayasa. Situs web target terus-menerus menerapkan perubahan struktural, pengujian A/B, dan obfuskasi dinamis, yang menyebabkan skrip ekstraksi kaku menjadi gagal. Untuk mengatasi paradigma kerapuhan ini, ekosistem web scraping memerlukan perubahan arsitektur […]