88 sao trên GitHub và con số này vẫn đang tiếp tục tăng. Yozh Crawler + Scraper là phần mềm miễn phí, mã nguồn mở và được phát triển công khai — hãy nhấn sao cho chúng tôi nếu công cụ này xứng đáng có một vị trí trong hệ thống công nghệ của bạn.
Phiên bản v0.1.13 · Yozh Crawler đã ra mắt

Trích xuất
dữ liệu web dễ dàng cho các tác nhân
AI và con người

Một công cụ mã nguồn mở dùng để thu thập và trích xuất dữ liệu. Bắt đầu từ một URL duy nhất, quét trang web và thu thập dữ liệu có cấu trúc khi các trang được tải. Tương thích với MCP và các công cụ như Claude và Cursor, kèm theo các cài đặt sẵn dành cho các sàn thương mại điện tử như Amazon và eBay.

88 Số sao trên GitHub
MIT Giấy phép · Miễn phí vĩnh viễn
v0.1.13 Phiên bản mới nhất
Open Scraper Tester
Scraper URL http://localhost:8000 Check ok Crawler URL http://localhost:8001 Check ok CyberYozh API Docs ↗ Get API Key ↗
Scrape Page
Batch Scrape
Crawler
Jobs
MCP
Crawl Parameters
Seed URL *
Scope Mode
same-domain
Max Depth
3
Max Pages
47
Per-domain RPS
1.0
Per-domain
1
Include Patterns (regex, one per line)
^https://amazon\.co\.uk/dp/
Exclude Patterns (regex, one per line)
/cart|/account|/checkout
Crawl Proxy⚠ crawl proxy=none — no IP rotation
Proxy Type
none
Enable scraping (keep raw_html / screenshot / extracted data per page)
Result
crawl_________________ · status: idle · visited: 0 / 30 · queued: 0 · failed: 0 · dedup: 0
Crawl progress and pages will appear here...
Có gì mới · phiên bản v0.1.13

Quét toàn bộ trang web và thu thập dữ liệu chỉ trong một lần chạy

Yozh Crawler lập bản đồ toàn bộ cấu trúc trang web và xử lý các trang ngay khi phát hiện chúng. Bạn sẽ nhận được cả phạm vi quét và kết quả có thể sử dụng chỉ trong một lần chạy, mà không cần phải quản lý các bước thu thập dữ liệu và trích xuất riêng biệt. Công cụ này hoạt động trực tiếp trong các quy trình thu thập dữ liệu và trích xuất hiện có của bạn.

Yozh Crawler, tích hợp NEW

Bắt đầu từ một URL và lập bản đồ toàn bộ trang web. Các trang được phát hiện và xử lý trong một lần chạy duy nhất, nhờ đó bạn có được phạm vi bao quát toàn diện mà không cần thực hiện thêm bất kỳ bước nào.

Chế độ Khám phá NEW

Chỉ cần các liên kết? Hãy chuyển sang chế độ khám phá và lập bản đồ trang web mà không cần phân tích cú pháp. Nhanh hơn, nhẹ hơn và hữu ích cho việc kiểm toán và kiểm tra cấu trúc.

Trình duyệt ẩn danh

So khớp các tiêu đề, vị trí và tín hiệu trình duyệt với máy chủ proxy của bạn. Giúp duy trì tính nhất quán của các phiên trên các khu vực khác nhau.

Trích xuất dữ liệu theo lô

Chạy hàng trăm URL trong một yêu cầu. Xử lý tất cả song song và trả về một kết quả duy nhất.

Hủy hai giai đoạn NEW

Tạm dừng các tác vụ mà không làm gián đoạn kết quả. Cho phép các trang đang hoạt động hoàn tất hoặc dừng mọi thứ ngay lập tức khi cần thiết.

Tích hợp MCP

Kết nối trực tiếp với các công cụ như Claude và Cursor. Tích hợp các kỹ thuật trích xuất dữ liệu và thu thập dữ liệu vào quy trình làm việc hiện tại của bạn.

10 cài đặt sẵn tích hợp sẵn

Amazon, eBay, Walmart, Google, Google Shopping, YouTube, LinkedIn, Bing, Yandex — chỉ cần truyền tên nguồn và các tham số, bạn sẽ nhận được phản hồi đã được chuẩn hóa. Không cần phải viết các selector.

Khả năng tự phục hồi của LLM NEW

Một trang web triển khai thay đổi bố cục và các bộ chọn CSS của bạn trả về kết quả trống? Trình phân tích cú pháp sẽ yêu cầu một mô hình ngôn ngữ lớn (LLM) (OpenAI / Anthropic / Gemini / OpenRouter) tái tạo bộ chọn ngay lập tức. Quy trình xử lý vẫn tiếp tục chạy.

Các cài đặt sẵn do AI tạo ra NEW

Bạn cần một trang web mà chúng tôi chưa cung cấp cài đặt sẵn? Hãy mô tả nội dung cần trích xuất và dán một URL mẫu vào — POST /api/v1/presets/generate sẽ trả về một preset JSON đã sẵn sàng.

Các phiên đã được xác thực NEW

Đăng nhập một lần thông qua ngôn ngữ kịch bản khai báo (goto / fill / click / wait) hoặc dán các tệp cookie đã xuất. Tái sử dụng phiên đăng nhập này trong mỗi lần thu thập dữ liệu. Yêu cầu bắt buộc đối với các mục tiêu có tường lửa như cài đặt sẵn LinkedIn.

Giao diện

Hệ thống thu thập dữ liệu đơn giản do chính bạn kiểm soát

Thiết lập quy trình làm việc của bạn tại một nơi duy nhất và vận hành theo cách bạn cần. Mọi thứ đều rõ ràng, có hệ thống và dễ quản lý mà không cần đến các công cụ bổ sung.

1

Các máy chủ proxy tích hợp sẵn, sẵn sàng sử dụng

Truy cập các proxy dân dụng, di động và trung tâm dữ liệu tại hơn 120 quốc gia. Hơn 50 triệu địa chỉ IP với thời gian hoạt động 99,9%. Bao gồm tính năng nhận dạng dấu vân tay để đồng bộ hóa hành vi của thiết bị, trình duyệt và mạng, nhằm đảm bảo các phiên kết nối ổn định và khả năng kiểm soát tốt hơn.

2

Trích xuất dữ liệu linh hoạt

Sử dụng các bộ chọn CSS, XPath hoặc tính năng tự động phát hiện cho các trang web phổ biến. Nhận dữ liệu JSON gọn gàng, có cấu trúc mà không cần thiết lập phức tạp.

3

Tất cả dữ liệu được tập trung tại một nơi

Tải về mã HTML thô, ảnh chụp màn hình và dữ liệu đã được phân tích cùng một lúc. Tất cả những gì bạn cần, mà không cần phải chuyển đổi giữa các công cụ.

4

Điều khiển đơn giản và quyền truy cập MCP

Dừng các tác vụ bất cứ lúc nào chỉ với một cú nhấp chuột và chuyển đổi giữa chế độ scraper và crawler. Quy trình làm việc của bạn vẫn đơn giản và hoàn toàn nằm trong tầm kiểm soát của bạn.

MCP · Giao thức bối cảnh mô hình

Các tác nhân AI được phát triển để thu thập và quét dữ liệu trên web

Kết nối Yozh Crawler và Yozh Scraper với Claude, Cursor hoặc bất kỳ ứng dụng khách MCP nào. Chuyển đổi công cụ chỉ bằng một nút gạt, không cần thêm mã.

Các tính năng thu thập dữ liệu từ web

Tất cả các tính năng của Yozh Scraper đều có sẵn dưới dạng các hàm cho agent của bạn, bao gồm trích xuất dữ liệu, chạy theo lô và chụp ảnh màn hình.

Chỉ mất một phút để kết nối

Sao chép tệp cấu hình, khởi động lại ứng dụng khách của bạn, và thế là xong.

Hoạt động với bất kỳ máy khách MCP nào

Claude Desktop, Cursor, Cline hoặc các tác nhân tùy chỉnh.

Kiểm soát hoàn toàn bộ công cụ

Chọn cách thức mà tác nhân của bạn thực thi các tác vụ, từ từng trang riêng lẻ đến toàn bộ lô tác vụ.

Hãy thực hiện theo cách của bạn

Sử dụng máy chủ MCP tại địa phương hoặc triển khai nó trên hạ tầng của riêng bạn.

// ~/Library/Application Support/Claude/claude_desktop_config.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cursor → Settings → MCP → Add new MCP Server
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cline → MCP Servers → Edit cline_mcp_settings.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp",
      "disabled": false
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp",
      "disabled": false
    }
  }
}
// Anthropic Messages API · MCP via Streamable HTTP
// Note: scraper must be reachable from Anthropic's servers (deploy publicly)
import Anthropic from "@anthropic-ai/sdk";

const response = await new Anthropic().messages.create({
  model: "claude-opus-4-8",
  mcp_servers: [
    { type: "url", url: "https://your-host/mcp", name: "yozh-scraper" },
    { type: "url", url: "https://your-host:8001/mcp", name: "yozh-crawler" }
  ],
  messages: [...]
});
Hướng dẫn tích hợp MCP đầy đủ
Yozh Crawler · phiên bản v0.1.13

Truy cập, truyền phát và phân tích các trang web theo thời gian thực

Yozh Crawler bắt đầu từ một URL, phát hiện các trang trên toàn bộ trang web và xử lý chúng ngay khi chúng được tải, mang đến cho bạn cấu trúc đầy đủ và dữ liệu có thể sử dụng chỉ trong một lần chạy.

Phát trực tiếp

Các trang sẽ hiển thị ngay khi được phát hiện và xử lý. Bạn có thể truy cập trực tiếp từ khách hàng, đại lý hoặc quy trình làm việc của mình mà không cần đợi quá trình xử lý hoàn tất.

Chế độ Khám phá

Chỉ cần các liên kết? Tạo sơ đồ trang web mà không cần phân tích cú pháp. Nhanh hơn và tiết kiệm chi phí hơn khi kiểm tra cấu trúc và thực hiện kiểm toán.

Hủy hai giai đoạn

Dừng các tác vụ một cách an toàn. Hãy để các trang đang hoạt động hoàn tất hoặc dừng mọi thứ ngay lập tức khi cần thiết.

Công tắc mục tiêu MCP

Chuyển đổi giữa chế độ scraper và crawler chỉ bằng một nút gạt. Trình tự động của bạn sẽ sử dụng công cụ phù hợp cho từng tác vụ.

Cây trang web trực tiếp trên giao diện người dùng

Theo dõi quá trình xây dựng cấu trúc trang web theo thời gian thực. Theo dõi tiến độ từng trang một mà không cần rời khỏi bảng điều khiển.

Result

crawl_a8f3c124b6e0d7 · status: idle · visited: 0 / 30 · queued: 0 · failed: 0 · dedup: 0 · out-of-scope: 0 · retries: 0
Site Map (0 pages)

                    
URL Parent Depth Status Took
Gói combo · Máy thu thập dữ liệu + Máy trích xuất dữ liệu

Từ một URL đến phạm vi bao quát toàn bộ trang web

Trình thu thập dữ liệu tìm kiếm các trang web, trình trích xuất dữ liệu xử lý chúng, và trợ lý AI của bạn sẽ sử dụng kết quả thu được — được thiết kế dành cho cả người mới bắt đầu lẫn chuyên gia.

Xe bò

Tìm tất cả các URL

Yozh Scraper

Trích xuất sang JSON

Trợ lý AI

Phân tích và ra quyết định

Phân tích cạnh tranh

Theo dõi danh mục sản phẩm, giá cả và thông tin chi tiết về sản phẩm của các đối thủ cạnh tranh tại một nơi duy nhất. Phát hiện những điểm còn thiếu sót trong danh mục sản phẩm của chính bạn và phản ứng nhanh hơn trước những thay đổi của thị trường.

Crawler JSON Trí tuệ nhân tạo

Theo dõi giá cả

Tự động theo dõi biến động giá trên các sàn thương mại điện tử. Thiết lập cảnh báo và nhận thông báo qua Telegram hoặc Slack khi giá có biến động.

Xử lý hàng loạt Lịch trình Thông báo

Dữ liệu huấn luyện ML

Thu thập các bộ dữ liệu sạch, có cấu trúc từ các nguồn công khai, sẵn sàng để phân tích hoặc huấn luyện mô hình. Được thiết kế để thu thập dữ liệu đáng tin cậy trên quy mô lớn.

Stealth Proxy JSON
Cài đặt sẵn cho Marketplace và trang web

Bắt đầu trích xuất dữ liệu ngay lập tức với các cài đặt sẵn có thể sử dụng ngay

Cài đặt vùng, đơn vị tiền tệ, bộ lọc và cơ chế chống bot — đã được cấu hình sẵn. Hãy chọn một cài đặt sẵn để xem những thông tin nào sẽ được trích xuất.

10 cài đặt sẵn tích hợp sẵn · LLM tự khắc phục khi bố cục trang web thay đổi · tạo cài đặt sẵn của riêng bạn từ một URL mẫu Yêu cầu cài đặt sẵn →


Every Amazon listing, normalized

All fields below are extracted automatically — no selectors to write.

Bạn cần một trang web mà chúng tôi chưa đề cập đến?

Hãy tạo một vấn đề trên GitHub hoặc đóng góp cài đặt sẵn của riêng bạn — chúng tôi sẽ xem xét các yêu cầu kéo (PR) trong vòng một tuần.

Tạo một vấn đề
Máy chủ proxy

Các máy chủ proxy được thiết kế để thu thập dữ liệu

Ba loại, sáu cấu hình. Hãy lựa chọn dựa trên công việc, tốc độ và ngân sách.

Di động 4G/5G

Các thiết bị di động thực tế trên mạng của các nhà mạng. Mức độ tin cậy cao nhất với hệ thống chống bot nghiêm ngặt.

Riêng tư và chuyên dụng từ $1.7/ngày

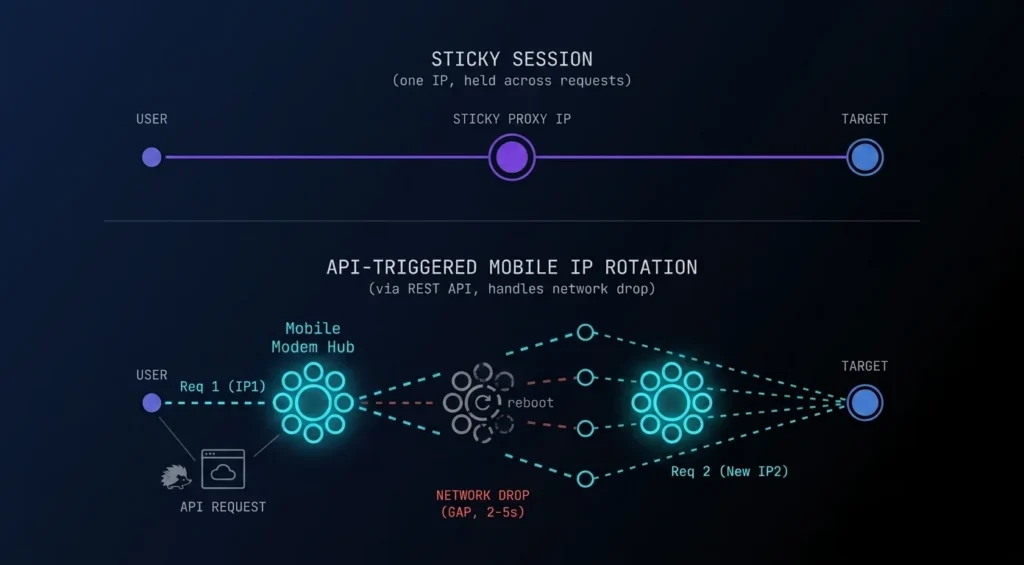
Thiết bị cá nhân, xoay vòng địa chỉ IP thủ công qua API

Được chia sẻ từ $0.9/ngày

Một thiết bị, nhiều người dùng

Tìm hiểu thêm về proxy di động
Cách thức hoạt động

Mỗi địa chỉ IP đều xuất phát từ một chiếc điện thoại thông minh thực tế hoặc một modem LTE/5G được kết nối với một nhà mạng di động lớn. Địa chỉ IP này được chia sẻ bởi hàng nghìn thuê bao thường xuyên, do đó việc chặn địa chỉ IP này đồng nghĩa với việc chặn cả những người dùng thực — đó chính là lý do tại sao các hệ thống chống bot tin tưởng vào địa chỉ IP di động nhất.

Phù hợp nhất cho
  • Quản lý tài khoản trên các nền tảng mạng xã hội
  • Các biện pháp chống bot mạnh mẽ (Cloudflare, PerimeterX)
  • Hoạt động liên kết và xác minh quảng cáo
  • Các nhiệm vụ đòi hỏi sự tin cậy “giống con người” một cách bền vững
Thông số kỹ thuật
  • Mạng 4G LTE và 5G trên toàn thế giới
  • Hỗ trợ UDP, kết nối VPN VLESS
  • Chuyển đổi địa chỉ IP thủ công qua API hoặc liên kết trên bảng điều khiển
  • Điều chỉnh dấu vân tay hệ điều hành
  • Băng thông không giới hạn trên hầu hết các gói cước

Trung tâm dữ liệu

Tốc độ tối đa, chi phí tối thiểu. Hơn 2 triệu địa chỉ IP tại các trung tâm dữ liệu trên toàn thế giới.

Tĩnh chuyên dụng từ $1.9/tháng

Một địa chỉ IP được cấp cho bạn, lưu lượng truy cập không giới hạn

Tĩnh chia sẻ từ $0.5/tháng

Bể chung – giải pháp tiết kiệm chi phí cho các công việc đơn giản

Tìm hiểu thêm về các máy chủ proxy trung tâm dữ liệu
Cách thức hoạt động

Các địa chỉ IP này được lưu trữ tại các trung tâm dữ liệu, không kết nối trực tiếp với người dùng tại nhà hay người dùng di động. Chúng rẻ hơn và nhanh hơn so với các địa chỉ IP dành cho hộ gia đình, nhưng các hệ thống chống bot có thể nhận diện chúng là không phải do con người điều khiển, vì vậy hãy sử dụng chúng trong những trường hợp mà yếu tố tin cậy không phải là vấn đề then chốt.

Phù hợp nhất cho
  • Trích xuất dữ liệu với khối lượng lớn từ các trang web thân thiện
  • Công cụ nội bộ và thử nghiệm tải
  • Các điểm cuối API không có bộ lọc tin cậy IP
  • Các tác vụ mà tốc độ quan trọng hơn việc ngụy trang
Thông số kỹ thuật
  • Hơn 2 triệu địa chỉ IPv4 và IPv6
  • Cấu hình chuyên dụng hoặc chia sẻ
  • Băng thông không giới hạn trên các gói chuyên dụng
  • Hỗ trợ các giao thức HTTPS, SOCKS5
  • Độ trễ thấp nhất trong cả ba loại
Chọn máy chủ proxy phù hợp với nhu cầu của bạn → Yêu cầu đăng nhập
Đạo đức · Không thể thỏa hiệp

Đạo đức là một phần không thể tách rời trong cách chúng tôi vận hành nền tảng của mình

Mã nguồn mở chỉ là điểm khởi đầu. Cách thu thập dữ liệu và cách tìm nguồn cung cấp máy chủ proxy cũng quan trọng không kém. Đây là những tiêu chuẩn mà chúng tôi tuân thủ trong thực tế, chứ không chỉ là những tuyên bố trên trang web.

Thu thập dữ liệu tuân thủ đạo đức

Chúng tôi phát triển các công cụ, chứ không phải các lỗ hổng. Yozh Scraper được thiết kế để đảm bảo việc trích xuất dữ liệu công khai một cách hợp pháp diễn ra đáng tin cậy — chứ không phải để xâm phạm những thông tin cần được bảo mật.

  • Chỉ dữ liệu công khai — theo mặc định, không cho phép thu thập dữ liệu khi đã đăng nhập
  • Các giới hạn tốc độ tích hợp sẵn giúp ngăn chặn tình trạng quá tải máy chủ
  • Mặc định tuân thủ robots.txt và sơ đồ trang web (có thể thay đổi)
  • Không thu thập hay lưu trữ thông tin nhận dạng cá nhân (PII) — cả từ phía chúng tôi lẫn theo mặc định đối với người dùng
  • Các công cụ giúp bạn tuân thủ các quy định của GDPR và CCPA

Mạng proxy trong suốt

Nguồn gốc của các địa chỉ IP dân dụng chính là thước đo độ trung thực đối với mọi nhà cung cấp dịch vụ proxy. Dưới đây là nguồn gốc cụ thể của các địa chỉ IP của chúng tôi — được nêu rõ ràng như sau:

  • Mạng lưới tham gia tự nguyện. Người dùng thực sự đồng ý và kiếm tiền khi chia sẻ băng thông
  • Hủy đăng ký chỉ với một cú nhấp chuột bất cứ lúc nào, không cần giải thích lý do
  • Chuỗi cung ứng đã được kiểm toán với quy trình tìm nguồn cung ứng được ghi chép đầy đủ
  • Hoàn toàn không có phần mềm độc hại, hoàn toàn không có việc chèn SDK ẩn — chưa từng xảy ra
  • Các địa chỉ IP di động từ các thiết bị do chúng tôi sở hữu và vận hành, chứ không phải từ các điện thoại di động đã bị xâm nhập

Phản ứng nhanh chóng trước các hành vi lạm dụng

Nếu có ai đó lạm dụng cơ sở hạ tầng của chúng tôi để gây hại cho người khác, chúng tôi muốn biết — và sẽ có biện pháp xử lý trước khi tình hình trở nên tồi tệ hơn.

  • Đường dây trực tiếp đến nhân viên thực sự, không phải hệ thống xếp hàng qua phiếu yêu cầu
  • Quy trình điều tra minh bạch đối với mọi báo cáo hợp lệ
  • Hợp tác tích cực với các cơ quan thực thi pháp luật trong các trường hợp đã được xác nhận
  • Chính sách về lạm dụng công khai, không bị giấu trong những dòng chữ nhỏ li ti
abuse-reports@cyberyozh.com
Thời gian phản hồi trung bình: 45 phút

Nếu một trường hợp sử dụng liên quan đến việc lạm dụng hoặc gây hại, các công cụ của chúng tôi không được thiết kế để phục vụ mục đích đó. Chúng tôi ưu tiên việc sử dụng có trách nhiệm hơn là việc mở rộng quy mô khách hàng.

Nếu một trường hợp sử dụng đòi hỏi phải che giấu danh tính nhằm gây hại cho người khác, các công cụ của chúng tôi không dành cho mục đích đó. Chấm hết. Chúng tôi thà mất khách hàng còn hơn là đánh mất nguyên tắc.

Được các đội ngũ phân tích dữ liệu và các nhà phát triển AI yêu thích

Những người đang phát triển ứng dụng với Yozh nói gì

5,0 / 5 · 5 đánh giá
GitHub
Chỉ trong một buổi chiều, chúng tôi đã thay thế cụm Playwright nội bộ bằng Yozh. Điểm cuối MCP được tích hợp trực tiếp vào tác nhân Claude của chúng tôi — không cần viết mã kết nối, trình thu thập dữ liệu và trình trích xuất dữ liệu đều hoạt động ngay lập tức.
Marcus Reinhardt Kỹ sư Dữ liệu Trưởng Northwind Analytics
X
Hệ thống cài đặt sẵn chính là tính năng nổi bật nhất. Chúng tôi chỉ cần truyền vào tên nguồn là sẽ nhận lại được dữ liệu JSON đã được làm sạch; tính năng tự khắc phục lỗi thậm chí còn phát hiện ra hai thay đổi về bố cục của Amazon trước khi chúng tôi kịp nhận ra.
Priya Nair Người sáng lập ScrapeStack
Reddit
Cuối cùng thì cũng có một công cụ thu thập dữ liệu mã nguồn mở coi các máy chủ proxy và phiên làm việc là yếu tố then chốt. Chúng tôi triển khai công cụ này để truy cập các cổng thông tin đối tác có yêu cầu đăng nhập — các phiên làm việc được duy trì và kết quả luôn nhất quán trên các khu vực.
Daniel Osei Kỹ sư hệ thống phía máy chủ Loopfeed
X
Sau khi kết nối với Cursor qua MCP, hiện tại agent của tôi có thể lấy dữ liệu web thời gian thực ngay trong quá trình thực hiện tác vụ. Tính năng thu thập dữ liệu theo thời gian thực qua SSE chính là điều mà các quy trình làm việc của agent còn thiếu.
Elena Kovac Kỹ sư Trí tuệ nhân tạo Vektor Labs
GitHub
Chúng tôi đã ngừng sử dụng một API trích xuất dữ liệu trả phí để cắt giảm chi phí và chuẩn bị tinh thần cho việc chất lượng dịch vụ sẽ giảm sút — nhưng kết quả lại hoàn toàn ngược lại. Hệ thống tự vận hành, không tính phí theo từng yêu cầu, và cấu trúc dữ liệu đầu ra còn gọn gàng hơn so với dịch vụ mà trước đây chúng tôi phải trả tiền để sử dụng.
Sofia Almeida Trưởng phòng Kỹ thuật Tabbly
Nhật ký thay đổi

Nhật ký thay đổi và các bản cập nhật về trích xuất dữ liệu web

Yozh Scraper là một dự án mã nguồn mở, với tất cả các bản cập nhật đều có sẵn trên GitHub. Dưới đây là những điểm nổi bật mới nhất.

v0.1.13 16 Tháng 9 2026 Latest

v0.1.13

  • Row-scoped extraction. An extract rule takes a container selector; every
  • device=legacy_wap — a feature-phone identity that unlocks Google's no-JS
  • resolve_redirects — names extracted fields whose values are the page's
  • New built-in presets: ozon_search, ozon_product, mobile_de_search,
  • A warning when a search engine answered a different query than the one asked.
v0.1.12 1 Tháng 9 2026

v0.1.12

  • Every built-in preset now ships as an explicit per-engine variant, <name>_chromium and <name>_camoufox (e.g. google_search_chromium, yandex_search_camoufox). A request names the exact variant it wants; each preset carries its own browser_engine.
  • Structured, correlated logging: business events get stable names and a request/job correlation id threaded through the scrape -> queue -> browser chain, so success/error rate and latency are answerable from logs. An opt-in JSON log shape is available via LOG_FORMAT=json (default text).
  • Browser egress policy knobs: an EGRESS_ALLOW_HOSTS allowlist (empty by default) and an EGRESS_TRANSPORT_GUARD toggle (on by default).
  • BREAKING (presets): the old single-name built-ins (google_search, google_shopping, amazon_product, amazon_search, bing_search, ebay_search, linkedin_profile, walmart_product, yandex_search, youtube_video) are replaced by their per-engine variants. A request using a bare old name now returns 404 preset_not_found; append the engine suffix (_chromium, or _camoufox for the two anti-bot targets yandex_search and walmart_product).
  • BREAKING (deploy): GET /api/v1/proxies/available and the entire /api/v2/prem-proxies/* catalog now require SERVICE_TOKEN and fail closed (503 when the token is unconfigured, 401 without it). Any consumer of these endpoints must send the X-Service-Token header; deploy the consumer first, or its calls degrade (for the proxy geo catalog, silently).
v0.1.11 25 Tháng 8 2026

v0.1.11

  • The job results response carries unreadable_slots. A job with one corrupt or schema-skewed result slot now returns its other pages (HTTP 200) and names the bad slot, instead of the whole job failing with a 500 and becoming un-cancellable until its TTL expires.
  • The login-replay page is masked with the same host-aligned WebGL/GPU, native-looking navigator, and Client-Hints (Sec-CH-UA) as the main fetch path, via a shared page-preparation helper. A credentialed login no longer submits a contradictory fingerprint (previously a macOS GPU and a HeadlessChrome Client-Hint under a Windows user agent).
  • Self-heal can no longer persist a degraded preset over a working one. It now contributes only the regenerated selector (and its dialect), keeping the preset's all / attr / post_process and required fields, and it is graded against the original contract — so a heal that returns a bare string where a coerced list belongs is no longer counted as a recovery. It also never heals from a transient 5xx error page. This closes a class of silent preset corruption.
  • Proxy credentials are kept out of logs, error messages and 502 response bodies. The SOCKS bridge, the rotating-credentials response and the username log no longer emit user:pass; a shared redactor masks proxy URLs while preserving host:port for diagnostics.
  • litellm is bounded <1.98: 1.98.0 imports NotRequired from typing unguarded and fails to import on the Python 3.10 this project targets, so a fresh install or image build would produce a container that cannot start.
v0.1.10 20 Tháng 8 2026

v0.1.10

  • Chromium WebGL now claims the host's actual GPU vendor/renderer, kept coherent with the Windows fingerprint the browser already presents, reusing the host-GPU detection from the Camoufox path (HOST_GPU_VENDOR). Without it the restored context reported a generic SwiftShader/ANGLE software-renderer string, itself an automation tell.
  • Chromium returned a null WebGL context on GPU-less / headless hosts (Chrome 136+ dropped the automatic SwiftShader fallback), and "no WebGL context at all" is a strong bot tell that real desktop Chrome never shows. A working software WebGL context is restored via --enable-unsafe-swiftshader, gated by the new SOFTWARE_WEBGL setting (default on, Chromium-only; revertible by env without a code change).
  • README now links the project site (data.cyberyozh.pro) with per-service pages for the scraper and crawler.
v0.1.0 9 Tháng 7 2026 First release

v0.1.0 - Durable queue, Camoufox engine & CyberYozh proxy v2

  • New required services. Browsers no longer run inside the API process. You must now run the redis and scraper-worker services (both are already in docker-compose.yml). Scale capacity with docker compose up -d --scale scraper-worker=N.
  • POST /scrape/page and /scrape/pages can now return 503 queue_full when the Redis stream depth exceeds QUEUE_MAXSIZE (previously the in-memory queue was unbounded).
  • Removed env vars (ignored, warned at startup if set): JOB_TIMEOUT_MS → use PAGE_TASK_TIMEOUT_S; JOB_RESULT_MAX → eviction is now a native Redis TTL (JOB_RESULT_TTL_S); JOBS_ENABLED → the queue is always on.
  • New env vars: REDIS_URL, PAGE_TASK_TIMEOUT_S, LOGIN_TASK_TIMEOUT_S, LOGIN_RESULT_GRACE_S, RECLAIM_IDLE_S, JOB_RESULT_TTL_S, BROWSER_MAX_PAGES, BROWSER_IDLE_SHUTDOWN_S, WARMUP_DWELL_MS.
  • The in-process job queue and browser worker pool are replaced by a taskiq stream on Redis. The web-scraper container only enqueues page tasks and reads results; browsers run in separate, horizontally scalable scraper-worker containers.
Hướng dẫn nhanh

Bắt đầu trích xuất dữ liệu từ web chỉ trong vài giây

Chỉ cần ba lệnh là bạn đã có một công cụ thu thập dữ liệu và quét web đang hoạt động với các điểm cuối HTTP và MCP.

1 Sao chép
git clone https://github.com/\
  CyberYozh-data/yozh-scraper
cd yozh-scraper
2 Chạy
cp .env.example .env
docker compose up --build
3 Cạo
curl -X POST localhost:8000/api/v1/scrape/page \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com"}'
Tài liệu đầy đủ Kết nối với Claude / Cursor qua MCP →
Liên hệ · Hỗ trợ

Liên hệ với chúng tôi

Một người thật sẽ đọc tất cả các tin nhắn nhận được. Hãy chọn kênh phù hợp — Telegram là kênh nhanh nhất.

Văn phòng
Jurija Gagarina 231/329
Novi Beograd · Serbia
Hỗ trợ hai cấp, gần như 24/7 Đội trực tuyến đầu tiên làm việc gần như 24/7. Các kỹ sư cấp cao sẽ xử lý các trường hợp phức tạp.
Nguồn mở · Giấy phép MIT · 88 ★

Sẵn sàng để trích xuất dữ liệu chưa?

Yozh Crawler + Scraper là ứng dụng miễn phí. Miễn phí vĩnh viễn. Hãy đánh giá sao cho chúng tôi nếu ứng dụng này hữu ích — mỗi lượt đánh giá sao đều rất quan trọng.

Yozh Crawler + Scraper được phát hành theo giấy phép MIT. Hãy sử dụng nó. Hãy tạo nhánh từ nó. Hãy phát triển dựa trên nó.