


GitHub
Заменили наш собственный кластер Playwright на Yozh за полдня. MCP-эндпоинт встал прямо в нашего Claude-агента — ноль связующего кода, краулер и скрейпер просто заработали.
Один опенсорсный инструмент для сбора данных и скрейпинга. Стартуйте с одного URL, обойдите сайт и получайте структурированные данные по мере загрузки страниц. Работает с MCP и инструментами вроде Claude и Cursor, с готовыми пресетами для маркетплейсов Amazon и eBay.
Yozh Crawler строит полную структуру сайта и обрабатывает страницы по мере их обнаружения. Вы получаете и охват, и готовые результаты за один прогон, без раздельных шагов обхода и скрейпинга. Работает прямо внутри ваших процессов сбора данных.
Стартуйте с одного URL и стройте карту всего сайта. Страницы находятся и обрабатываются за один прогон, так что вы получаете полный охват без лишних шагов.
Нужны только ссылки? Переключитесь в режим обнаружения и стройте карту сайта без парсинга. Быстрее, легче и полезно для аудита и проверок структуры.
Согласует заголовки, локацию и сигналы браузера с вашим прокси. Помогает держать сессии стабильными в разных регионах.
Запускайте сотни URL одним запросом. Обрабатывайте всё параллельно с одним чистым выводом.
Останавливайте задачи, не ломая результаты. Дайте активным страницам доработать или остановите всё мгновенно.
Подключайтесь напрямую к инструментам вроде Claude и Cursor. Используйте скрейпинг и обход как часть привычных процессов.
Amazon, eBay, Walmart, Google, Google Shopping, YouTube, LinkedIn, Bing, Yandex — передайте имя источника и параметры, получите нормализованный ответ. Никаких селекторов писать не нужно.
Сайт выкатил изменение вёрстки и ваши CSS-селекторы возвращают пусто? Парсер просит LLM (OpenAI / Anthropic / Gemini / OpenRouter) перегенерировать селектор на лету. Пайплайн продолжает работать.
Нужен сайт, для которого у нас нет пресета? Опишите, что извлечь, и вставьте пример URL — POST /api/v1/presets/generate вернёт готовый JSON пресета.
Войдите один раз через декларативный DSL (goto / fill / click / wait) или вставьте экспортированные cookies. Переиспользуйте сессию в каждом скрейпе. Обязательно для закрытых целей вроде пресета LinkedIn.
Настройте процесс в одном месте и запускайте его так, как нужно. Всё понятно, организованно и легко управляется без лишних инструментов.
Доступ к резидентским, мобильным и датацентр-прокси в 120+ странах. Более 50 миллионов IP при аптайме 99,9%. Включает поддержку фингерпринтинга для согласования устройства, браузера и сетевого поведения ради стабильных сессий и лучшего контроля.
Используйте CSS-селекторы, XPath или авто-определение для популярных сайтов. Получайте чистый структурированный JSON без сложной настройки.
Получайте сырой HTML, скриншоты и распарсенные данные вместе. Всё, что нужно, без переключения между инструментами.
Останавливайте задачи в любой момент одним кликом и переключайтесь между скрейпером и краулером. Ваш процесс остаётся простым и под контролем.
Подключите Yozh Crawler и Yozh Scraper к Claude, Cursor или любому MCP-клиенту. Переключайте инструменты одним тумблером, без лишнего кода.
Все возможности Yozh Scraper доступны как функции для вашего агента, включая скрейпинг, пакетные прогоны и скриншоты.
Скопируйте конфиг, перезапустите клиент — и готово.
Claude Desktop, Cursor, Cline или кастомные агенты.
Выбирайте, как агент выполняет задачи — от отдельных страниц до целых пакетов.
Используйте локальный MCP-сервер или разверните его на своей инфраструктуре.
// ~/Library/Application Support/Claude/claude_desktop_config.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cursor → Settings → MCP → Add new MCP Server
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp"
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp"
    }
  }
}
// Cline → MCP Servers → Edit cline_mcp_settings.json
{
  "mcpServers": {
    "yozh-scraper": {
      "type": "http",
      "url":  "http://localhost:8000/mcp",
      "disabled": false
    },
    "yozh-crawler": {
      "type": "http",
      "url":  "http://localhost:8001/mcp",
      "disabled": false
    }
  }
}
// Anthropic Messages API · MCP via Streamable HTTP
// Note: scraper must be reachable from Anthropic's servers (deploy publicly)
import Anthropic from "@anthropic-ai/sdk";

const response = await new Anthropic().messages.create({
  model: "claude-opus-4-8",
  mcp_servers: [
    { type: "url", url: "https://your-host/mcp", name: "yozh-scraper" },
    { type: "url", url: "https://your-host:8001/mcp", name: "yozh-crawler" }
  ],
  messages: [...]
});
Yozh Crawler стартует с одного URL, находит страницы по всему сайту и обрабатывает их по мере загрузки — вы получаете полную структуру и готовые данные за один прогон.
Страницы появляются по мере обнаружения и обработки. Подключайтесь напрямую из клиента, агента или пайплайна, не дожидаясь полного прогона.
Нужны только ссылки? Стройте карту сайта без парсинга. Быстрее и экономичнее для проверок структуры и аудита.
Безопасно останавливайте задачи. Дайте активным страницам доработать или остановите всё мгновенно, когда нужно.
Переключайтесь между скрейпером и краулером одним тумблером. Ваш агент использует правильный инструмент под каждую задачу.
Смотрите, как структура сайта строится в реальном времени. Следите за прогрессом страница за страницей, не покидая дашборд.
| URL | Parent | Depth | Status | Took |
|---|
Краулер находит страницы, скрейпер их обрабатывает, а ваш ИИ-агент использует результаты — подходит и новичкам, и экспертам.
Находит все URL
Извлекает в JSON
Анализирует и решает
Отслеживайте каталоги, цены и характеристики товаров конкурентов в одном месте. Находите пробелы в своих листингах и быстрее реагируйте на изменения рынка.
Автоматически отслеживайте изменения цен на маркетплейсах. Настройте оповещения и получайте уведомления в Telegram или Slack при изменении цен.
Собирайте чистые структурированные датасеты из публичных источников, готовые для анализа или обучения моделей. Создано для надёжного сбора данных в масштабе.
Локали, валюты, селекторы и обработка антибота — уже настроены. Выберите пресет, чтобы увидеть, что извлекается.
All fields below are extracted automatically — no selectors to write.
Откройте issue на GitHub или предложите свой пресет — мы рассматриваем PR в течение недели.
Три типа, шесть конфигураций. Выбирайте по задаче, скорости и бюджету.
Настоящие мобильные устройства в сетях операторов. Наивысший уровень доверия для строгих анти-бот систем.
Личное устройство, ручная ротация IP через API
Одно устройство, несколько пользователей
Каждый IP — с настоящего смартфона или LTE/5G-модема, подключённого к крупному мобильному оператору. IP используется тысячами обычных абонентов, поэтому его блокировка заблокировала бы реальных людей — именно поэтому анти-бот системы доверяют мобильным IP больше всего.
IP реальных домашних интернет-пользователей в 120+ странах. Доступ к 50M+ IP с отличным балансом доверия и цены.
Настоящие роутеры, фиксированный IP на весь срок аренды
Пул 100M+ IP, авторотация по таймеру или на каждый запрос
Резидентные IP берутся у реальных домашних интернет-абонентов, которые добровольно делятся трафиком за вознаграждение через прозрачную opt-in сеть. Их соединение выглядит как у любого домашнего пользователя — потому что так и есть.
Максимальная скорость, минимальная цена. 2M+ IP в дата-центрах по всему миру.
Один IP закреплён за вами, безлимитный трафик
Общий пул, бюджетный вариант для простых задач
IP размещены в дата-центрах и не связаны с домашними или мобильными пользователями. Они дешевле и быстрее резидентных, но анти-бот системы могут распознать их как не-человеческие, поэтому используйте их там, где доверие не критично.
Открытый код — это лишь отправная точка. То, как собираются данные и откуда берутся прокси, важно не меньше. Это стандарты, которым мы следуем на практике, а не заявления на странице.
Мы строим инструменты, а не лазейки. Yozh Scraper сделан так, чтобы легитимный скрейпинг публичных данных был надёжным — а не чтобы взламывать то, что должно оставаться закрытым.
Откуда берутся резидентские IP — тест на честность для любого прокси-провайдера. Вот откуда берутся наши, прямо:
Если кто-то использует нашу инфраструктуру во вред другим, мы хотим об этом знать — и среагировать, пока не стало хуже.
Если сценарий предполагает злоупотребление или вред, наши инструменты не для него. Ответственное использование для нас важнее роста клиентской базы.
Если сценарию нужно скрывать личность, чтобы вредить другим, наши инструменты не для этого. Точка. Мы скорее потеряем клиента, чем принцип.
Понятные правила, определяющие то, как мы работаем, — от сбора данных до происхождения прокси и использования платформы. Это реальные политики, которым следует команда, а не краткие пересказы.
Определяет, что разрешено в нашей инфраструктуре, а что ограничено, с чётким обоснованием.
Объясняет, как жалобы рассматриваются, обрабатываются и разрешаются, включая сроки реагирования.
Подробно описывает, как формируется пул резидентных и мобильных IP, с моделью добровольного согласия и проверенными источниками.
Охватывает онбординг, случаи, когда требуется верификация, и порядок обработки данных пользователей.
Перечисляет заблокированные домены и сценарии использования, включая чувствительные отрасли, такие как госсектор и финансы.
Объясняет, какие данные собираются, какие не хранятся, сроки хранения и передачу третьим сторонам.
Автоматизируйте масштабный сбор публичных данных: каталоги товаров, рейтинги, отзывы, гео-данные. Yozh Scraper плюс резидентские прокси — легально, стабильно и чисто.
Читать далее
Стройте автономных агентов, которые скрейпят, анализируют и действуют. Интеграция MCP превращает Yozh Scraper в нативный инструмент для Claude и Cursor — без кастомной интеграции.
Читать далее
Отслеживайте цены, остатки и наличие товаров на Amazon, eBay и остальных маркетплейсах мира. Пресеты экономят недели разработки.
Читать далее
"CyberYozh stands out as a powerful platform for affiliates and arbitrage teams, combining reliable proxy infrastructure, identity tools, and strong support in one ecosystem."
"CyberYozh App enables businesses to launch, test, and operate digital products across more than 30 countries through a scalable infrastructure built for global connectivity, verification, and digital operations."
"Built for organizations that rely on proxies every day, CyberYozh App delivers infrastructure designed for stability, scalability, and high-volume workloads rather than one-off sessions."
Что говорят те, кто строит на Yozh
Заменили наш собственный кластер Playwright на Yozh за полдня. MCP-эндпоинт встал прямо в нашего Claude-агента — ноль связующего кода, краулер и скрейпер просто заработали.
Система пресетов — киллер-фича. Передаём имя источника и получаем чистый JSON; самовосстановление даже поймало два изменения вёрстки Amazon раньше нас.
Наконец-то опенсорсный скрейпер, для которого прокси и сессии — первоклассные сущности. Гоняем его за логин-стенами партнёрских порталов — сессии живут, результаты стабильны в разных регионах.
Подключил к Cursor через MCP, и теперь мой агент тянет живые веб-данные прямо посреди задачи. Стриминговый обход по SSE — именно то, чего не хватало агентным сценариям.
Ушли с платного API скрейпинга ради экономии и готовились к откату по качеству — получили обратное. Self-hosted, без оплаты за запрос, а схема вывода чище, чем та, за которую мы платили.
Современные целевые сайты безжалостно отклоняют автоматизированные запросы. Вы запускаете краулер для сбора данных с товарного каталога. Система защиты моментально сканирует ваш TLS-отпечаток. Она проверяет порядок следования…
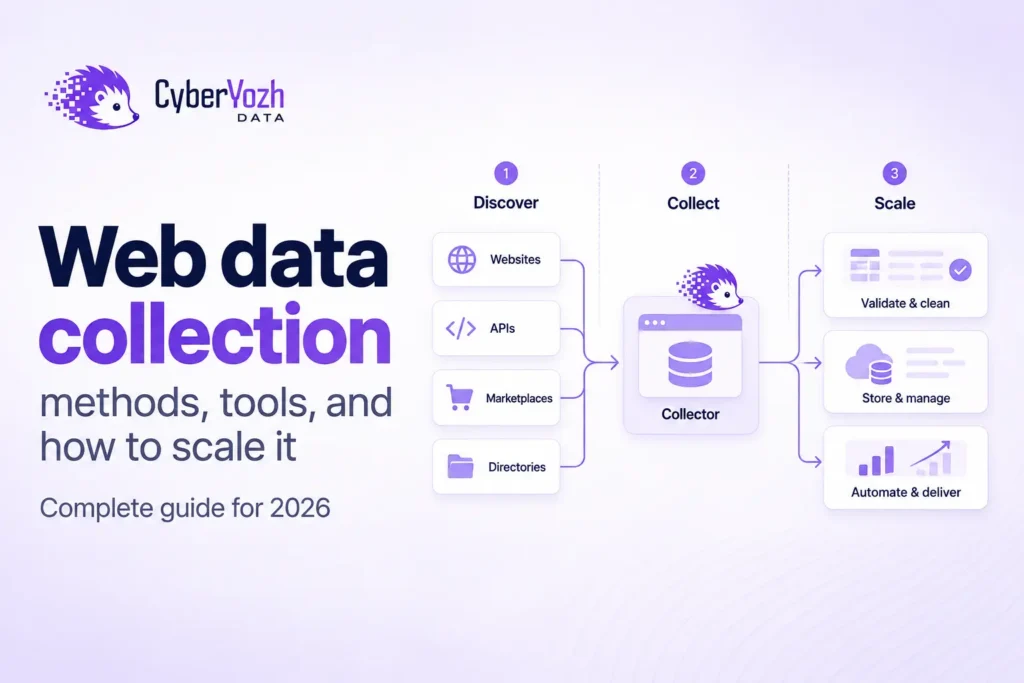
Узнайте, как устроен сбор данных с веб-сайтов, какие методы подходят для разных сайтов, какие инструменты для этого нужны и как автоматизировать надёжный сбор данных в промышленных…
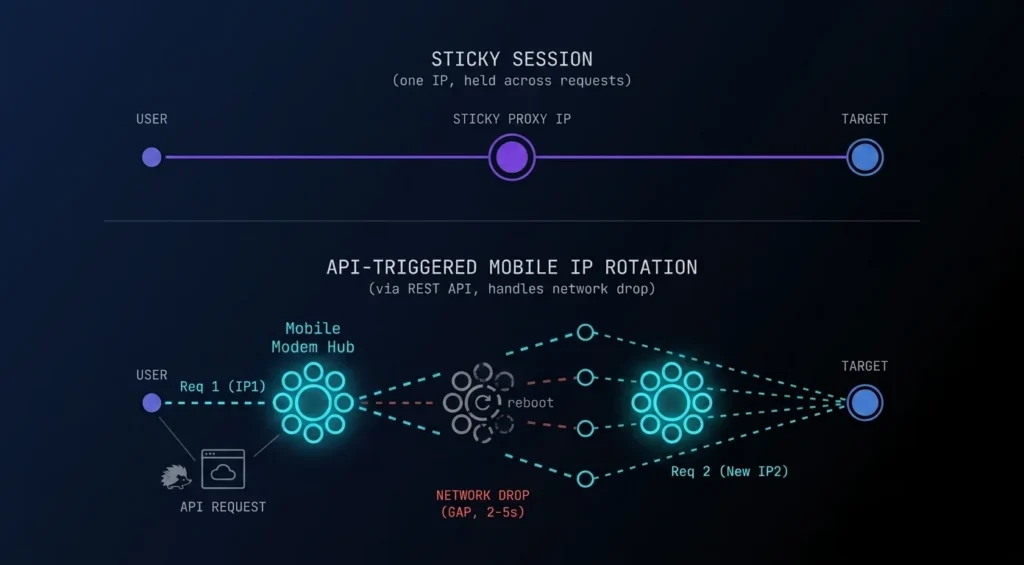
TL;DR: Отказ от тяжёлых браузеров Браузерная автоматизация несёт колоссальные вычислительные издержки. Безголовые браузеры потребляют гигабайты оперативной памяти. Они рендерят ненужные элементы DOM-дерева. Они вызывают пиковые нагрузки…
Yozh Scraper — опенсорсный, все обновления доступны на GitHub. Вот последние ключевые изменения.
container selector; everydevice=legacy_wap — a feature-phone identity that unlocks Google's no-JSresolve_redirects — names extracted fields whose values are the page'sozon_search, ozon_product, mobile_de_search,<name>_chromium and <name>_camoufox (e.g. google_search_chromium, yandex_search_camoufox). A request names the exact variant it wants; each preset carries its own browser_engine.LOG_FORMAT=json (default text).EGRESS_ALLOW_HOSTS allowlist (empty by default) and an EGRESS_TRANSPORT_GUARD toggle (on by default).google_search, google_shopping, amazon_product, amazon_search, bing_search, ebay_search, linkedin_profile, walmart_product, yandex_search, youtube_video) are replaced by their per-engine variants. A request using a bare old name now returns 404 preset_not_found; append the engine suffix (_chromium, or _camoufox for the two anti-bot targets yandex_search and walmart_product).GET /api/v1/proxies/available and the entire /api/v2/prem-proxies/* catalog now require SERVICE_TOKEN and fail closed (503 when the token is unconfigured, 401 without it). Any consumer of these endpoints must send the X-Service-Token header; deploy the consumer first, or its calls degrade (for the proxy geo catalog, silently).unreadable_slots. A job with one corrupt or schema-skewed result slot now returns its other pages (HTTP 200) and names the bad slot, instead of the whole job failing with a 500 and becoming un-cancellable until its TTL expires.navigator, and Client-Hints (Sec-CH-UA) as the main fetch path, via a shared page-preparation helper. A credentialed login no longer submits a contradictory fingerprint (previously a macOS GPU and a HeadlessChrome Client-Hint under a Windows user agent).all / attr / post_process and required fields, and it is graded against the original contract — so a heal that returns a bare string where a coerced list belongs is no longer counted as a recovery. It also never heals from a transient 5xx error page. This closes a class of silent preset corruption.user:pass; a shared redactor masks proxy URLs while preserving host:port for diagnostics.litellm is bounded <1.98: 1.98.0 imports NotRequired from typing unguarded and fails to import on the Python 3.10 this project targets, so a fresh install or image build would produce a container that cannot start.HOST_GPU_VENDOR). Without it the restored context reported a generic SwiftShader/ANGLE software-renderer string, itself an automation tell.--enable-unsafe-swiftshader, gated by the new SOFTWARE_WEBGL setting (default on, Chromium-only; revertible by env without a code change).data.cyberyozh.pro) with per-service pages for the scraper and crawler.redis and scraper-worker services (both are already in docker-compose.yml). Scale capacity with docker compose up -d --scale scraper-worker=N.POST /scrape/page and /scrape/pages can now return 503 queue_full when the Redis stream depth exceeds QUEUE_MAXSIZE (previously the in-memory queue was unbounded).JOB_TIMEOUT_MS → use PAGE_TASK_TIMEOUT_S; JOB_RESULT_MAX → eviction is now a native Redis TTL (JOB_RESULT_TTL_S); JOBS_ENABLED → the queue is always on.REDIS_URL, PAGE_TASK_TIMEOUT_S, LOGIN_TASK_TIMEOUT_S, LOGIN_RESULT_GRACE_S, RECLAIM_IDLE_S, JOB_RESULT_TTL_S, BROWSER_MAX_PAGES, BROWSER_IDLE_SHUTDOWN_S, WARMUP_DWELL_MS.web-scraper container only enqueues page tasks and reads results; browsers run in separate, horizontally scalable scraper-worker containers.Три команды — и у вас работающий скрейпер + краулер с HTTP- и MCP-эндпоинтами.
git clone https://github.com/\
  CyberYozh-data/yozh-scraper
cd yozh-scraper
cp .env.example .env
docker compose up --build
curl -X POST localhost:8000/api/v1/scrape/page \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com"}'
Живой человек читает всё, что приходит. Выберите удобный канал — Telegram самый быстрый.
Yozh Crawler + Scraper бесплатны. Навсегда. Поставьте звезду, если помогает — каждая звезда на счету.
Yozh Crawler + Scraper распространяются под лицензией MIT. Используйте. Форкайте. Создавайте на их основе.