


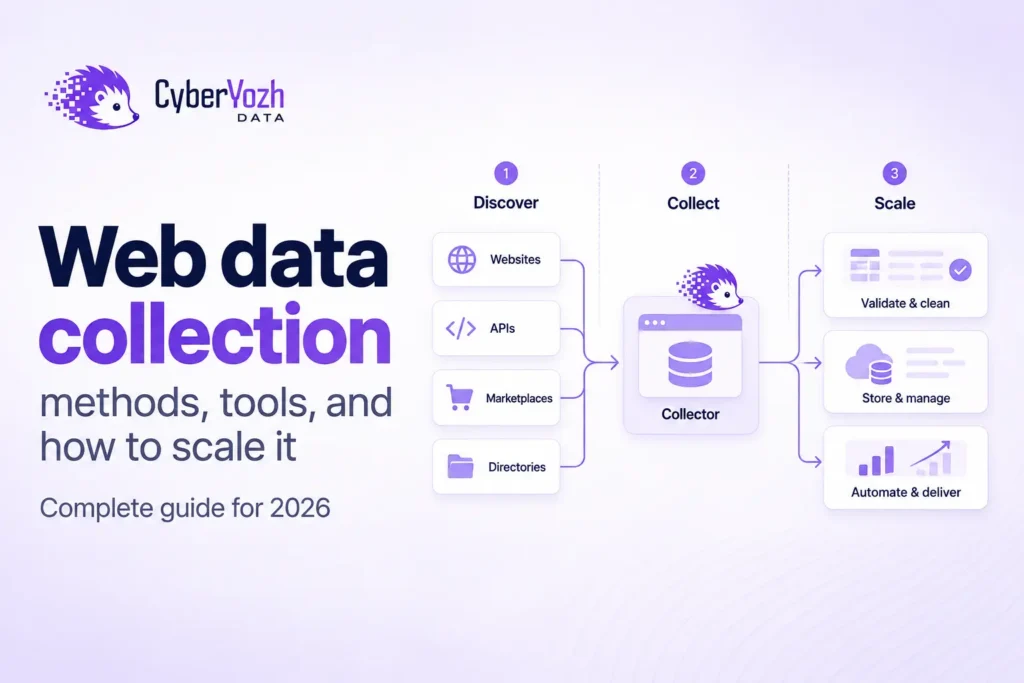
网络数据采集是将网络上发布的信息转化为可搜索、比较、分析或发送到其他系统的数据的过程。一个完整的工作流不仅仅是抓取一个页面:它需要决定采集什么内容、找到正确的页面、获取这些页面、提取所需字段、检查结果、存储数据,并在需要新数据时重复这个过程。
这一范围很重要。一些文章使用网络数据采集来涵盖调查、客户分析或在线追踪。这些都是基于网络的有效研究形式,但它们与本文关注的从网站采集数据不同。竞争对手定价、产品目录、公开评论、搜索结果、招聘信息、文档和公开市场数据都是常见的例子。
快速回答:一个可靠的网络数据采集流水线是:定义数据 fb→ 选择数据源 → 发现URL → 获取或渲染页面 → 提取字段 → 验证记录 → 存储并监控下一次运行。
什么是网络数据采集?
网络数据采集是从网络来源获取有用信息并将其转化为数据集的端到端过程。网络抓取是这个过程的一部分,而不是整个过程的同义词。
通过将各项工作分开来看,这种区别最容易理解。爬取发现页面,获取下载或渲染这些页面,提取将页面内容转化为字段,验证检查这些字段是否可用,存储则将记录保存以供分析或供其他应用程序使用。
最近一项关于网络抓取的系统性综述,涵盖了301项主要研究,同样将该过程描述为查找和获取网页、提取有用信息,并将其转化为JSON或CSV等结构化格式。
这种区分也使故障更容易诊断。如果一个数据集缺失了半个目录,问题可能出在发现环节而不是提取环节。如果每个URL都被访问了但价格字段为空,那么爬虫可能没有问题,而是提取规则出了故障。
网络数据采集的五种主要方法是什么?
没有一种最佳采集方法适用于所有网站。正确的选择取决于数据在哪里公开、变化的频率如何、是否需要JavaScript,以及您是否已经知道哪些页面包含所需记录。
| 方法 | 最适用场景 | 主要权衡 |
| 官方API或数据源 | 数据源直接公开您需要的字段 | 覆盖范围、配额或数据结构可能受限 |
| 数据集、存档或导出 | 您需要历史数据或一次性数据 | 可能不够新,无法用于监控 |
| 直接HTTP + 解析器 | 数据以可预测的HTML形式呈现 | 无法看到仅在浏览器端JavaScript运行后才生成的内容 |
| 基于浏览器的抓取 | 页面需要JavaScript渲染或允许的交互操作 | 更高的CPU、内存和运行时成本 |
| 爬虫 + 抓取器 | 必须在提取之前先在整个网站中发现页面 | 需要范围界定、去重、速率限制和监控 |
AI辅助提取也很有用,但更适合被视为这些方法内部的一种技术,而不是第六种访问方法。大语言模型(LLM)可以帮助推断数据结构或恢复选择器,但它仍然是在首先必须被发现和获取的内容上进行工作。AI网络抓取在支持受控提取流程时最为有用,而不是取代验证。
如果官方API公开了您所需的确切字段和数据新鲜度,请从那里开始。如果没有,网络抓取API服务、自定义HTTP提取、浏览器自动化,或爬虫与抓取器的组合,可能会提供缺失的覆盖范围。
如何通过七个步骤采集网络数据?
一个可重复的工作流是从数据契约开始,而不是从选择抓取工具开始。这样可以使项目专注于您需要的结果,而不是恰好方便使用的工具。
- 定义字段。确定一条有效记录应包含哪些内容,例如标题、价格、货币、source_url和retrieved_at。
- 选择数据源。确定包含这些字段的页面、API、数据源、存档或域名。
- 发现URL。当页面尚未确定时,使用已知的URL列表、站点地图、搜索或爬虫。
- 获取内容。尽可能使用直接HTTP,仅在确实需要JavaScript时才使用浏览器渲染。
- 提取字段。将HTML、JSON、结构化标记、CSS/XPath匹配结果或其他源数据解析为你的数据结构。
- 验证并去重。检查必填字段、允许的格式、重复项、意外的空值,以及该记录是否真的对应你想要采集的页面。
- 存储与监控。将结果连同来源信息一并保存,再根据数据源的变化速度安排下一次运行。
最后这一步,正是将一次性抓取转变为自动化网络数据采集的关键。更广泛的网络抓取自动化问题还包括重试、调度、队列、故障处理,以及当数据源发生变化时应如何应对。
网络数据采集使用哪些工具?
大多数生产系统使用若干个小工具,而不是一个包办一切的工具。有用的分类包括发现、检索、提取、验证、编排和存储。
爬虫负责URL发现和抓取范围。HTTP客户端或浏览器负责获取页面。解析器和提取规则将内容转化为数据。验证代码检查数据结构和字段值。Cron、Airflow、Temporal、队列或类似的编排工具决定任务何时运行,而数据库、对象存储和数据仓库则负责保存记录。
对于面向公开网络的分析流水线,通常最好将采集与存储分开。网络抓取分析模式让采集层生成JSON,而你现有的Postgres、BigQuery、Snowflake、Kafka或其他数据技术栈仍负责后续处理。
哪种网络数据采集方法最好?
最好的方法是能够可靠返回项目所需字段、覆盖范围和时效性的最简单方案。浏览器并不天然优于直接请求,而当你已经拥有完整的URL列表时,爬虫也是多余的。
一个实用的顺序是:先检查是否有合适的API或导出功能,再判断普通HTTP请求是否能获取到所需数据。只有当内容依赖JavaScript时才引入浏览器渲染,只有当发现环节本身是问题的一部分时才引入爬虫。这样可以让基础设施的复杂度与任务需求相匹配。
数据源本身也很重要。每日电商价格监控与每月一次的文档存档,或AI代理抓取单个当前页面,其需求各不相同。CyberYozh Data已针对电商平台和AI代理网络访问提供了更具体的案例,而本页则重点介绍它们所共有的采集架构。
网络数据采集扩展规模时会出现哪些问题?
在小规模场景下,明显的故障是请求超时或被拒绝。而在更大规模下,更危险的故障往往更隐蔽:请求成功了,任务完成了,但数据仍然是错的。
一个200 OK响应可能包含错误的地区版本、一个同意提示页面、一个空组件、一个改版后的产品布局,或者完全不同类型的页面。某个选择器在页面改版后可能依然能匹配到内容,但返回的却是旧价格、一个划线价,或是无关的字段。仅凭行数统计和请求成功率并不能发现这些问题。
这就是为什么应该以每次运行中的正确记录数来衡量扩展效果,而不是每秒请求数。有用的检查项包括必填字段检查、类型和取值范围验证、来源URL、抓取时间戳、重复率、可接受的空值率、与预期URL集合的覆盖情况,以及字段分布出现异常变化时的告警。
抓取质量同样需要单独关注。设置严格的页面数和深度限制,对URL进行规范化和去重,排除不相关的模式,并保持每个域名的请求速率保守。如果某项被允许的任务确实需要分布式或跨地域的网络路由,那就添加网络抓取代理——这是因为网络本身有此需求,而不仅仅是因为这项工作被称为“抓取”。抓取所用的代理类型应根据目标网站和流量模式来选择。
数据质量检查:一次成功的获取只能证明你收到了响应,并不能证明该记录是完整的、最新的,或语义正确的。
Yozh Crawler和Yozh Scraper如何实现流水线自动化?
CyberYozh Data 通过两个开源、自托管的服务将发现与提取分离开来。 Yozh Crawler 从种子 URL 开始,维护待爬取队列,对已发现的 URL 去重,应用范围规则,并通过 SSE 流式传输页面事件。 Yozh Scraper 负责获取页面,可以使用 Playwright 渲染 JavaScript,还可以通过 CSS 或 XPath 规则提取结构化数据。
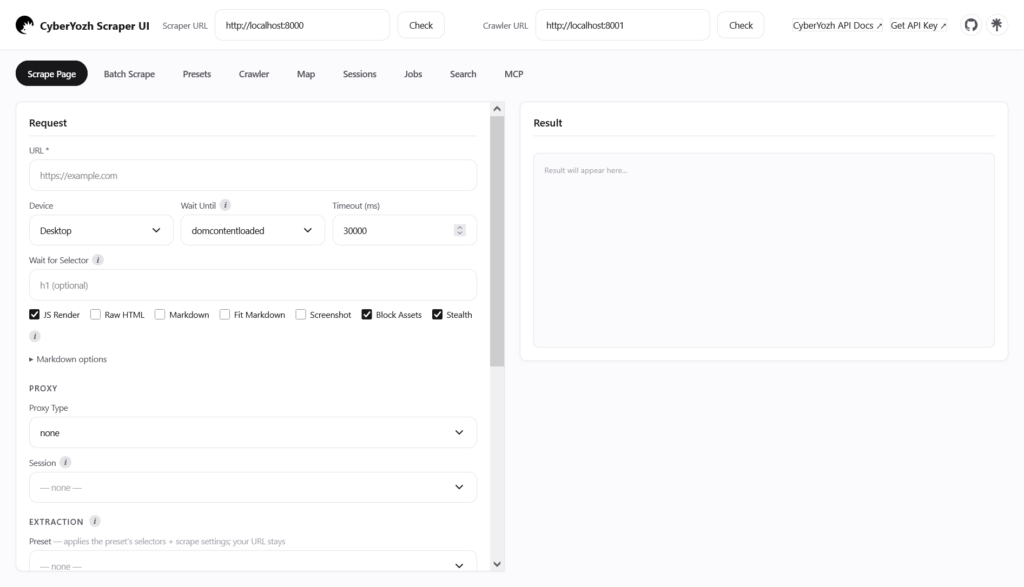
这种拆分直接对应于一个通用的采集流程:
种子 URL → 爬取与发现 → 获取或渲染 → 提取 → 验证 → 持久化
对于爬取任务,mode、include_patterns、exclude_patterns、max_depth、max_pages、per_domain_rps 和 per_domain_concurrency 等控制项定义了爬虫可以访问的范围以及速度。对于提取任务,Yozh Scraper 通过 /api/v1/scrape/pages 支持 render、wait_for_selector、extract、raw_html 以及批量请求。
有一些运行限制值得纳入设计考虑。Yozh Crawler v1 不对其端点进行身份验证,因此应将其部署在可信网络中或置于自有网关之后。爬取任务保存在内存中,而非作为长期数据存储,因此应将流数据或结果持久化到自己的系统中。代理路由是可选的:直接采集使用 proxy_type: none,而使用 CyberYozh 代理类型则需要 CYBERYOZH_API_KEY。
这有意不去替代你的数据库、调度器或验证层。它只是整个技术栈中负责发现与获取/提取的部分,这样在更改存储或编排方式时,无需重写采集器本身。
如何负责任地采集网络数据?
负责任的采集从发出第一个请求之前就开始了。要确认数据及其预期用途是被允许的,将采集范围限制在项目所需的内容内,避免收集不必要的个人或敏感数据,并且不要将爬虫设计为对目标服务造成过大压力。
robots.txt 是网站所有者发布爬虫指令的标准机制。 机器人排除协议规定了自动化客户端应如何解读这些规则,同时也明确指出机器人规则并不是一种访问授权形式。Yozh Crawler 当前的技术文档说明它不会自动查询 robots.txt,因此负责任的部署必须通过自身的爬取设计来检查并执行相关规则。
CyberYozh Data 的 使用政策与 受限目标政策提供了额外的平台边界。技术上可访问并不意味着获得许可,公开可见也不会消除隐私、版权、合同或特定司法管辖区的义务。
结语
理解网络数据采集的有效方式是将其视为一个数据系统,而非一段爬虫脚本。发现、获取、提取、验证、存储和监控解决的是不同的问题,将它们分开处理能让故障更容易被发现,也让整个流程更容易调整。
从你实际需要的字段和数据新鲜度出发。然后选择能够获取这些数据的最简单采集方法,验证返回的结果,并在扩大第一次运行规模之前先设计好第二次运行。
关于网络数据采集的常见问题
这些问题涵盖了其余的搜索词条,但不会将一般性的研究方法问题变成网络爬虫建议。重点始终放在从网站获取信息并将其转化为可用数据上。
什么是网络数据?
网络数据是通过网站、网络应用、API、信息源、文件或其他可通过互联网访问的来源获取的信息。它可以包括文本、价格、产品属性、公开评论、招聘信息、搜索结果、日期、链接、图片以及结构化元数据。
网络数据采集与网络爬虫是一回事吗?
不是。网络爬虫通常指的是获取与提取阶段,而网络数据采集还包括来源选择、页面发现、验证、存储、刷新和监控。因此,爬虫可以是一个更大采集系统中的一个组成部分。
人工智能能否自动完成网络数据提取?
人工智能可以帮助推断字段、生成提取规则、规范不一致的内容,或在页面布局变化时进行恢复。但它仍应受到模式(schema)的约束,并与原始来源进行核对,因为看似合理的输出并不等同于经过验证的输出。
自动化网络数据采集需要代理吗?
不一定。许多公开或合作性来源可以直接采集,尤其是在请求频率适中的情况下。当经过授权的工作流程有特定的网络路由或地理位置要求时,代理才具有相关性,应基于这一原因引入代理,而不是默认使用。