


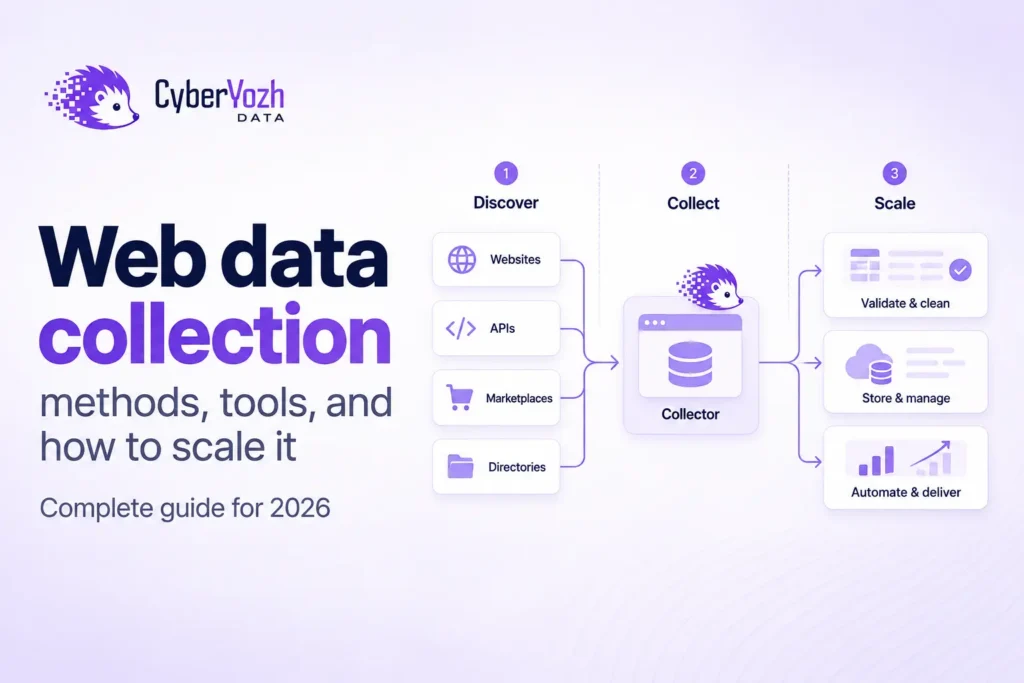
Thu thập dữ liệu web là quá trình biến thông tin được công bố trên web thành dữ liệu bạn có thể tìm kiếm, so sánh, phân tích hoặc gửi tới hệ thống khác. Một quy trình hoàn chỉnh không chỉ đơn giản là scrape một trang: nó phải xác định cần thu thập gì, tìm đúng trang, truy xuất chúng, trích xuất các trường dữ liệu cần thiết, kiểm tra kết quả, lưu trữ và lặp lại quá trình khi cần dữ liệu mới.
Phạm vi này rất quan trọng. Một số bài viết dùng cụm thu thập dữ liệu web để bao gồm cả khảo sát, phân tích khách hàng hoặc theo dõi trực tuyến. Đó đều là các hình thức nghiên cứu dựa trên web hợp lệ, nhưng chúng khác với thu thập dữ liệu từ website, vốn là trọng tâm của bài viết này. Giá cả đối thủ, danh mục sản phẩm, đánh giá công khai, kết quả tìm kiếm, danh sách việc làm, tài liệu và dữ liệu thị trường công khai là những ví dụ phổ biến.
Trả lời nhanh: Một pipeline thu thập dữ liệu web đáng tin cậy bao gồm: xác định dữ liệu \u2192 chọn nguồn \u2192 khám phá URL \u2192 truy xuất hoặc render trang \u2192 trích xuất trường dữ liệu \u2192 xác thực bản ghi \u2192 lưu trữ và giám sát cho lần chạy tiếp theo.
Thu thập dữ liệu web là gì?
Thu thập dữ liệu web là toàn bộ quá trình lấy thông tin hữu ích từ các nguồn web và chuyển đổi chúng thành một tập dữ liệu. Web scraping chỉ là một phần của quá trình đó, không phải là từ đồng nghĩa cho toàn bộ quá trình.
Sự khác biệt này dễ thấy nhất khi ta tách riêng từng công việc. Crawling khám phá các trang, truy xuất tải hoặc render chúng, trích xuất biến nội dung trang thành các trường dữ liệu, xác thực kiểm tra xem các trường đó có sử dụng được không, và lưu trữ giữ lại các bản ghi để phân tích hoặc dùng cho ứng dụng khác.\u00a0
Một đánh giá hệ thống gần đây về web scraping bao gồm 301 nghiên cứu gốc cũng mô tả quá trình này tương tự: tìm và truy xuất các trang web, trích xuất thông tin hữu ích, và biến chúng thành các định dạng có cấu trúc như JSON hoặc CSV.
Sự phân tách này cũng giúp việc chẩn đoán lỗi dễ dàng hơn. Nếu một tập dữ liệu bị thiếu một nửa danh mục, vấn đề có thể nằm ở khâu khám phá chứ không phải trích xuất. Nếu tất cả URL đều đã được truy cập nhưng trường giá lại trống, có thể crawler vẫn hoạt động bình thường trong khi quy tắc trích xuất bị lỗi.
Năm phương pháp chính để thu thập dữ liệu web là gì?
Không có một phương pháp thu thập nào là tốt nhất cho mọi website. Lựa chọn phù hợp phụ thuộc vào việc dữ liệu được hiển thị ở đâu, tần suất thay đổi của nó, có cần JavaScript hay không, và bạn đã biết trang nào chứa các bản ghi hay chưa.
| Phương pháp | Phù hợp nhất khi | Đánh đổi chính |
| API hoặc feed chính thức | Nguồn dữ liệu cung cấp trực tiếp các trường bạn cần | Phạm vi bao phủ, hạn ngạch hoặc schema có thể bị giới hạn |
| Tập dữ liệu, kho lưu trữ hoặc bản xuất | Bạn cần dữ liệu lịch sử hoặc dữ liệu một lần | Có thể không đủ mới để giám sát |
| HTTP trực tiếp + trình phân tích cú pháp | Dữ liệu hiện diện trong HTML có thể dự đoán được | Không thể thấy nội dung chỉ được tạo ra sau khi JavaScript phía trình duyệt chạy |
| Scraping dựa trên trình duyệt | Các trang yêu cầu render JavaScript hoặc tương tác được cho phép | Chi phí CPU, bộ nhớ và thời gian chạy cao hơn |
| Crawler + scraper | Các trang phải được khám phá trên toàn bộ site trước khi trích xuất | Cần phạm vi, loại bỏ trùng lặp, giới hạn tốc độ và giám sát |
Trích xuất hỗ trợ bởi AI cũng hữu ích, nhưng nên được xem là một kỹ thuật trong các phương pháp này hơn là một phương pháp truy cập thứ sáu. Một LLM có thể giúp suy luận ra schema hoặc khôi phục selector, nhưng nó vẫn hoạt động trên nội dung đã được khám phá và truy xuất trước đó. AI web scraping hữu ích nhất khi nó hỗ trợ một quy trình trích xuất có kiểm soát thay vì thay thế việc xác thực.
Nếu một API chính thức cung cấp đúng các trường và độ mới bạn cần, hãy bắt đầu từ đó. Khi không có, các dịch vụ web scraping API, trích xuất HTTP tùy chỉnh, tự động hóa trình duyệt, hoặc kết hợp crawler và scraper có thể lấp đầy phần dữ liệu còn thiếu.
Làm thế nào để thu thập dữ liệu web trong bảy bước?
Một quy trình có thể lặp lại bắt đầu với hợp đồng dữ liệu, chứ không phải với việc chọn một công cụ scraper. Điều này giúp dự án tập trung vào kết quả bạn cần thay vì công cụ nào đó tình cờ tiện dụng.
- Xác định các trường dữ liệu. Quyết định một bản ghi hợp lệ chứa những gì, chẳng hạn như title, price, currency, source_url và retrieved_at.
- Chọn nguồn. Xác định các trang, API, feed, kho lưu trữ hoặc tên miền chứa các trường dữ liệu đó.
- Khám phá URL. Sử dụng danh sách URL đã biết, sơ đồ trang (sitemap), tìm kiếm, hoặc một crawler khi các trang chưa được biết trước.
- Truy xuất nội dung. Sử dụng HTTP trực tiếp khi có thể và render bằng trình duyệt khi JavaScript thực sự cần thiết.
- Trích xuất các trường dữ liệu. Phân tích HTML, JSON, markup có cấu trúc, kết quả khớp CSS/XPath, hoặc dữ liệu nguồn khác theo schema của bạn.
- Xác thực và loại bỏ trùng lặp. Kiểm tra các trường bắt buộc, định dạng cho phép, dữ liệu trùng lặp, các giá trị null bất thường, và liệu bản ghi có thực sự đại diện cho trang bạn định thu thập hay không.
- Lưu trữ và giám sát. Lưu kết quả kèm nguồn gốc dữ liệu, sau đó lên lịch cho lần chạy tiếp theo tùy theo tốc độ thay đổi của nguồn.
Bước cuối cùng đó chính là thứ biến một lần cào dữ liệu đơn lẻ thành thu thập dữ liệu web tự động. Vấn đề rộng hơn về tự động hóa web scraping bao gồm việc thử lại, lập lịch, hàng đợi, xử lý lỗi, và quyết định điều gì nên xảy ra khi nguồn thay đổi.
Những công cụ nào được dùng để thu thập dữ liệu web?
Hầu hết các hệ thống sản xuất sử dụng nhiều công cụ nhỏ thay vì một công cụ làm được mọi thứ. Các danh mục hữu ích là phát hiện, truy xuất, trích xuất, xác thực, điều phối và lưu trữ.
Một crawler xử lý việc phát hiện URL và phạm vi crawl. Các HTTP client hoặc trình duyệt truy xuất các trang. Bộ phân tích (parser) và quy tắc trích xuất chuyển nội dung thành dữ liệu. Mã xác thực kiểm tra schema và giá trị các trường. Cron, Airflow, Temporal, hàng đợi hoặc các công cụ điều phối tương tự quyết định thời điểm chạy job, trong khi cơ sở dữ liệu, kho lưu trữ đối tượng và data warehouse lưu giữ các bản ghi.
Đối với các pipeline phân tích dữ liệu web công khai, thường tốt hơn nếu tách biệt việc thu thập khỏi việc lưu trữ. Mô hình phân tích dữ liệu web scraping cho phép lớp thu thập tạo ra JSON trong khi Postgres, BigQuery, Snowflake, Kafka hoặc data stack hiện có của bạn vẫn chịu trách nhiệm cho quá trình xử lý tiếp theo.
Phương pháp thu thập dữ liệu web nào là tốt nhất?
Phương pháp tốt nhất là phương pháp ít phức tạp nhất mà vẫn trả về đáng tin cậy các trường dữ liệu, độ bao phủ và độ mới mà dự án yêu cầu. Trình duyệt không tự động tốt hơn một request trực tiếp, và crawler là không cần thiết khi bạn đã có danh sách URL đầy đủ.
Một trình tự thực tế là trước tiên kiểm tra xem có API hoặc export phù hợp không, sau đó xem xét liệu HTTP thông thường có hiển thị dữ liệu hay không. Chỉ thêm việc render trình duyệt cho nội dung phụ thuộc vào JavaScript, và chỉ thêm crawling khi việc phát hiện là một phần của vấn đề. Điều này giữ cho hạ tầng tương xứng với công việc.
Nguồn dữ liệu cũng quan trọng. Một hệ thống giám sát giá marketplace hàng ngày có yêu cầu khác với một kho tài liệu hàng tháng hoặc một AI agent lấy về một trang hiện tại. CyberYozh Data đã có các ví dụ cụ thể hơn cho sàn thương mại điện tử và truy cập web cho AI agent, trong khi trang này tập trung vào kiến trúc thu thập dữ liệu mà chúng có chung.
Điều gì bị hỏng khi thu thập dữ liệu web mở rộng quy mô?
Ở quy mô nhỏ, lỗi rõ ràng nhất là một request hết thời gian chờ hoặc bị từ chối. Ở quy mô lớn hơn, lỗi nguy hiểm hơn thường âm thầm hơn: request thành công, job hoàn tất, nhưng dữ liệu vẫn sai.
Một phản hồi 200 OK có thể chứa sai locale, trang yêu cầu đồng ý (consent page), một thành phần trống, bố cục sản phẩm đã thay đổi, hoặc một loại trang khác. Một selector có thể vẫn khớp sau khi thiết kế lại nhưng bắt đầu trả về giá cũ, giá trị bị gạch bỏ, hoặc một trường không liên quan. Số lượng dòng và tỷ lệ thành công của request sẽ không tự phát hiện được điều đó.
Đó là lý do việc mở rộng quy mô nên được đo bằng số bản ghi chính xác trên mỗi lần chạy, không phải số request mỗi giây. Các cơ chế kiểm soát hữu ích bao gồm kiểm tra trường bắt buộc, xác thực kiểu và phạm vi giá trị, URL nguồn, dấu thời gian truy xuất, tỷ lệ trùng lặp, tỷ lệ null được chấp nhận, độ bao phủ so với các URL kỳ vọng, và cảnh báo khi phân bố của một trường thay đổi bất thường.
Chất lượng crawl cũng quan trọng riêng biệt. Đặt giới hạn cứng về số trang và độ sâu, chuẩn hóa và loại bỏ trùng lặp URL, loại trừ các mẫu không liên quan, và giữ tỷ lệ request cho mỗi domain ở mức thận trọng. Nếu một job được phép cần định tuyến mạng phân tán hoặc theo địa lý, hãy thêm proxy cho web scraping vì mạng lưới yêu cầu điều đó, không chỉ đơn giản vì công việc được gọi là scraping. Loại proxy cho scraping nên phù hợp với mục tiêu và mô hình lưu lượng.
Kiểm tra chất lượng dữ liệu: Một lần fetch thành công chứng minh rằng bạn đã nhận được phản hồi. Nó không chứng minh rằng bản ghi đầy đủ, cập nhật, hoặc đúng về mặt ngữ nghĩa.
Yozh Crawler và Yozh Scraper có thể tự động hóa pipeline như thế nào?
CyberYozh Data tách biệt việc khám phá và trích xuất thành hai dịch vụ mã nguồn mở, tự lưu trữ. Yozh Crawler bắt đầu từ một URL gốc (seed URL), duy trì hàng đợi (frontier), loại bỏ trùng lặp các URL đã phát hiện, áp dụng các quy tắc phạm vi, và truyền phát các sự kiện trang qua SSE. Yozh Scraper lấy các trang về, có thể kết xuất JavaScript bằng Playwright, và có thể trích xuất dữ liệu có cấu trúc bằng các quy tắc CSS hoặc XPath.
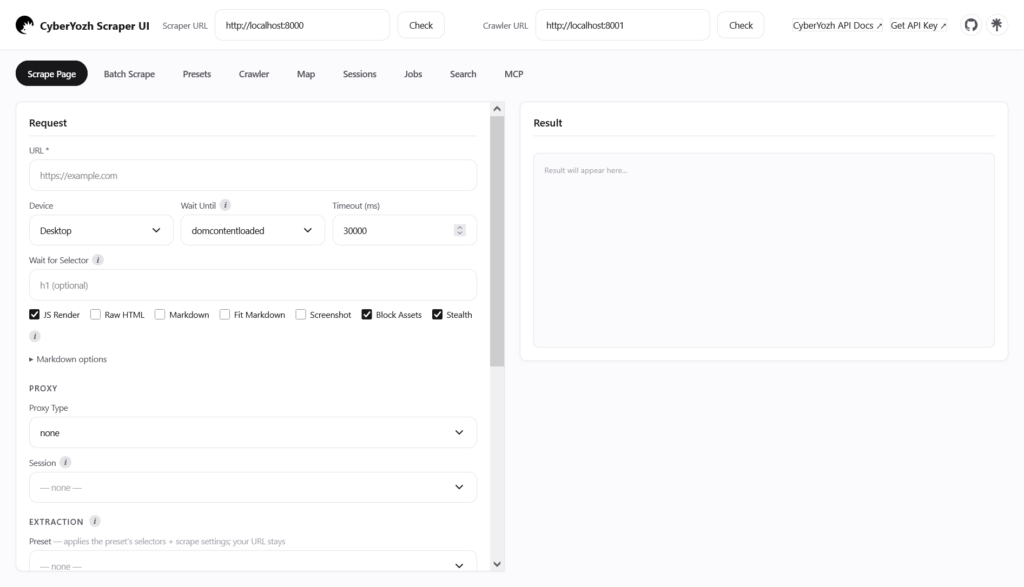
Sự phân chia đó ánh xạ trực tiếp tới một quy trình thu thập dữ liệu tổng quát:
URL gốc \u2192 thu thập và khám phá \u2192 lấy về hoặc kết xuất \u2192 trích xuất \u2192 xác thực \u2192 lưu trữ
Đối với một tác vụ thu thập, các tùy chọn điều khiển như mode, include_patterns, exclude_patterns, max_depth, max_pages, per_domain_rps, và per_domain_concurrency xác định crawler được phép đi tới đâu và với tốc độ nào. Đối với việc trích xuất, Yozh Scraper hỗ trợ render, wait_for_selector, extract, raw_html, và các yêu cầu hàng loạt (batch) thông qua /api/v1/scrape/pages.
Có những giới hạn vận hành đáng lưu ý khi thiết kế hệ thống. Yozh Crawler v1 không xác thực các endpoint của nó, vì vậy hãy giữ nó trong một mạng đáng tin cậy hoặc phía sau cổng riêng của bạn. Các tác vụ crawl được lưu trong bộ nhớ chứ không phải là kho lưu trữ dữ liệu dài hạn của bạn, vì vậy hãy lưu trữ luồng dữ liệu hoặc kết quả trong hệ thống của riêng bạn. Định tuyến qua proxy là tùy chọn: thu thập trực tiếp sử dụng proxy_type: none, trong khi các loại proxy của CyberYozh yêu cầu CYBERYOZH_API_KEY.
Đây không phải là một sự thay thế cho cơ sở dữ liệu, bộ lập lịch, hoặc lớp xác thực của bạn – điều này là có chủ đích. Đây là phần khám phá và lấy về/trích xuất của toàn bộ hệ thống, giúp việc thay đổi phương thức lưu trữ hoặc điều phối trở nên dễ dàng hơn mà không cần viết lại bộ thu thập.
Làm thế nào để thu thập dữ liệu web một cách có trách nhiệm?
Việc thu thập có trách nhiệm bắt đầu trước cả yêu cầu đầu tiên. Hãy xác nhận rằng dữ liệu và mục đích sử dụng dự kiến được cho phép, giới hạn việc thu thập ở mức dự án thực sự cần, tránh thu thập dữ liệu cá nhân hoặc nhạy cảm không cần thiết, và không thiết kế crawler theo cách gây quá tải cho dịch vụ mục tiêu.
robots.txt là một cơ chế tiêu chuẩn để chủ sở hữu trang web công bố các hướng dẫn cho crawler. Giao thức Loại trừ Robot (Robots Exclusion Protocol) quy định cách các client tự động nên diễn giải các quy tắc đó, đồng thời cũng nêu rõ rằng các quy tắc robots không phải là một hình thức cấp phép truy cập. Tài liệu kỹ thuật hiện tại của Yozh Crawler nêu rõ rằng nó không tự động tham chiếu robots.txt, vì vậy một triển khai có trách nhiệm phải tự kiểm tra và thực thi các quy tắc liên quan thông qua thiết kế crawl của mình.
Chính sách sử dụng và chính sách mục tiêu bị hạn chế của CyberYozh Data đưa ra thêm các ranh giới nền tảng. Khả năng truy cập kỹ thuật không đồng nghĩa với sự cho phép, và tính công khai không loại bỏ các nghĩa vụ về quyền riêng tư, bản quyền, hợp đồng, hoặc pháp lý theo từng khu vực.
Suy nghĩ cuối cùng
Cách hữu ích để nhìn nhận việc thu thập dữ liệu web là xem nó như một hệ thống dữ liệu, chứ không phải một kịch bản scraping đơn thuần. Khám phá, lấy về, trích xuất, xác thực, lưu trữ và giám sát giải quyết những vấn đề khác nhau, và việc giữ chúng tách biệt giúp dễ dàng phát hiện lỗi hơn cũng như dễ thay đổi quy trình hơn.
Hãy bắt đầu với các trường dữ liệu và mức độ mới cần thiết mà bạn thực sự cần. Sau đó chọn phương pháp thu thập đơn giản nhất có thể lấy được chúng, xác thực dữ liệu trả về, và thiết kế lần chạy thứ hai trước khi mở rộng quy mô lần chạy đầu tiên.
Câu hỏi thường gặp về thu thập dữ liệu web
Những câu hỏi này bao quát các từ khóa tìm kiếm còn lại mà không biến các câu hỏi phương pháp nghiên cứu chung thành lời khuyên về web scraping. Trọng tâm vẫn là thu thập thông tin từ các trang web và biến nó thành dữ liệu có thể sử dụng được.
Dữ liệu web là gì?
Dữ liệu web là thông tin có sẵn thông qua các trang web, ứng dụng web, API, feed, tệp tin, hoặc các nguồn khác có thể truy cập qua internet. Nó có thể bao gồm văn bản, giá cả, thuộc tính sản phẩm, đánh giá công khai, tin tuyển dụng, kết quả tìm kiếm, ngày tháng, liên kết, hình ảnh, và siêu dữ liệu có cấu trúc.
Thu thập dữ liệu web có giống với web scraping không?
Không. Web scraping thường là giai đoạn lấy về và trích xuất, trong khi thu thập dữ liệu web còn bao gồm việc chọn nguồn, khám phá trang, xác thực, lưu trữ, làm mới, và giám sát. Do đó, scraping có thể chỉ là một thành phần của một hệ thống thu thập lớn hơn.
AI có thể tự động hóa việc trích xuất dữ liệu web không?
AI có thể hỗ trợ suy luận các trường dữ liệu, tạo ra các quy tắc trích xuất, chuẩn hóa nội dung không nhất quán, hoặc khôi phục khi bố cục trang thay đổi. Tuy nhiên, nó vẫn cần được giới hạn bởi một schema và được kiểm tra đối chiếu với nguồn, bởi vì một kết quả nghe có vẻ hợp lý không đồng nghĩa với một kết quả đã được xác minh.
Tôi có cần proxy cho việc thu thập dữ liệu web tự động không?
Không phải lúc nào cũng cần. Nhiều nguồn công khai hoặc hợp tác có thể được thu thập trực tiếp, đặc biệt là với tốc độ yêu cầu vừa phải. Proxy trở nên phù hợp khi một quy trình được cho phép có yêu cầu cụ thể về định tuyến mạng hoặc vị trí địa lý, và chúng nên được áp dụng vì lý do đó chứ không phải theo mặc định.