


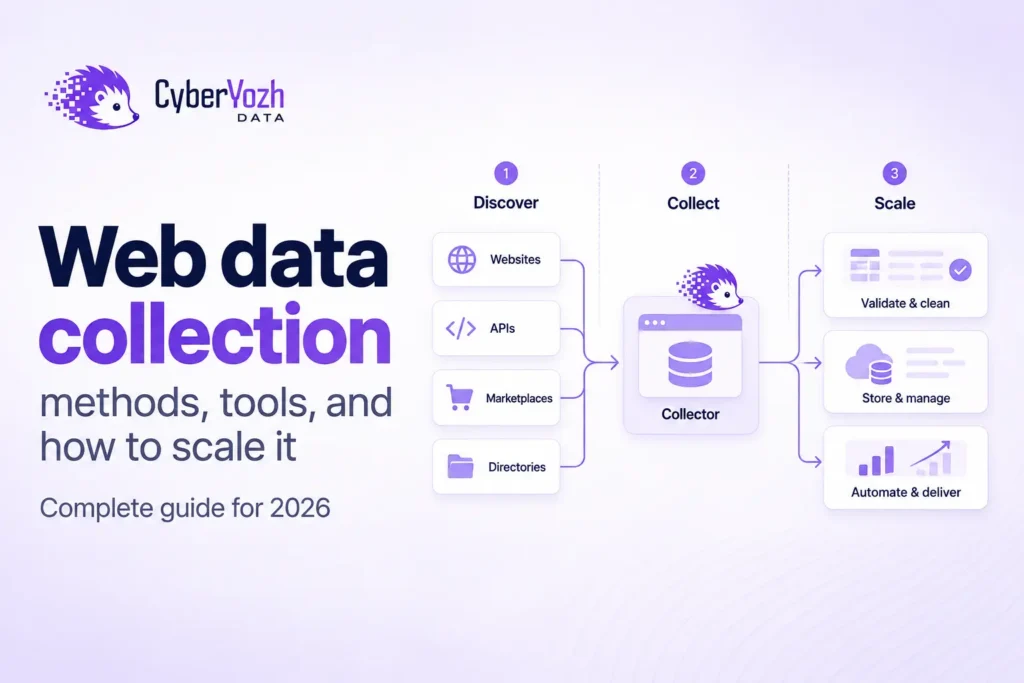
La recopilación de datos web es el proceso de convertir la información publicada en internet en datos que se pueden buscar, comparar, analizar o enviar a otro sistema. Un flujo de trabajo completo hace más que extraer una página: decide qué recopilar, encuentra las páginas correctas, las obtiene, extrae los campos necesarios, verifica el resultado, lo almacena y repite el proceso cuando se necesitan datos nuevos.
Ese alcance importa. Algunos artículos usan recopilación de datos web para incluir encuestas, análisis de clientes o seguimiento en línea. Son formas válidas de investigación basada en la web, pero son diferentes de recopilar datos de sitios web, que es el enfoque de este artículo. Precios de la competencia, catálogos de productos, reseñas públicas, resultados de búsqueda, ofertas de empleo, documentación y datos públicos de mercado son ejemplos comunes.
Respuesta rápida: Un pipeline confiable de recopilación de datos web consiste en: definir los datos \u2192 elegir la fuente \u2192 descubrir URLs \u2192 obtener o renderizar páginas \u2192 extraer campos \u2192 validar registros \u2192 almacenar y monitorear la siguiente ejecución.
¿Qué es la recopilación de datos web?
La recopilación de datos web es el proceso integral de adquirir información útil de fuentes web y convertirla en un conjunto de datos. Web scraping es una parte de ese proceso, no un sinónimo de todo el conjunto.
La distinción se ve más fácilmente al separar las tareas. El rastreo (crawling) descubre páginas, la obtención (retrieval) las descarga o renderiza, la extracción convierte el contenido de la página en campos, la validación comprueba si esos campos son utilizables, y el almacenamiento conserva los registros para su análisis o para otra aplicación.\u00a0
Una revisión sistemática reciente sobre web scraping que abarca 301 estudios primarios describe el proceso de manera similar: encontrar y obtener páginas web, extraer información útil y convertirla en formatos estructurados como JSON o CSV.
Esta separación también facilita el diagnóstico de fallos. Si a un conjunto de datos le falta la mitad de un catálogo, el problema puede estar en el descubrimiento y no en la extracción. Si se visitaron todas las URLs pero el campo de precio está vacío, es posible que el rastreador funcione bien mientras la regla de extracción esté rota.
¿Cuáles son los cinco métodos principales de recopilación de datos web?
No existe un único método de recopilación óptimo para todos los sitios web. La elección correcta depende de dónde se expongan los datos, con qué frecuencia cambian, si se requiere JavaScript y si ya se sabe qué páginas contienen los registros.
| Método | Mejor cuando | Principal compensación |
| API oficial o feed | La fuente expone directamente los campos que necesitas | La cobertura, las cuotas o el esquema pueden ser limitados |
| Conjunto de datos, archivo o exportación | Necesitas datos históricos o puntuales | Puede que no esté lo bastante actualizado para monitoreo |
| HTTP directo + parser | Los datos están presentes en HTML predecible | No puede ver contenido creado solo después de que se ejecuta JavaScript en el navegador |
| Scraping basado en navegador | Las páginas requieren renderizado con JavaScript o interacción permitida | Mayor costo de CPU, memoria y tiempo de ejecución |
| Crawler + scraper | Las páginas deben descubrirse en todo el sitio antes de la extracción | Requiere alcance definido, deduplicación, límites de velocidad y monitoreo |
La extracción asistida por IA también es útil, pero es mejor considerarla como una técnica dentro de estos métodos y no como un sexto método de acceso. Un LLM puede ayudar a inferir un esquema o recuperar un selector, pero sigue trabajando sobre contenido que primero tuvo que ser descubierto y obtenido. El web scraping con IA resulta más útil cuando respalda un proceso de extracción controlado en lugar de sustituir la validación.
Si una API oficial expone exactamente los campos y la actualización que necesitas, empieza por ahí. Cuando no es así, los servicios de API de web scraping, la extracción HTTP personalizada, la automatización de navegador o la combinación de un crawler y un scraper pueden proporcionar la cobertura que falta.
¿Cómo se recopilan datos web en siete pasos?
Un flujo de trabajo repetible comienza con el contrato de datos, no con la elección de un scraper. Esto mantiene el proyecto centrado en el resultado que necesitas en lugar de en la herramienta que resulte conveniente.
- Define los campos. Decide qué contiene un registro válido, como título, precio, moneda, source_url y retrieved_at.
- Elige la fuente. Identifica las páginas, APIs, feeds, archivos o dominios que contienen esos campos.
- Descubre las URLs. Usa listas de URLs conocidas, mapas del sitio, búsqueda o un crawler cuando las páginas aún no se conocen.
- Obtén el contenido. Usa HTTP directo siempre que sea posible y renderizado con navegador cuando el JavaScript sea realmente necesario.
- Extraer los campos. Analiza HTML, JSON, marcado estructurado, coincidencias CSS/XPath u otros datos de origen conforme a tu esquema.
- Validar y deduplicar. Comprueba los campos obligatorios, los formatos permitidos, los duplicados, los valores nulos inesperados y si el registro realmente representa la página que pretendías recopilar.
- Almacenar y monitorizar. Guarda el resultado con su procedencia y programa la siguiente ejecución según la rapidez con la que cambia la fuente.
Ese último paso es lo que convierte un scraping puntual en recopilación automatizada de datos web. El problema más amplio de la automatización del web scraping incluye reintentos, programación, colas, gestión de fallos y decidir qué debe ocurrir cuando una fuente cambia.
¿Qué herramientas se utilizan para la recopilación de datos web?
La mayoría de los sistemas en producción usan varias herramientas pequeñas en lugar de una sola que lo haga todo. Las categorías útiles son descubrimiento, obtención, extracción, validación, orquestación y almacenamiento.
Un crawler se encarga del descubrimiento de URL y del alcance del rastreo. Los clientes HTTP o los navegadores obtienen las páginas. Los parsers y las reglas de extracción convierten el contenido en datos. El código de validación comprueba esquemas y valores de campo. Cron, Airflow, Temporal, colas u otras herramientas de orquestación similares deciden cuándo se ejecutan los trabajos, mientras que las bases de datos, los almacenes de objetos y los data warehouses conservan los registros.
Para los pipelines de análisis de la web pública, suele ser mejor mantener la recopilación separada del almacenamiento. El patrón de análisis mediante web scraping permite que la capa de recopilación produzca JSON mientras tu stack de datos existente (Postgres, BigQuery, Snowflake, Kafka u otro) sigue encargándose del procesamiento posterior.
¿Qué método de recopilación de datos web es el mejor?
El mejor método es el menos complicado que devuelve de forma fiable los campos, la cobertura y la actualidad que requiere el proyecto. Un navegador no es automáticamente mejor que una solicitud directa, y un crawler es innecesario cuando ya dispones de una lista completa de URL.
Un orden práctico consiste en comprobar primero si existe una API o exportación adecuada, y después verificar si el HTTP ordinario expone los datos. Añade renderizado con navegador solo para el contenido que depende de JavaScript, y añade rastreo solo cuando el descubrimiento forme parte del problema. Así se mantiene la infraestructura proporcional a la tarea.
La fuente también importa. Un monitor diario de precios de un marketplace tiene requisitos distintos de un archivo mensual de documentación o de un agente de IA que obtiene una única página actual. CyberYozh Data ya cuenta con ejemplos más específicos para marketplaces de ecommerce y acceso web de agentes de IA, mientras que esta página se centra en la arquitectura de recopilación que ambos comparten.
¿Qué falla cuando la recopilación de datos web escala?
Con poco volumen, el fallo evidente es una solicitud que agota el tiempo de espera o es rechazada. Con mayor volumen, el fallo más peligroso suele ser más silencioso: la solicitud tiene éxito, el trabajo finaliza y, aun así, los datos son incorrectos.
Una respuesta 200 OK puede contener el idioma o región incorrectos, una página de consentimiento, un componente vacío, un diseño de producto modificado o un tipo de página diferente. Un selector puede seguir coincidiendo tras un rediseño pero empezar a devolver el precio antiguo, un valor tachado o un campo no relacionado. El recuento de filas y las tasas de éxito de las solicitudes no detectarán esto por sí solos.
Por eso el escalado debe medirse en registros correctos por ejecución, no en solicitudes por segundo. Los controles útiles incluyen comprobaciones de campos obligatorios, validación de tipo y rango, URL de origen, marcas de tiempo de obtención, tasas de duplicados, tasas de nulos aceptados, cobertura frente a las URL esperadas y alertas cuando la distribución de un campo cambia de forma inesperada.
La calidad del rastreo importa por separado. Establece límites estrictos de páginas y profundidad, canonicaliza y deduplica las URL, excluye patrones irrelevantes y mantén tasas de solicitud conservadoras por dominio. Si un trabajo permitido necesita enrutamiento de red distribuido o geográfico, añade un proxy para web scraping porque la red lo requiere, no simplemente porque la tarea se denomine scraping. El tipo de proxy para scraping debe adecuarse al objetivo y al patrón de tráfico.
Comprobación de calidad de datos: Una obtención exitosa demuestra que recibiste una respuesta. No demuestra que el registro esté completo, actualizado o sea semánticamente correcto.
¿Cómo pueden Yozh Crawler y Yozh Scraper automatizar el pipeline?
CyberYozh Data separa el descubrimiento de la extracción en dos servicios de código abierto y autoalojados. Yozh Crawler parte de una URL semilla, mantiene la frontera de rastreo, deduplica las URLs descubiertas, aplica reglas de alcance y transmite eventos de página mediante SSE. Yozh Scraper recupera las páginas, puede renderizar JavaScript con Playwright y puede extraer datos estructurados con reglas CSS o XPath.
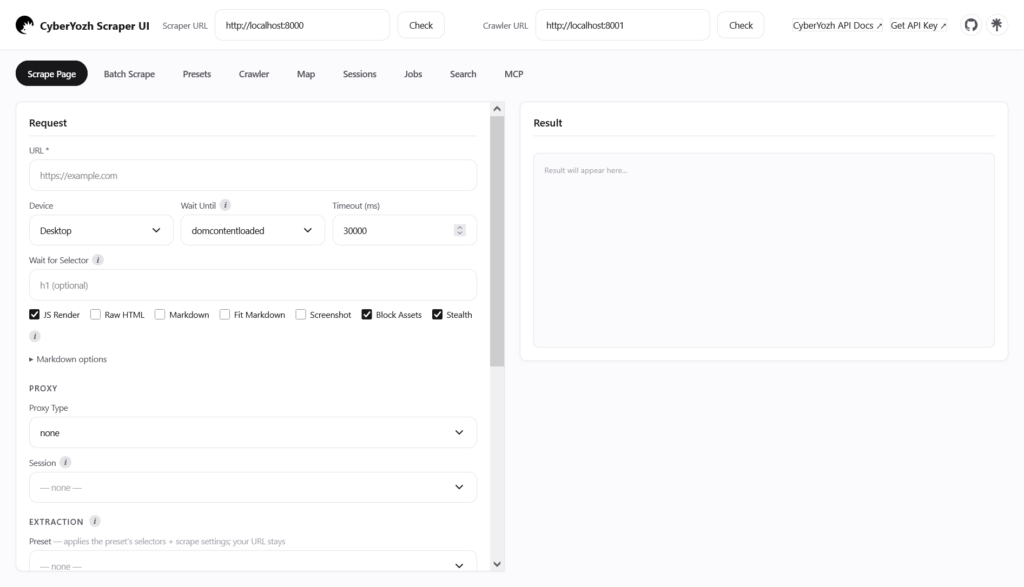
Esa división se corresponde directamente con un flujo de recolección general:
URL semilla → rastrear y descubrir → recuperar o renderizar → extraer → validar → persistir
Para un rastreo, controles como mode, include_patterns, exclude_patterns, max_depth, max_pages, per_domain_rps y per_domain_concurrency definen a dónde puede ir el rastreador y con qué rapidez. Para la extracción, Yozh Scraper admite render, wait_for_selector, extract, raw_html y solicitudes por lotes mediante /api/v1/scrape/pages.
Existen límites operativos que conviene tener en cuenta al diseñar. Yozh Crawler v1 no autentica sus endpoints, así que mantenlo en una red de confianza o detrás de tu propia puerta de enlace. Los trabajos de rastreo se mantienen en memoria en lugar de servir como tu almacenamiento de datos a largo plazo, así que persiste el flujo o los resultados en tu propio sistema. El enrutamiento por proxy es opcional: la recolección directa usa proxy_type: none, mientras que los tipos de proxy de CyberYozh requieren CYBERYOZH_API_KEY.
Esto no pretende sustituir tu base de datos, planificador o capa de validación. Es la parte de descubrimiento y recuperación/extracción del stack, lo que facilita cambiar el almacenamiento o la orquestación sin reescribir el recolector.
¿Cómo recolectar datos web de forma responsable?
La recolección responsable comienza antes de la primera solicitud. Confirma que los datos y el uso previsto están permitidos, limita la recolección a lo que el proyecto realmente necesita, evita datos personales o sensibles innecesarios y no diseñes un rastreador que sobrecargue el servicio de destino.
robots.txt es un mecanismo estándar para que los propietarios de sitios publiquen instrucciones para rastreadores. El Protocolo de Exclusión de Robots especifica cómo los clientes automatizados deben interpretar esas reglas y también deja claro que las reglas de robots no constituyen una forma de autorización de acceso. La documentación técnica actual de Yozh Crawler indica que no consulta robots.txt automáticamente, por lo que una implementación responsable debe verificar y aplicar las reglas pertinentes por sí misma mediante el diseño de su rastreo.
La política de uso y la política de objetivos restringidos de CyberYozh Data establecen límites adicionales de la plataforma. La accesibilidad técnica no equivale a permiso, y la visibilidad pública no elimina las obligaciones de privacidad, derechos de autor, contractuales o específicas de cada jurisdicción.
Reflexiones finales
La forma útil de pensar en la recolección de datos web es como un sistema de datos, no como un script de scraping. El descubrimiento, la recuperación, la extracción, la validación, el almacenamiento y la monitorización resuelven problemas distintos, y mantenerlos separados facilita detectar fallos y modificar el flujo.
Empieza por los campos y la frecuencia de actualización que realmente necesitas. Luego elige el método de recolección más simple que los exponga, valida lo que obtengas y diseña la segunda ejecución antes de escalar la primera.
Preguntas frecuentes sobre la recolección de datos web
Estas preguntas cubren los términos de búsqueda restantes sin convertir preguntas generales sobre metodología de investigación en consejos de web scraping. El enfoque se mantiene en obtener información de sitios web y convertirla en datos utilizables.
¿Qué son los datos web?
Los datos web son información disponible a través de sitios web, aplicaciones web, APIs, feeds, archivos u otras fuentes accesibles por internet. Pueden incluir texto, precios, atributos de productos, reseñas públicas, ofertas de empleo, resultados de búsqueda, fechas, enlaces, imágenes y metadatos estructurados.
¿Es la recolección de datos web lo mismo que el web scraping?
No. El web scraping suele ser la etapa de recuperación y extracción, mientras que la recolección de datos web también incluye la selección de fuentes, el descubrimiento de páginas, la validación, el almacenamiento, la actualización y la monitorización. El scraping puede ser, por tanto, un componente de un sistema de recolección más amplio.
¿Puede la IA automatizar la extracción de datos web?
La IA puede ayudar a inferir campos, generar reglas de extracción, normalizar contenido inconsistente o recuperarse de cambios de diseño. Aun así, debe estar limitada por un esquema y verificarse frente a la fuente, porque un resultado plausible no es lo mismo que un resultado verificado.
¿Necesito proxies para la recolección automatizada de datos web?
No siempre. Muchas fuentes públicas o cooperativas pueden recolectarse directamente, especialmente con tasas de solicitud moderadas. Los proxies son relevantes cuando un flujo de trabajo autorizado tiene un requisito específico de enrutamiento de red o geográfico, y deben introducirse por esa razón, no por defecto.