


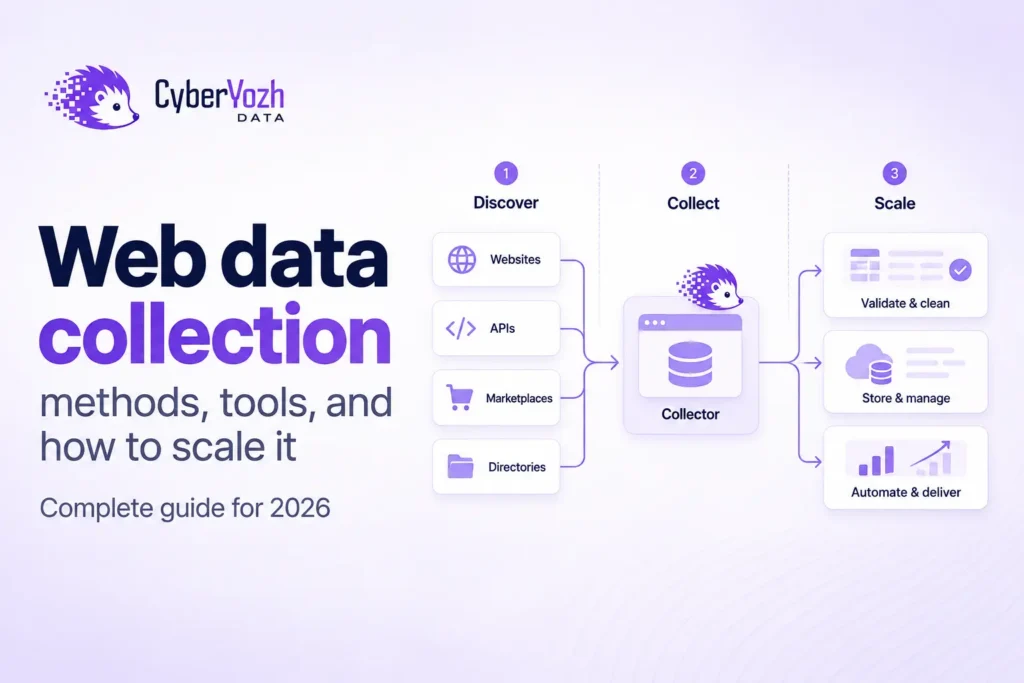
Збір даних із вебу — це процес перетворення інформації, опублікованої в інтернеті, на дані, які можна шукати, порівнювати, аналізувати або передавати в іншу систему. Повноцінний робочий процес не обмежується скрейпингом однієї сторінки: він визначає, що саме потрібно зібрати, знаходить потрібні сторінки, завантажує їх, витягує необхідні поля, перевіряє результат, зберігає його та повторює процес, коли потрібні свіжі дані.
Ця межа має значення. У деяких статтях термін збір даних із вебу включає опитування, аналітику клієнтів або онлайн-трекінг. Це справді форми дослідження на основі вебу, але вони відрізняються від збору даних із вебсайтів, на чому зосереджено цей матеріал. Типові приклади — ціни конкурентів, каталоги товарів, публічні відгуки, результати пошуку, вакансії, документація та відкриті ринкові дані.
Коротка відповідь: надійний конвеєр збору даних із вебу складається з таких кроків: визначити дані \u2192 обрати джерело \u2192 знайти URL-адреси \u2192 завантажити або відрендерити сторінки \u2192 витягти поля \u2192 перевірити записи \u2192 зберегти дані та відстежувати наступний запуск.
Що таке збір даних із вебу?
Збір даних із вебу — це наскрізний процес отримання корисної інформації з вебджерел і перетворення її на набір даних. Скрейпинг — це лише одна частина цього процесу, а не синонім усього процесу загалом.
Найпростіше побачити відмінність, розділивши завдання. Краулінг знаходить сторінки, завантаження отримує або рендерить їх, витягування перетворює вміст сторінки на поля даних, перевірка визначає, чи придатні ці поля до використання, а зберігання утримує записи для аналізу або іншого застосунку.
Нещодавній систематичний огляд скрейпингу, що охоплює 301 первинне дослідження, описує цей процес схожим чином: пошук і завантаження вебсторінок, витягування корисної інформації та перетворення її на структуровані формати, такі як JSON або CSV.
Такий поділ також полегшує діагностику збоїв. Якщо в наборі даних бракує половини каталогу, проблема може бути в пошуку сторінок, а не у витягуванні даних. Якщо всі URL-адреси відвідано, але поле ціни порожнє, краулер може працювати нормально, а несправним є саме правило витягування.
Які п’ять основних методів збору даних із вебу?
Немає єдиного найкращого методу збору для всіх сайтів. Правильний вибір залежить від того, де опубліковано дані, як часто вони змінюються, чи потрібен JavaScript, і чи вже відомо, які сторінки містять потрібні записи.
| Метод | Найкраще підходить, коли | Головний компроміс |
| Офіційний API або фід | Джерело безпосередньо надає потрібні поля | Покриття, ліміти запитів або схема даних можуть бути обмежені |
| Набір даних, архів або експорт | Потрібні історичні або одноразові дані | Можуть бути недостатньо свіжими для моніторингу |
| Прямі HTTP-запити + парсер | Дані присутні у передбачуваному HTML | Не бачить контент, який створюється лише після виконання JavaScript у браузері |
| Скрейпинг через браузер | Сторінки потребують рендерингу JavaScript або дозволеної взаємодії | Вища витрата ресурсів процесора, пам’яті та часу виконання |
| Краулер + скрейпер | Сторінки потрібно спочатку знайти по всьому сайту, а вже потім витягувати з них дані | Потребує визначення меж, дедуплікації, обмежень швидкості та моніторингу |
Витягування даних за допомогою ШІ також корисне, але його краще розглядати як техніку в межах цих методів, а не як шостий спосіб доступу до даних. LLM може допомогти визначити схему даних або відновити селектор, але вона все одно працює з контентом, який спочатку потрібно було знайти й завантажити. Скрейпинг за допомогою ШІ найкорисніший тоді, коли підтримує контрольований процес витягування даних, а не замінює перевірку.
Якщо офіційний API надає точно ті поля та рівень актуальності, які вам потрібні, почніть із нього. Якщо ні — недостатнє покриття можуть заповнити сервіси API для скрейпингу, власне HTTP-витягування даних, автоматизація браузера або поєднання краулера й скрейпера.
Як зібрати дані з вебу за сім кроків?
Відтворюваний робочий процес починається з визначення контракту даних, а не з вибору скрейпера. Це дозволяє зосередити проєкт на потрібному результаті, а не на інструменті, який просто виявився зручним.
- Визначте поля. Вирішіть, що має містити валідний запис, наприклад назву, ціну, валюту, source_url і retrieved_at.
- Оберіть джерело. Визначте сторінки, API, фіди, архіви або домени, що містять потрібні поля.
- Знайдіть URL-адреси. Використовуйте відомі списки URL-адрес, карти сайту, пошук або краулер, якщо сторінки ще невідомі.
- Завантажте вміст. Використовуйте прямі HTTP-запити, коли це можливо, і рендеринг у браузері, коли JavaScript справді необхідний.
- Витягніть поля. Розберіть HTML, JSON, структуровану розмітку, збіги CSS/XPath або інші вихідні дані у вашу схему.
- Перевірте та усуньте дублікати. Перевірте обов’язкові поля, допустимі формати, дублікати, неочікувані порожні значення, а також те, чи запис справді відповідає сторінці, яку ви планували зібрати.
- Збережіть результат і налаштуйте моніторинг. Збережіть результат разом із інформацією про походження, а потім заплануйте наступний запуск залежно від того, як швидко змінюється джерело.
Саме цей останній крок перетворює одноразовий парсинг на автоматизований збір даних із вебу. Ширша проблема автоматизації скрейпингу охоплює повторні спроби, планування, черги, обробку збоїв і рішення про те, що робити, коли джерело змінюється.
Які інструменти використовують для збору даних із вебу?
Більшість промислових систем використовують кілька невеликих інструментів замість одного, що робить усе. Корисні категорії — це виявлення, отримання, витягування, перевірка, оркестрація та зберігання.
Краулер відповідає за виявлення URL-адрес та обсяг обходу. HTTP-клієнти або браузери отримують сторінки. Парсери та правила витягування перетворюють вміст на дані. Код перевірки контролює схеми та значення полів. Cron, Airflow, Temporal, черги або подібні інструменти оркестрації вирішують, коли запускати завдання, а бази даних, об’єктні сховища та сховища даних зберігають записи.
Для конвеєрів аналітики публічного вебу часто краще відокремлювати збір даних від їх зберігання. Патерн аналітики скрейпингу дозволяє рівню збору даних генерувати JSON, тоді як ваш наявний стек даних — Postgres, BigQuery, Snowflake, Kafka чи інший — залишається відповідальним за подальшу обробку.
Який метод збору даних із вебу найкращий?
Найкращий метод — найменш складний із тих, що надійно повертає поля, охоплення та актуальність, необхідні проєкту. Браузер не є автоматично кращим за прямий запит, а краулер зайвий, якщо у вас уже є повний список URL-адрес.
Практичний порядок дій — спершу перевірити наявність відповідного API або можливості експорту, а потім з’ясувати, чи звичайний HTTP-запит надає доступ до даних. Додавайте рендеринг у браузері лише для вмісту, що залежить від JavaScript, і додавайте краулінг лише тоді, коли виявлення є частиною завдання. Це дозволяє тримати інфраструктуру пропорційною до завдання.
Джерело теж має значення. Щоденний моніторинг цін на маркетплейсі має інші вимоги, ніж щомісячний архів документації або AI-агент, що отримує одну актуальну сторінку. CyberYozh Data вже має вужчі приклади для маркетплейсів електронної комерції та веб-доступу AI-агентів, тоді як ця сторінка зосереджена на архітектурі збору даних, спільній для обох випадків.
Що ламається під час масштабування збору даних із вебу?
При невеликому обсязі очевидний збій — це запит, що перевищує час очікування або відхиляється. При більшому обсязі небезпечніший збій часто тихіший: запит виконується успішно, завдання завершується, а дані все одно виявляються неправильними.
Відповідь 200 OK може містити неправильну локаль, сторінку згоди, порожній компонент, змінений макет товару або інший тип сторінки. Селектор може продовжувати знаходити збіги після редизайну, але повертати стару ціну, закреслене значення або невідповідне поле. Кількість рядків і показник успішності запитів самі по собі цього не виявлять.
Саме тому масштабування слід вимірювати кількістю правильних записів на запуск, а не кількістю запитів за секунду. Корисні механізми контролю включають перевірку обов’язкових полів, перевірку типів і діапазонів, URL-адреси джерел, часові мітки отримання, частоту дублікатів, допустимі частоти порожніх значень, охоплення відносно очікуваних URL-адрес та сповіщення, коли розподіл поля змінюється несподівано.
Якість краулінгу — окреме питання. Встановіть жорсткі обмеження на кількість сторінок і глибину, канонізуйте та усувайте дублікати URL-адрес, виключайте нерелевантні патерни та тримайте частоту запитів на домен консервативною. Якщо дозволеному завданню потрібна розподілена або географічна маршрутизація мережі, додайте проксі для скрейпингу, оскільки цього вимагає мережа, а не просто тому, що робота називається скрейпингом. Тип проксі для скрейпингу має відповідати цілі та патерну трафіку.
Перевірка якості даних: Успішний запит підтверджує, що ви отримали відповідь. Він не підтверджує, що запис повний, актуальний або семантично правильний.
Як Yozh Crawler і Yozh Scraper можуть автоматизувати конвеєр?
CyberYozh Data розділяє виявлення сторінок і вилучення даних на два окремі сервіси з відкритим кодом, які розгортаються самостійно. Yozh Crawler починає роботу з початкової URL-адреси, підтримує чергу обходу, усуває дублікати знайдених посилань, застосовує правила області обходу та передає події сторінок через SSE. Yozh Scraper отримує сторінки, вміє рендерити JavaScript через Playwright і вилучати структуровані дані за правилами CSS або XPath.
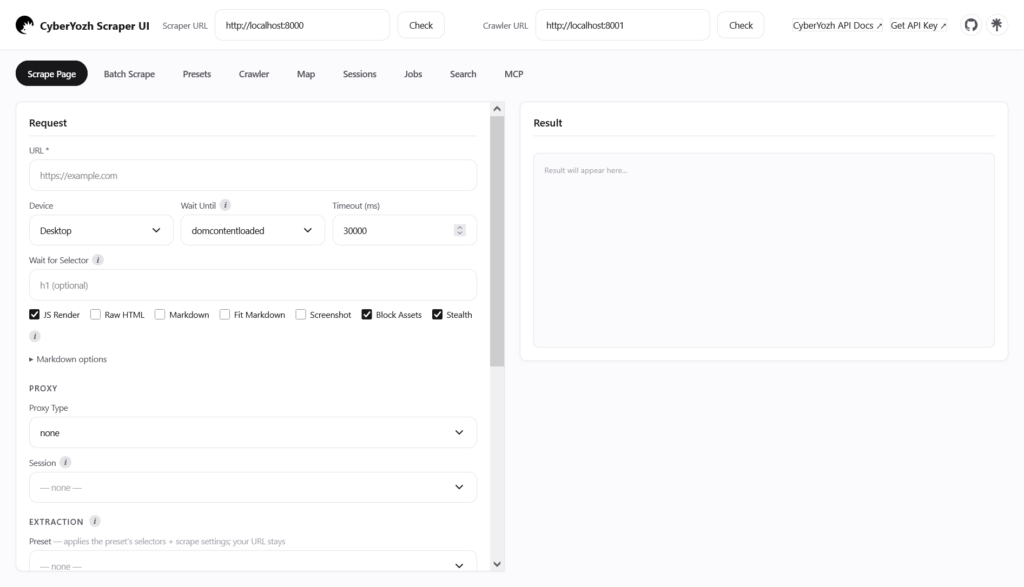
Цей поділ безпосередньо відповідає загальному процесу збору даних:
Початкова URL-адреса → обхід і виявлення → отримання або рендеринг → вилучення → перевірка → збереження
Для обходу такі параметри, як mode, include_patterns, exclude_patterns, max_depth, max_pages, per_domain_rps і per_domain_concurrency, визначають, куди краулер може заходити і з якою швидкістю. Для вилучення даних Yozh Scraper підтримує render, wait_for_selector, extract, raw_html та пакетні запити через /api/v1/scrape/pages.
Є експлуатаційні обмеження, які варто врахувати заздалегідь. Yozh Crawler v1 не автентифікує свої адреси підключення, тому тримайте його в довіреній мережі або за власним шлюзом. Завдання обходу зберігаються в пам’яті, а не є довгостроковим сховищем даних, тож зберігайте потік або результати у власній системі. Маршрутизація через проксі опційна: пряма робота використовує proxy_type: none, а для типів проксі CyberYozh потрібен CYBERYOZH_API_KEY.
Це свідомо не заміна вашій базі даних, планувальнику чи рівню перевірки даних. Це частина стеку, що відповідає за виявлення та отримання/вилучення даних, завдяки чому легше змінювати сховище чи оркестрацію без переписування збирача.
Як відповідально збирати вебдані?
Відповідальний збір даних починається ще до першого запиту. Переконайтеся, що дані та їх передбачуване використання дозволені, обмежте збір лише тим, що потрібно проєкту, уникайте зайвих персональних чи чутливих даних і не проєктуйте краулер так, щоб він перевантажував цільовий сервіс.
robots.txt — це стандартний механізм, за допомогою якого власники сайтів публікують інструкції для краулерів. Протокол виключення роботів визначає, як автоматизовані клієнти повинні тлумачити ці правила, а також чітко зазначає, що правила robots не є формою авторизації доступу. Поточна технічна документація Yozh Crawler вказує, що він не звертається до robots.txt автоматично, тому відповідальне розгортання має самостійно перевіряти й дотримуватися відповідних правил через налаштування обходу.
Політика використання CyberYozh Data та політика обмежених цілей встановлюють додаткові межі платформи. Технічна доступність не є дозволом, а публічна видимість не скасовує обов’язків щодо приватності, авторського права, договірних умов чи вимог конкретної юрисдикції.
Підсумки
Корисно розглядати збір вебданих як систему даних, а не як скрипт для скрейпингу. Виявлення, отримання, вилучення, перевірка, зберігання та моніторинг вирішують різні завдання, і якщо тримати їх окремо, помилки легше виявляти, а процес легше змінювати.
Починайте з полів даних і потрібної частоти оновлення, які справді необхідні. Потім оберіть найпростіший метод збору, що дає до них доступ, перевірте отримані результати та продумайте другий запуск ще до масштабування першого.
Поширені запитання про збір вебданих
Ці запитання охоплюють решту пошукових термінів, не перетворюючи загальні питання методології дослідження на поради зі скрейпингу. Основна увага зосереджена на отриманні інформації з сайтів і перетворенні її на придатні для використання дані.
Що таке вебдані?
Вебдані — це інформація, доступна через сайти, вебзастосунки, API, стрічки, файли чи інші джерела в інтернеті. Вони можуть включати текст, ціни, атрибути товарів, публічні відгуки, вакансії, результати пошуку, дати, посилання, зображення та структуровані метадані.
Чи є збір вебданих тим самим, що й скрейпинг?
Ні. Скрейпинг зазвичай є етапом отримання й вилучення даних, тоді як збір вебданих включає ще вибір джерел, виявлення сторінок, перевірку, зберігання, оновлення та моніторинг. Отже, скрейпинг може бути лише одним компонентом більшої системи збору даних.
Чи може ШІ автоматизувати вилучення вебданих?
ШІ може допомогти визначити поля, згенерувати правила вилучення, нормалізувати непослідовний контент або адаптуватися до змін макета. Проте його роботу все одно варто обмежувати схемою та перевіряти на відповідність джерелу, оскільки правдоподібний результат — не те саме, що перевірений результат.
Чи потрібні проксі для автоматизованого збору вебданих?
Не завжди. Багато публічних чи спільних джерел можна збирати напряму, особливо за помірної частоти запитів. Проксі стають актуальними, коли авторизований процес має конкретну вимогу щодо маршрутизації мережі чи географії, і їх варто впроваджувати саме з цієї причини, а не за замовчуванням.