


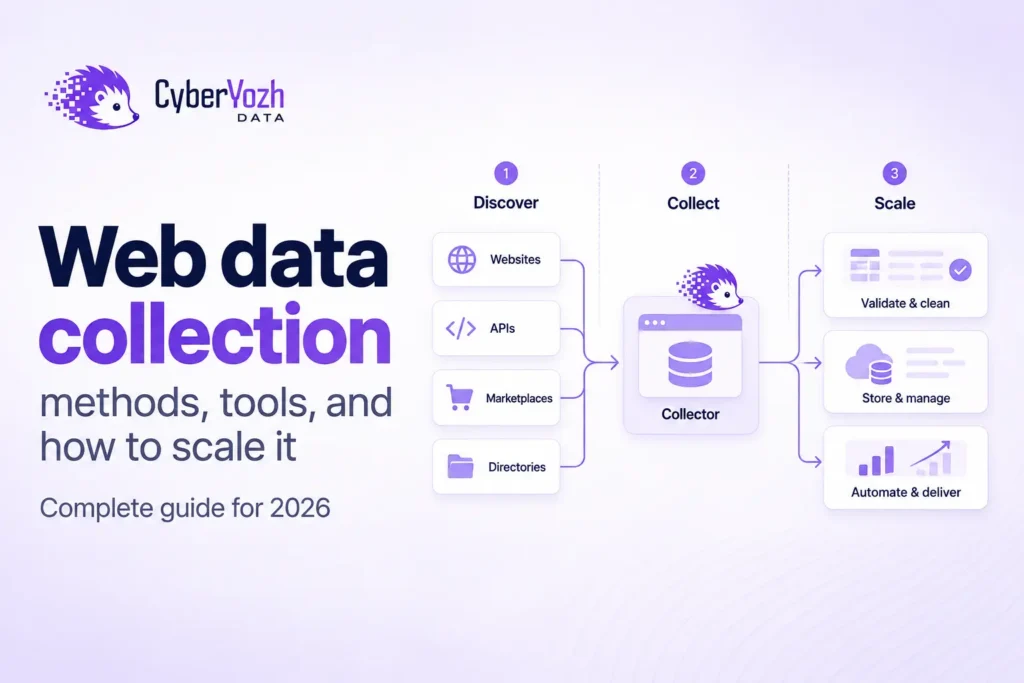
Сбор веб-данных — это процесс превращения информации, опубликованной в интернете, в данные, которые можно искать, сравнивать, анализировать или передавать в другую систему. Полноценный процесс включает не только парсинг страницы: нужно решить, что собирать, найти нужные страницы, загрузить их, извлечь необходимые поля, проверить результат, сохранить его и повторять процесс, когда требуются свежие данные.
Этот охват имеет значение. В некоторых материалах термин сбор веб-данных включает опросы, аналитику клиентов или онлайн-трекинг. Это тоже формы исследований на основе веба, но они отличаются от сбора данных с сайтов, на котором мы сосредоточимся здесь. Типичные примеры — цены конкурентов, каталоги товаров, публичные отзывы, результаты поиска, вакансии, документация и открытые рыночные данные.
Краткий ответ: надёжный процесс сбора веб-данных выглядит так: определить данные → выбрать источник → найти URL-адреса → загрузить или отрендерить страницы → извлечь поля → проверить записи → сохранить и настроить мониторинг для следующего запуска.
Что такое сбор веб-данных?
Сбор веб-данных — это сквозной процесс получения полезной информации из веб-источников и превращения её в датасет. Скрейпинг — лишь часть этого процесса, а не синоним всего процесса целиком.
Разницу проще всего увидеть, если разделить задачи. Краулинг находит страницы, загрузка скачивает или рендерит их, извлечение превращает содержимое страницы в поля, валидация проверяет, пригодны ли эти поля к использованию, а хранение сохраняет записи для анализа или другого приложения.
Недавний систематический обзор скрейпинга, охвативший 301 исследование, описывает этот процесс аналогично: поиск и загрузка веб-страниц, извлечение полезной информации и преобразование её в структурированные форматы, такие как JSON или CSV.
Такое разделение также упрощает диагностику сбоев. Если в датасете отсутствует половина каталога, проблема, скорее всего, в обнаружении страниц, а не в извлечении данных. Если все URL были посещены, но поле с ценой пустое, краулер может работать исправно, а вот правило извлечения — нет.
Какие пять основных методов сбора веб-данных существуют?
Единого лучшего метода сбора данных для всех сайтов не существует. Правильный выбор зависит от того, где представлены данные, как часто они меняются, требуется ли JavaScript и известно ли заранее, на каких страницах находятся нужные записи.
| Метод | Когда лучше всего подходит | Главный компромисс |
| Официальный API или фид | Источник напрямую предоставляет нужные поля | Охват, лимиты или схема могут быть ограничены |
| Датасет, архив или экспорт | Нужны исторические или разовые данные | Может быть недостаточно свежим для мониторинга |
| Прямые HTTP-запросы + парсер | Данные присутствуют в предсказуемом HTML | Не видит контент, созданный только после выполнения JavaScript на стороне браузера |
| Скрейпинг через браузер | Страницам требуется рендеринг JavaScript или разрешённое взаимодействие | Более высокие затраты CPU, памяти и времени выполнения |
| Краулер + скрейпер | Страницы нужно обнаружить по всему сайту перед извлечением | Требует определения области охвата, дедупликации, ограничений скорости и мониторинга |
Извлечение данных с помощью ИИ тоже полезно, но правильнее рассматривать его как приём внутри этих методов, а не как шестой способ доступа. LLM может помочь вывести схему или восстановить селектор, но она всё равно работает с контентом, который сначала нужно было обнаружить и загрузить. Скрейпинг с помощью ИИ наиболее полезен, когда поддерживает контролируемый процесс извлечения, а не заменяет валидацию.
Если официальный API предоставляет именно те поля и ту свежесть данных, которые вам нужны, начните с него. Если нет — недостающий охват могут обеспечить сервисы web scraping API, кастомное извлечение через HTTP, автоматизация браузера или связка краулера и скрейпера.
Как собрать веб-данные за семь шагов?
Повторяемый процесс начинается с контракта данных, а не с выбора скрейпера. Это позволяет сосредоточить проект на нужном результате, а не на инструменте, который просто оказался под рукой.
- Определите поля. Решите, что должна содержать корректная запись, например title, price, currency, source_url и retrieved_at.
- Выберите источник. Определите страницы, API, фиды, архивы или домены, которые содержат эти поля.
- Найдите URL-адреса. Используйте известные списки URL, карты сайта, поиск или краулер, если страницы ещё не известны.
- Загрузите содержимое. По возможности используйте прямые HTTP-запросы, а рендеринг в браузере — только когда JavaScript действительно необходим.
- Извлеките поля. Разберите HTML, JSON, структурированную разметку, совпадения по CSS/XPath или другие исходные данные и приведите их к вашей схеме.
- Проверьте и удалите дубликаты. Проверьте обязательные поля, допустимые форматы, дубликаты, неожиданные null-значения, а также то, действительно ли запись соответствует странице, которую вы намеревались собрать.
- Сохраните и мониторьте. Сохраните результат вместе с информацией о происхождении данных, затем запланируйте следующий запуск в зависимости от того, как быстро меняется источник.
Именно последний шаг превращает разовый сбор данных в автоматизированный сбор веб-данных. Более широкая задача автоматизации веб-скрейпинга включает повторные попытки, планирование, очереди, обработку сбоев и решение о том, что делать при изменении источника.
Какие инструменты используются для сбора веб-данных?
Большинство промышленных систем используют несколько небольших инструментов, а не один универсальный. Полезные категории: обнаружение, получение данных, извлечение, валидация, оркестрация и хранение.
Краулер занимается обнаружением URL и определением области обхода. HTTP-клиенты или браузеры получают страницы. Парсеры и правила извлечения превращают контент в данные. Код валидации проверяет схемы и значения полей. Cron, Airflow, Temporal, очереди и подобные инструменты оркестрации решают, когда запускать задачи, а базы данных, объектные хранилища и хранилища данных хранят записи.
Для аналитических процессов на основе публичных веб-данных зачастую лучше разделять сбор данных и их хранение. Подход веб-скрейпинга для аналитики позволяет уровню сбора данных выдавать JSON, в то время как ваш существующий стек — Postgres, BigQuery, Snowflake, Kafka или другой — остаётся ответственным за дальнейшую обработку.
Какой метод сбора веб-данных лучше?
Лучший метод — наименее сложный из тех, что надёжно возвращает поля, охват и актуальность данных, необходимые проекту. Браузер не обязательно лучше прямого запроса, а краулер не нужен, если у вас уже есть полный список URL.
Практичный порядок действий — сначала проверить наличие подходящего API или экспорта, затем выяснить, доступны ли данные через обычные HTTP-запросы. Рендеринг в браузере стоит добавлять только для контента, зависящего от JavaScript, а краулинг — только когда обнаружение действительно часть задачи. Это позволяет держать инфраструктуру пропорциональной задаче.
Источник данных тоже имеет значение. Ежедневный мониторинг цен на маркетплейсе предъявляет иные требования, чем ежемесячный архив документации или ИИ-агент, запрашивающий одну актуальную страницу. У CyberYozh Data уже есть более узкие примеры для маркетплейсов электронной коммерции и веб-доступа для ИИ-агентов, а эта страница посвящена общей для них архитектуре сбора данных.
Что ломается при масштабировании сбора веб-данных?
При небольших объёмах очевидный сбой — это запрос, который завершается по тайм-ауту или отклоняется. При больших объёмах более опасный сбой обычно менее заметен: запрос выполняется успешно, задача завершается, но данные всё равно неверны.
Ответ 200 OK может содержать не ту локаль, страницу согласия, пустой компонент, изменённую структуру карточки товара или страницу другого типа. Селектор может продолжать находить совпадения после редизайна, но начать возвращать старую цену, зачёркнутое значение или несвязанное поле. Количество строк и процент успешных запросов сами по себе этого не покажут.
Именно поэтому масштабирование стоит измерять в корректных записях за запуск, а не в запросах в секунду. Полезные меры контроля включают проверку обязательных полей, валидацию типов и диапазонов, исходные URL, метки времени получения данных, долю дубликатов, допустимую долю null-значений, охват по сравнению с ожидаемыми URL и оповещения при неожиданном изменении распределения значений поля.
Качество краулинга требует отдельного внимания. Установите жёсткие лимиты на количество страниц и глубину обхода, канонизируйте и удаляйте дубликаты URL, исключайте нерелевантные шаблоны и держите частоту запросов на домен в разумных пределах. Если разрешённая задача требует распределённой или географической маршрутизации сети, добавьте прокси для веб-скрейпинга именно потому, что этого требует сеть, а не просто потому что задачу называют скрейпингом. Тип прокси для скрейпинга должен определяться целевым ресурсом и характером трафика.
Проверка качества данных: Успешный запрос доказывает лишь то, что вы получили ответ. Это не доказывает, что запись полна, актуальна или семантически корректна.
Как Yozh Crawler и Yozh Scraper могут автоматизировать процесс?
CyberYozh Data разделяет обнаружение и извлечение данных между двумя open-source сервисами с самостоятельным хостингом. Yozh Crawler начинает работу с исходного URL, поддерживает очередь обхода, устраняет дубликаты найденных URL, применяет правила ограничения области и передаёт события страниц через SSE. Yozh Scraper получает страницы, может рендерить JavaScript с помощью Playwright и извлекать структурированные данные по правилам CSS или XPath.
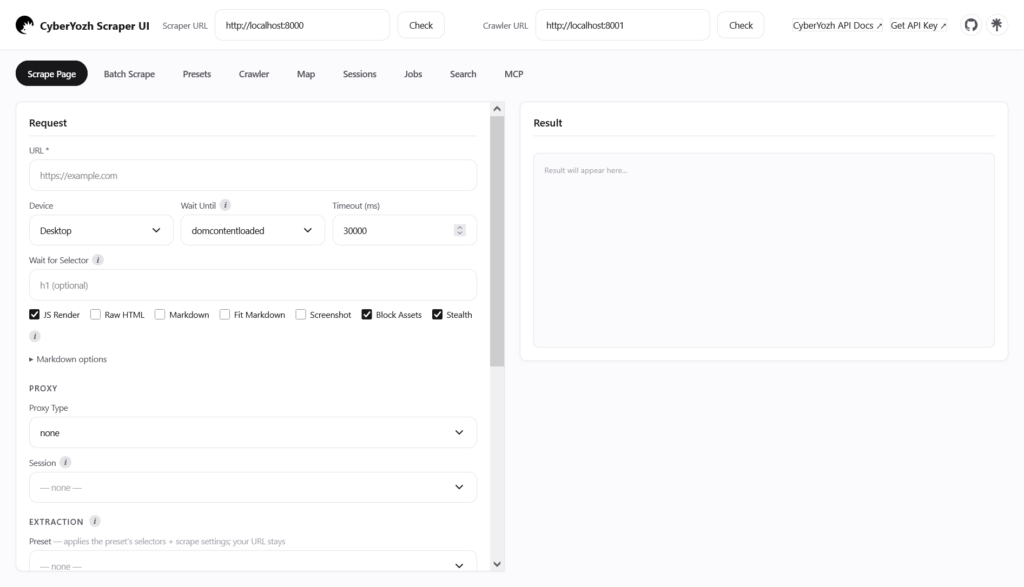
Это разделение напрямую отражает общий процесс сбора данных:
Исходный URL → обход и обнаружение → получение или рендеринг → извлечение → проверка → сохранение
Для обхода такие параметры, как mode, include_patterns, exclude_patterns, max_depth, max_pages, per_domain_rps и per_domain_concurrency, определяют, куда может двигаться краулер и с какой скоростью. Для извлечения данных Yozh Scraper поддерживает render, wait_for_selector, extract, raw_html и пакетные запросы через /api/v1/scrape/pages.
Есть эксплуатационные ограничения, которые стоит учитывать при проектировании. Yozh Crawler v1 не аутентифицирует свои адреса подключения, поэтому держите его в доверенной сети или за собственным шлюзом. Задания обхода хранятся в памяти, а не в вашем долговременном хранилище данных, поэтому сохраняйте поток или результаты в своей системе. Маршрутизация через прокси опциональна: прямой сбор данных использует proxy_type: none, а типы прокси CyberYozh требуют CYBERYOZH_API_KEY.
Это намеренно не замена вашей базе данных, планировщику или слою валидации. Это часть стека, отвечающая за обнаружение и получение/извлечение данных, что упрощает смену хранилища или оркестрации без переписывания коллектора.
Как собирать веб-данные ответственно?
Ответственный сбор данных начинается ещё до первого запроса. Убедитесь, что данные и предполагаемое использование разрешены, ограничьте сбор тем, что действительно нужно проекту, избегайте сбора лишних персональных или чувствительных данных и не проектируйте краулер так, чтобы он перегружал целевой сервис.
robots.txt — стандартный механизм, с помощью которого владельцы сайтов публикуют инструкции для краулеров. Протокол исключения роботов определяет, как автоматизированные клиенты должны интерпретировать эти правила, и также ясно указывает, что правила robots не являются формой авторизации доступа. Текущая техническая документация Yozh Crawler указывает, что он не проверяет robots.txt автоматически, поэтому ответственное развёртывание должно самостоятельно проверять и соблюдать соответствующие правила через настройку обхода.
Политика использования и политика ограниченных целей CyberYozh Data устанавливают дополнительные границы платформы. Техническая доступность не означает разрешение, а публичная видимость не отменяет обязательств, связанных с приватностью, авторским правом, договорами или юрисдикцией.
Заключение
Сбор веб-данных полезно рассматривать как систему данных, а не как скрипт для скрейпинга. Обнаружение, получение, извлечение, проверка, хранение и мониторинг решают разные задачи, и их разделение облегчает выявление сбоев и изменение процесса.
Начните с определения полей и частоты обновления, которые вам действительно нужны. Затем выберите самый простой метод сбора, который их предоставляет, проверяйте полученные данные и продумывайте второй запуск ещё до масштабирования первого.
FAQ о сборе веб-данных
Эти вопросы охватывают оставшиеся поисковые запросы, не превращая общие вопросы методологии исследований в советы по скрейпингу. Фокус остаётся на получении информации с сайтов и превращении её в пригодные для использования данные.
Что такое веб-данные?
Веб-данные — это информация, доступная через сайты, веб-приложения, API, фиды, файлы или другие источники, доступные через интернет. Она может включать текст, цены, атрибуты товаров, публичные отзывы, вакансии, результаты поиска, даты, ссылки, изображения и структурированные метаданные.
Сбор веб-данных — то же самое, что скрейпинг?
Нет. Скрейпинг обычно относится к этапу получения и извлечения данных, тогда как сбор веб-данных также включает выбор источников, обнаружение страниц, проверку, хранение, обновление и мониторинг. Таким образом, скрейпинг может быть одним из компонентов более крупной системы сбора данных.
Может ли ИИ автоматизировать извлечение веб-данных?
ИИ может помочь определить поля, сгенерировать правила извлечения, нормализовать неоднородный контент или восстановить работу после изменений разметки. Тем не менее, его работа должна ограничиваться схемой и проверяться по источнику, поскольку правдоподобный результат — не то же самое, что проверенный.
Нужны ли прокси для автоматизированного сбора веб-данных?
Не всегда. Многие публичные или доступные для сотрудничества источники можно собирать напрямую, особенно при умеренной частоте запросов. Прокси актуальны, когда у авторизованного процесса есть конкретное требование к маршрутизации сети или геолокации, и их стоит внедрять именно по этой причине, а не по умолчанию.