


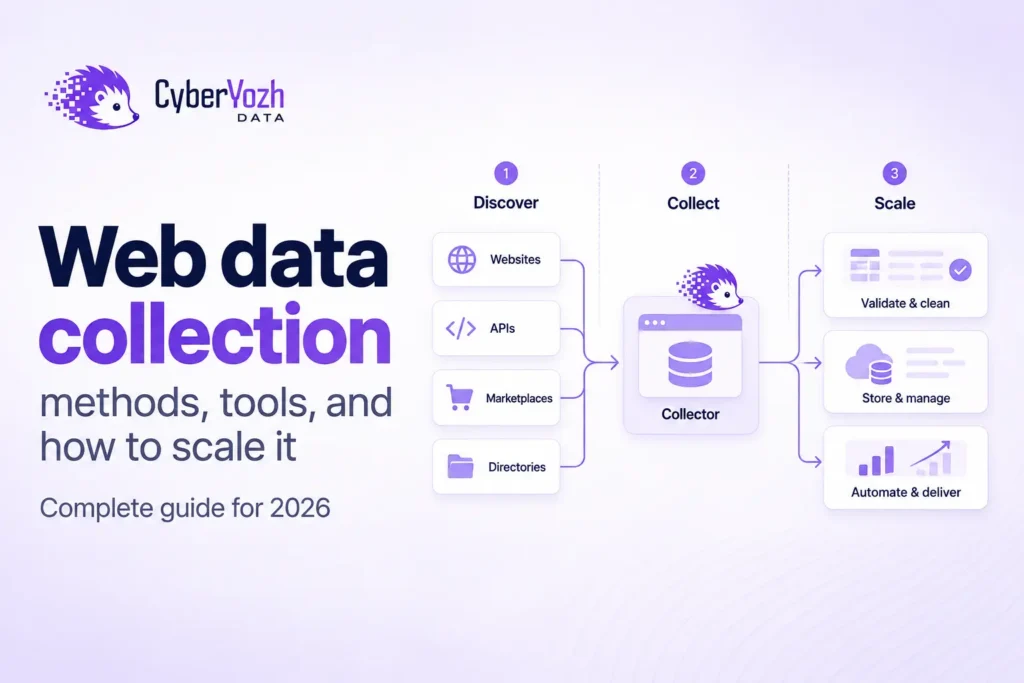
Pengumpulan data web adalah proses mengubah informasi yang dipublikasikan di web menjadi data yang dapat Anda cari, bandingkan, analisis, atau kirim ke sistem lain. Alur kerja yang lengkap tidak hanya sekadar melakukan scraping pada sebuah halaman: alur ini menentukan apa yang perlu dikumpulkan, menemukan halaman yang tepat, mengambilnya, mengekstrak kolom yang diperlukan, memeriksa hasilnya, menyimpannya, dan mengulangi proses tersebut saat data baru dibutuhkan.
Cakupan ini penting. Beberapa artikel menggunakan istilah pengumpulan data web untuk mencakup survei, analitik pelanggan, atau pelacakan online. Itu semua adalah bentuk riset berbasis web yang sah, tetapi berbeda dari pengumpulan data dari situs web, yang menjadi fokus di sini. Harga pesaing, katalog produk, ulasan publik, hasil pencarian, lowongan kerja, dokumentasi, dan data pasar publik adalah contoh yang umum.
Jawaban singkat: Pipeline pengumpulan data web yang andal adalah: mendefinisikan data \u2192 memilih sumber \u2192 menemukan URL \u2192 mengambil atau me-render halaman \u2192 mengekstrak kolom \u2192 memvalidasi rekaman \u2192 menyimpan dan memantau untuk proses berikutnya.
Apa itu pengumpulan data web?
Pengumpulan data web adalah proses menyeluruh untuk memperoleh informasi berguna dari sumber web dan mengubahnya menjadi dataset. Web scraping hanyalah salah satu bagian dari proses tersebut, bukan sinonim untuk keseluruhan proses.
Perbedaan ini paling mudah dilihat dengan memisahkan tugas-tugasnya. Crawling menemukan halaman, pengambilan (retrieval) mengunduh atau me-render halaman tersebut, ekstraksi mengubah konten halaman menjadi kolom data, validasi memeriksa apakah kolom-kolom tersebut dapat digunakan, dan penyimpanan menjaga rekaman untuk analisis atau aplikasi lain.\u00a0
Sebuah tinjauan sistematis terbaru tentang web scraping yang mencakup 301 studi utama juga menggambarkan proses ini sebagai menemukan dan mengambil halaman web, mengekstrak informasi berguna, dan mengubahnya menjadi format terstruktur seperti JSON atau CSV.
Pemisahan ini juga membuat kegagalan lebih mudah didiagnosis. Jika sebuah dataset kehilangan setengah dari katalog, masalahnya mungkin ada pada penemuan (discovery), bukan ekstraksi. Jika setiap URL sudah dikunjungi tetapi kolom harga kosong, crawler mungkin baik-baik saja sementara aturan ekstraksinya yang rusak.
Apa saja lima metode utama pengumpulan data web?
Tidak ada satu metode pengumpulan terbaik yang berlaku untuk semua situs web. Pilihan yang tepat bergantung pada di mana data tersebut ditampilkan, seberapa sering data itu berubah, apakah JavaScript diperlukan, dan apakah Anda sudah tahu halaman mana yang berisi rekaman tersebut.
| Metode | Terbaik jika | Trade-off utama |
| API resmi atau feed | Sumber menampilkan kolom yang Anda butuhkan secara langsung | Cakupan, kuota, atau skema mungkin terbatas |
| Dataset, arsip, atau ekspor | Anda memerlukan data historis atau data satu kali | Mungkin tidak cukup baru untuk pemantauan |
| HTTP langsung + parser | Data terdapat dalam HTML yang dapat diprediksi | Tidak dapat melihat konten yang hanya dibuat setelah JavaScript sisi peramban dijalankan |
| Scraping berbasis peramban | Halaman memerlukan rendering JavaScript atau interaksi yang diizinkan | Biaya CPU, memori, dan runtime lebih tinggi |
| Crawler + scraper | Halaman harus ditemukan di seluruh situs sebelum ekstraksi | Membutuhkan penentuan cakupan, deduplikasi, batas laju (rate limits), dan pemantauan |
Ekstraksi berbantuan AI juga berguna, tetapi lebih tepat diperlakukan sebagai teknik dalam metode-metode ini daripada sebagai metode akses keenam. LLM dapat membantu menyimpulkan skema atau memulihkan selektor, tetapi tetap bekerja pada konten yang sebelumnya harus ditemukan dan diambil terlebih dahulu. AI web scraping paling berguna ketika ia mendukung proses ekstraksi yang terkendali, bukan menggantikan validasi.
Jika API resmi menampilkan kolom dan tingkat kesegaran data yang tepat sesuai kebutuhan Anda, mulailah dari sana. Jika tidak, layanan web scraping API, ekstraksi HTTP khusus, otomatisasi peramban, atau kombinasi crawler dan scraper dapat menyediakan cakupan yang hilang.
Bagaimana cara mengumpulkan data web dalam tujuh langkah?
Alur kerja yang dapat diulang dimulai dari kontrak data, bukan dari pemilihan alat scraper. Ini menjaga proyek tetap fokus pada hasil yang Anda butuhkan, bukan pada alat yang kebetulan tersedia dengan mudah.
- Tentukan kolomnya. Putuskan apa yang terkandung dalam rekaman yang valid, seperti title, price, currency, source_url, dan retrieved_at.
- Pilih sumbernya. Identifikasi halaman, API, feed, arsip, atau domain yang berisi kolom-kolom tersebut.
- Temukan URL. Gunakan daftar URL yang sudah diketahui, sitemap, pencarian, atau crawler ketika halamannya belum diketahui.
- Ambil kontennya. Gunakan HTTP langsung jika memungkinkan dan rendering peramban ketika JavaScript benar-benar diperlukan.
- Ekstrak kolom data. Parsing HTML, JSON, markup terstruktur, hasil pencocokan CSS/XPath, atau data sumber lainnya ke dalam skema Anda.
- Validasi dan hapus duplikat. Periksa kolom wajib, format yang diizinkan, duplikat, nilai null yang tidak diharapkan, dan apakah catatan tersebut benar-benar mewakili halaman yang Anda maksudkan untuk dikumpulkan.
- Simpan dan pantau. Simpan hasilnya beserta asal-usulnya (provenance), lalu jadwalkan proses berikutnya sesuai seberapa cepat sumber tersebut berubah.
Langkah terakhir itulah yang mengubah scraping sekali jalan menjadi pengumpulan data web otomatis. Masalah otomatisasi web scraping yang lebih luas mencakup percobaan ulang (retries), penjadwalan, antrean, penanganan kegagalan, dan penentuan apa yang harus terjadi ketika sumber berubah.
Alat apa yang digunakan untuk pengumpulan data web?
Sebagian besar sistem produksi menggunakan beberapa alat kecil, bukan satu alat yang melakukan segalanya. Kategori yang berguna adalah penemuan (discovery), pengambilan (retrieval), ekstraksi, validasi, orkestrasi, dan penyimpanan.
Crawler menangani penemuan URL dan cakupan crawl. Klien HTTP atau browser mengambil halaman. Parser dan aturan ekstraksi mengubah konten menjadi data. Kode validasi memeriksa skema dan nilai kolom. Cron, Airflow, Temporal, antrean, atau alat orkestrasi serupa menentukan kapan pekerjaan dijalankan, sementara basis data, penyimpanan objek, dan data warehouse menyimpan catatannya.
Untuk pipeline analitik web publik, seringkali lebih baik memisahkan pengumpulan dari penyimpanan. Pola analitik web scraping memungkinkan lapisan pengumpulan menghasilkan JSON, sementara Postgres, BigQuery, Snowflake, Kafka, atau tumpukan data lain yang sudah Anda miliki tetap bertanggung jawab atas pemrosesan lanjutan.
Metode pengumpulan data web mana yang terbaik?
Metode terbaik adalah metode paling sederhana yang secara andal mengembalikan kolom, cakupan, dan kesegaran data yang dibutuhkan proyek. Browser tidak secara otomatis lebih baik daripada permintaan langsung, dan crawler tidak diperlukan jika Anda sudah memiliki daftar lengkap URL.
Urutan yang praktis adalah memeriksa terlebih dahulu apakah ada API atau ekspor data yang sesuai, kemudian memeriksa apakah permintaan HTTP biasa dapat mengakses data tersebut. Tambahkan rendering browser hanya untuk konten yang bergantung pada JavaScript, dan tambahkan crawling hanya jika penemuan (discovery) merupakan bagian dari masalahnya. Ini menjaga infrastruktur tetap proporsional dengan kebutuhan pekerjaan.
Sumber data juga berpengaruh. Pemantau harga marketplace harian memiliki kebutuhan yang berbeda dari arsip dokumentasi bulanan atau agen AI yang mengambil satu halaman terkini. CyberYozh Data sudah memiliki contoh yang lebih spesifik untuk marketplace ecommerce dan akses web agen AI, sementara halaman ini berfokus pada arsitektur pengumpulan yang mereka gunakan bersama.
Apa yang rusak ketika pengumpulan data web berkembang skalanya?
Pada volume kecil, kegagalan yang jelas adalah permintaan yang timeout atau ditolak. Pada volume yang lebih besar, kegagalan yang lebih berbahaya seringkali lebih senyap: permintaan berhasil, pekerjaan selesai, tetapi datanya tetap salah.
Respons 200 OK bisa saja berisi lokal yang salah, halaman persetujuan (consent page), komponen kosong, tata letak produk yang berubah, atau jenis halaman yang berbeda. Selektor bisa tetap cocok setelah desain ulang tetapi mulai mengembalikan harga lama, nilai yang dicoret, atau kolom yang tidak relevan. Jumlah baris dan tingkat keberhasilan permintaan saja tidak akan menangkap hal itu.
Itulah sebabnya penskalaan harus diukur berdasarkan catatan yang benar per proses, bukan permintaan per detik. Kontrol yang berguna mencakup pemeriksaan kolom wajib, validasi tipe dan rentang, URL sumber, cap waktu pengambilan, tingkat duplikat, tingkat null yang dapat diterima, cakupan terhadap URL yang diharapkan, dan peringatan ketika distribusi kolom berubah secara tak terduga.
Kualitas crawl juga penting secara terpisah. Tetapkan batas halaman dan kedalaman yang tegas, kanonikalisasi dan hapus duplikat URL, kecualikan pola yang tidak relevan, dan jaga tingkat permintaan per domain tetap konservatif. Jika suatu pekerjaan yang diizinkan memerlukan perutean jaringan yang terdistribusi atau berbasis geografis, tambahkan proxy web scraping karena jaringan itu memang memerlukannya, bukan sekadar karena beban kerjanya disebut scraping. Jenis proxy untuk scraping harus disesuaikan dengan target dan pola lalu lintas.
Pemeriksaan kualitas data: Pengambilan yang berhasil membuktikan bahwa Anda menerima respons. Itu tidak membuktikan bahwa catatan tersebut lengkap, terkini, atau benar secara semantik.
Bagaimana Yozh Crawler dan Yozh Scraper dapat mengotomatiskan pipeline?
CyberYozh Data memisahkan proses penemuan dari ekstraksi dalam dua layanan open-source yang dapat di-hosting sendiri. Yozh Crawler memulai dari sebuah seed URL, mengelola frontier, menghapus duplikasi URL yang ditemukan, menerapkan aturan cakupan, dan mengalirkan event halaman melalui SSE. Yozh Scraper mengambil halaman, dapat merender JavaScript dengan Playwright, dan dapat mengekstrak data terstruktur dengan aturan CSS atau XPath.
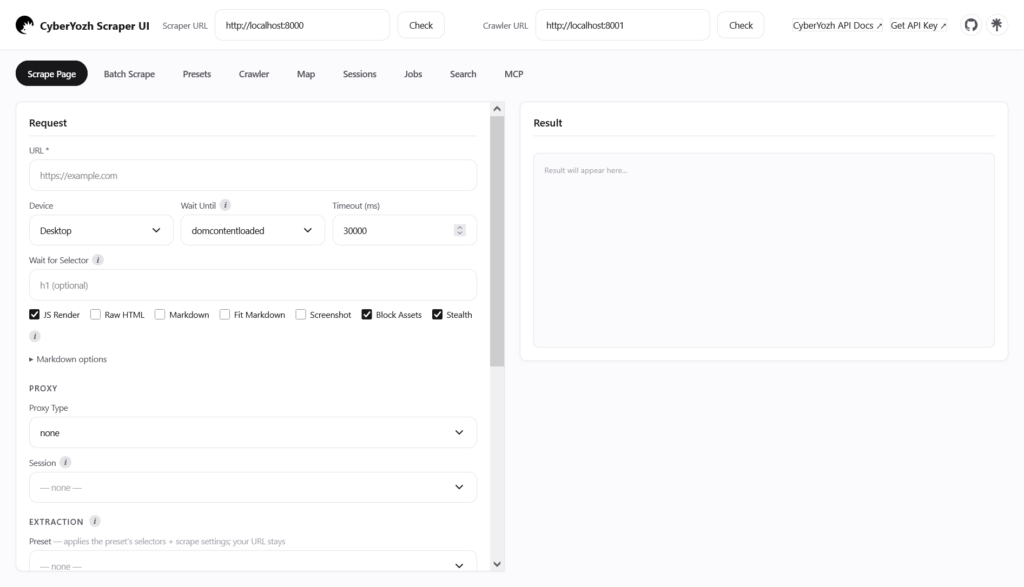
Pemisahan tersebut sesuai langsung dengan alur pengumpulan data secara umum:
Seed URL \u2192 crawl dan temukan \u2192 ambil atau render \u2192 ekstrak \u2192 validasi \u2192 simpan
Untuk sebuah crawl, kontrol seperti mode, include_patterns, exclude_patterns, max_depth, max_pages, per_domain_rps, dan per_domain_concurrency menentukan ke mana crawler boleh menjelajah dan seberapa cepat prosesnya. Untuk ekstraksi, Yozh Scraper mendukung render, wait_for_selector, extract, raw_html, dan permintaan batch melalui /api/v1/scrape/pages.
Ada batasan operasional yang perlu diperhitungkan dalam desain sistem. Yozh Crawler v1 tidak melakukan autentikasi pada endpoint-nya, jadi sebaiknya jalankan pada jaringan tepercaya atau di belakang gateway Anda sendiri. Crawl job disimpan dalam memori, bukan sebagai penyimpanan data jangka panjang, sehingga Anda perlu menyimpan stream atau hasilnya di sistem Anda sendiri. Perutean proxy bersifat opsional: pengumpulan langsung menggunakan proxy_type: none, sedangkan jenis proxy CyberYozh memerlukan CYBERYOZH_API_KEY.
Ini memang bukan pengganti database, scheduler, atau lapisan validasi Anda. Ini adalah bagian penemuan dan pengambilan/ekstraksi dari keseluruhan sistem, sehingga lebih mudah untuk mengganti penyimpanan atau orkestrasi tanpa harus menulis ulang collector-nya.
Bagaimana cara mengumpulkan data web secara bertanggung jawab?
Pengumpulan yang bertanggung jawab dimulai sebelum permintaan pertama dikirim. Pastikan data dan penggunaan yang dimaksud diizinkan, batasi pengumpulan hanya pada apa yang benar-benar dibutuhkan proyek, hindari data pribadi atau sensitif yang tidak diperlukan, dan jangan merancang crawler dengan cara yang membebani layanan target.
robots.txt adalah mekanisme standar bagi pemilik situs untuk mempublikasikan instruksi bagi crawler. Robots Exclusion Protocol menetapkan bagaimana klien otomatis harus menafsirkan aturan tersebut, dan juga menegaskan bahwa aturan robots bukanlah bentuk otorisasi akses. Dokumentasi teknis Yozh Crawler saat ini menyatakan bahwa aplikasi ini tidak secara otomatis merujuk pada robots.txt, sehingga penerapan yang bertanggung jawab harus memeriksa dan menerapkan sendiri aturan yang relevan melalui desain crawl-nya.
Kebijakan penggunaan dan kebijakan target terbatas CyberYozh Data memberikan batasan platform tambahan. Aksesibilitas teknis bukan berarti izin, dan visibilitas publik tidak menghilangkan kewajiban privasi, hak cipta, kontraktual, atau yurisdiksi tertentu.
Kesimpulan
Cara pandang yang berguna terhadap pengumpulan data web adalah dengan menganggapnya sebagai sebuah sistem data, bukan sekadar skrip scraping. Penemuan, pengambilan, ekstraksi, validasi, penyimpanan, dan pemantauan menyelesaikan masalah yang berbeda-beda, dan menjaga agar tahapan-tahapan ini tetap terpisah membuat kegagalan lebih mudah dideteksi serta pipeline lebih mudah diubah.
Mulailah dengan menentukan field dan tingkat kebaruan data yang benar-benar Anda butuhkan. Kemudian pilih metode pengumpulan paling sederhana yang dapat menyediakan data tersebut, validasi hasil yang diperoleh, dan rancang proses berikutnya sebelum Anda memperbesar skala proses pertama.
Pertanyaan yang sering diajukan tentang pengumpulan data web
Pertanyaan-pertanyaan ini mencakup istilah pencarian yang tersisa tanpa mengubah pertanyaan umum tentang metodologi riset menjadi saran web scraping. Fokusnya tetap pada cara memperoleh informasi dari situs web dan mengubahnya menjadi data yang dapat digunakan.
Apa itu data web?
Data web adalah informasi yang tersedia melalui situs web, aplikasi web, API, feed, file, atau sumber lain yang dapat diakses melalui internet. Data ini dapat mencakup teks, harga, atribut produk, ulasan publik, lowongan kerja, hasil pencarian, tanggal, tautan, gambar, dan metadata terstruktur.
Apakah pengumpulan data web sama dengan web scraping?
Tidak. Web scraping biasanya merupakan tahap pengambilan dan ekstraksi, sedangkan pengumpulan data web juga mencakup pemilihan sumber, penemuan halaman, validasi, penyimpanan, pembaruan, dan pemantauan. Dengan demikian, scraping dapat menjadi salah satu komponen dari sistem pengumpulan yang lebih besar.
Bisakah AI mengotomatiskan ekstraksi data web?
AI dapat membantu menyimpulkan field, menghasilkan aturan ekstraksi, menormalkan konten yang tidak konsisten, atau memulihkan proses setelah perubahan tata letak. Namun, AI tetap harus dibatasi oleh sebuah skema dan diperiksa terhadap sumbernya, karena keluaran yang tampak masuk akal tidak sama dengan keluaran yang telah diverifikasi.
Apakah saya memerlukan proxy untuk pengumpulan data web otomatis?
Tidak selalu. Banyak sumber publik atau kooperatif dapat dikumpulkan secara langsung, terutama pada tingkat permintaan yang wajar. Proxy menjadi relevan ketika sebuah alur kerja yang sah memiliki kebutuhan khusus terkait perutean jaringan atau lokasi geografis, dan proxy sebaiknya digunakan karena alasan tersebut, bukan sebagai pilihan default.